

Python Pandas DataFrame 行列求和及新增行列操作详解
本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
2026-10-13
7

本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
本文详细介绍pandas中DataFrame.fillna()函数的具体用法。涵盖value、method、axis、inplace及limit等核心参数的配置,通过标量、字典填充及ffill/bfill前后向填充的实例,演示如何处理数据中的NaN值,帮助开发者高效完成数据清洗任务。
本文介绍在pandas中修改DataFrame列名的两种主要方法:直接重新赋值columns属性和使用rename方法。重点解析rename方法中inplace参数的作用,演示未使用与使用该参数时的结果差异,并展示如何指定修改特定列名。
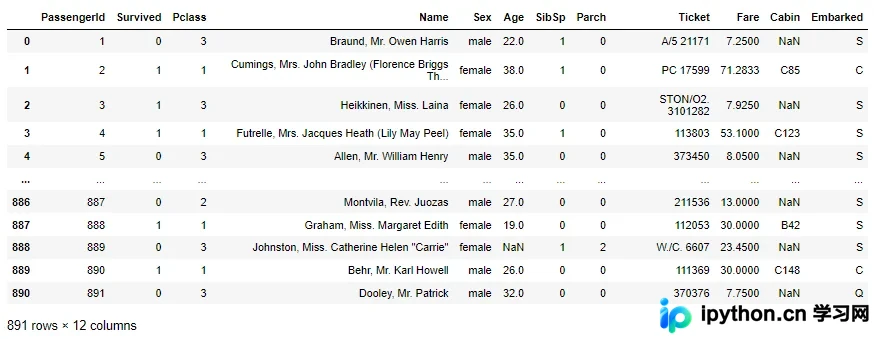
本文深入解析Pandas库中的query()方法,通过Titanic数据集演示如何替代传统的方括号索引进行更简洁的数据筛选。涵盖字符串匹配、变量引用、多条件组合、缺失值处理、索引查询及列间比较等核心用法,帮助开发者提升数据处理效率。
本文详细解析Python Pandas中DataFrame的索引机制,涵盖行索引与列索引的定义及自定义方法。重点介绍通过方括号、.loc()及.iloc()进行单列、多列及特定行数据的选取技巧,区分Series与DataFrame返回类型,帮助开发者高效处理表格数据。
本文介绍如何在pandas中提取Timestamp对象的日期部分,以及处理非数值日期属性的方法。通过调用.date()获取纯日期,或将字符串类型的日期列拆分为年、月、日单独列,以便直接输入机器学习模型进行数据挖掘。
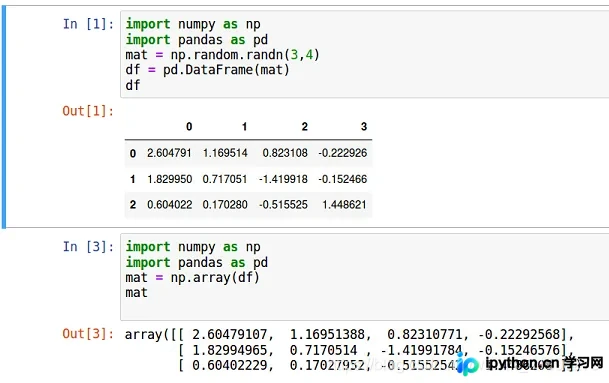
本文介绍Python中NumPy数组与Pandas DataFrame之间的相互转换方法。内容包括将NumPy数组转换为DataFrame,以及将DataFrame转换为NumPy数组的三种常用方式:values方法、as_matrix()方法和np.array()函数,帮助开发者在数据分析时灵活处理两种数据结构。
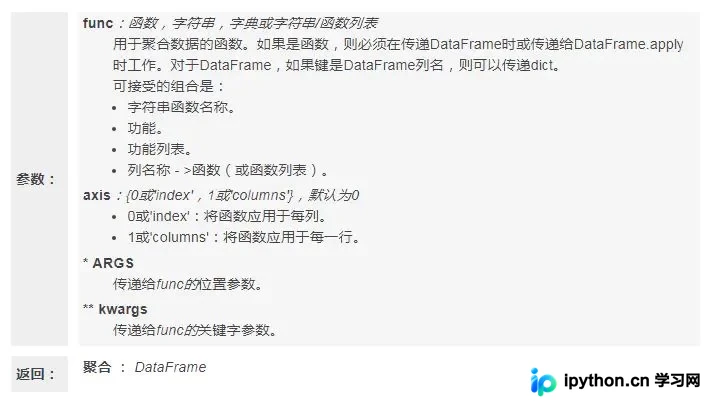
本文详细介绍pandas中DataFrame.agg()聚合函数的使用方法。通过对比numpy聚合函数,解析func参数的多种格式(函数、列表、字典),并演示如何在指定轴上执行单个或不同列的多重聚合操作,包括处理NaN填充的逻辑。
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
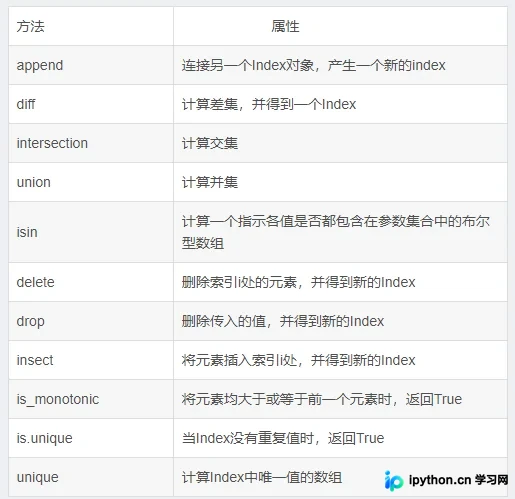
本文深入解析 Python Pandas 库中的三大核心数据结构:Series、DataFrame 和 Panel。详细讲解 Series 的一维数组特性、索引与标签的双重访问机制,以及基于字典和列表的创建方法。同时阐述 DataFrame 的表格型结构、列对齐与缺失值处理,并介绍 Index 对象的不可变性与常用属性查看方法,帮助开发者掌握 Pandas 数据处理基础。
本文详细介绍在pandas DataFrame中批量修改数据的四种常用方法。通过iloc进行行列定位赋值,利用where和mask函数根据条件替换数值,以及使用replace函数处理文本、字典映射及正则表达式。涵盖具体代码示例与参数说明,帮助开发者高效完成数据清洗与预处理任务。
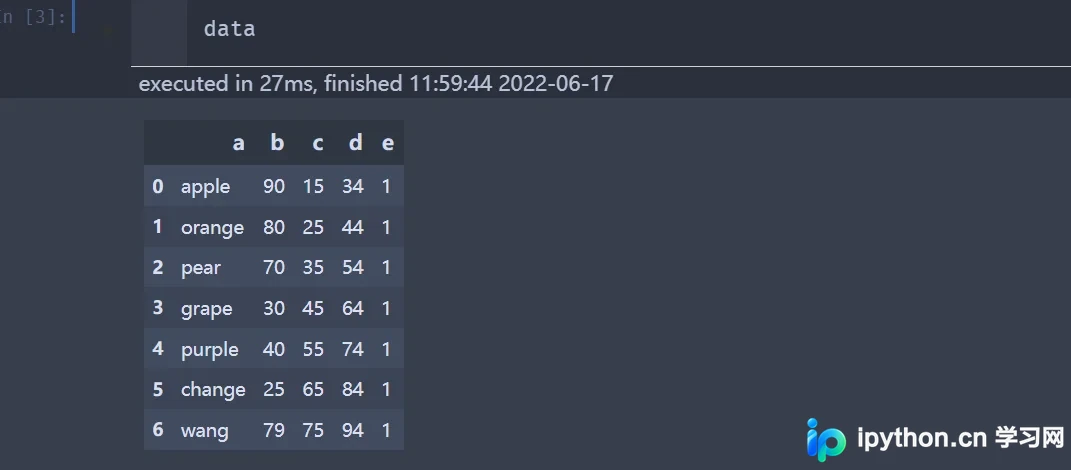
本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。