

pandas DataFrame检测重复值与去重方法详解

发布时间:2026-10-14| 3人浏览过
本文详细介绍pandas中DataFrame检测重复值的方法,包括duplicated函数的subset、keep参数用法及示例,以及如何通过布尔索引查询和统计重复记录个数。
pandas DataFrame检测重复值概述
本文详细介绍如何利用pandas查看DataFrame中的重复数据,判断数据是否重复,以及如何执行去重操作。
DataFrame.duplicated(subset=None, keep='first')duplicated函数参数详解
subset参数:若指定某些字段作为判断重复的依据,需将这些字段以列表形式传入subset参数。默认情况下,所有字段完全一致才被视为重复数据。
keep参数:
- 默认值为'first'。当存在重复数据时,第一条出现的记录标记为False,后续重复的记录标记为True。
- 若设置为'last',当存在重复数据时,最后一条出现的记录标记为False,其前序重复记录标记为True。
- 若设置为False,则所有重复的记录均标记为True。
重复值检测示例
以下通过具体示例进行说明。
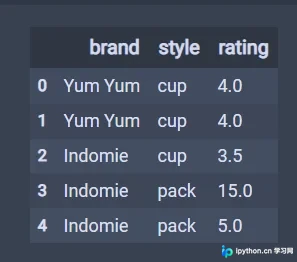
df = pd.DataFrame({
    'brand': ['Yum Yum', 'Yum Yum', 'Indomie', 'Indomie', 'Indomie'],
    'style': ['cup', 'cup', 'cup', 'pack', 'pack'],
    'rating': [4, 4, 3.5, 15, 5]
})
df
# 默认为keep="first",第一条重复的为False,后面重复的为True
# 一般不会设置keep,保持keep为默认值。
df.duplicated()

结果
0    False
1     True
2    False
3    False
4    False
dtype: bool

# keep="last",,最后一条重复的为False,后面重复的为True
df.duplicated(keep="last")

结果
0     True
1    False
2    False
3    False
4    False
dtype: bool

# keep=False,,所有重复的为True
df.duplicated(keep=False)

结果
0     True
1     True
2    False
3    False
4    False
dtype: bool

# sub是子,subset是子集
# 标记只要brand重复为重复值。
df.duplicated(subset='brand')

结果

0    False
1     True
2    False
3     True
4     True
dtype: bool


# 只要brand重复brand和style重复的为重复值。
df.duplicated(subset=['brand','style'])

结果

0    False
1     True
2    False
3    False
4     True
dtype: bool


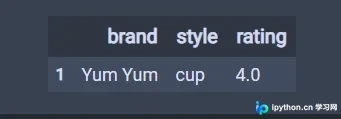
# 显示重复记录,通过布尔索引
df[df.duplicated()]
# 查询重复值的个数。
df.duplicated().sum()

结果
1
总结
至此,关于pandas中DataFrame检测重复值的实现介绍完毕。如需了解更多相关pandas DataFrame检测重复值的内容,请搜索本站历史文章或继续浏览后续相关文章。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









