

使用Python快速搭建桌面端多格式文件预览工具
本文详解如何利用Python集成wxPython、PyMuPDF与pandas等库,打造一款桌面级文档预览管理器。通过内置的路径遍历、24小时时效筛选机制以及针对图片、PDF、Word和Excel的分流渲染方案,实现分页浏览、勾选管理与快捷导出,大幅提升日常资料审查效率。
2026-10-11
6

本文详解如何利用Python集成wxPython、PyMuPDF与pandas等库,打造一款桌面级文档预览管理器。通过内置的路径遍历、24小时时效筛选机制以及针对图片、PDF、Word和Excel的分流渲染方案,实现分页浏览、勾选管理与快捷导出,大幅提升日常资料审查效率。
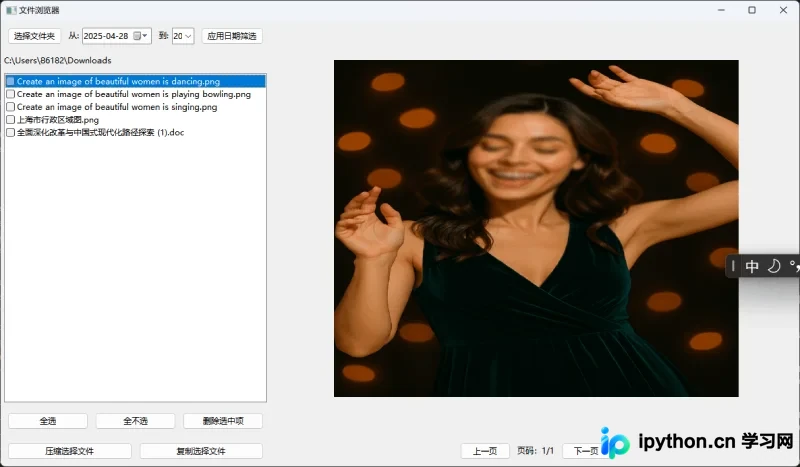
本文详细演示如何在Python桌面端应用中实现文件浏览器的核心模块,涵盖目录智能分层遍历、文件列表过滤加载,以及针对.docx、.doc和.xlsx格式的文本级内容预览。通过策略模式分发与多维度降级处理,确保多格式文档安全读取与结构化展示,附带完整可运行代码与性能优化建议。
介绍如何利用Python及pandas、openpyxl等第三方库,快速实现Excel合并筛选、Word模板填充、PDF拆分提取及批量邮件发送。附带环境配置命令与核心代码片段,帮助职场人员告别机械重复操作,提升日常办公效率。
本文汇总15个高频Python自动化办公脚本,覆盖文件批量整理、表格数据转换、PDF内容提取及图片格式缩放等场景。提供从环境配置到完整代码的运行方案,替代手动重复操作,帮助职场人员快速提升日常数据处理效率。
本文详解Pandas库处理时间序列数据的三大核心工具:滑动窗口用于捕捉局部动态,重采样用于调整时间粒度,趋势分析用于揭示长期走向。通过实际案例展示如何用简洁代码快速定位异常波动、转换数据频率并建立预测模型,助力物联网、金融和智能制造等领域的高效数据分析。
面对非标准时间字符串与海量交易记录,Pandas提供了一套从类型转换、频率重采样到向量化计算的完整方案。本文梳理了Timestamp与Period的应用场景、date_range参数组合、升降采样逻辑及滚动窗口用法,并附带股票周线生成案例与时区冲突排错指南,帮助开发者建立基于时间索引的高效数据处理流程。
本文介绍Python中表格存取的方法,包括xlwt/xlrd、openpyxl和pandas库的使用。xlwt/xlrd适用于Excel文件,openpyxl支持.xlsx格式,pandas适合CSV文件处理。不同库原理相同,但写法有差异,建议无格式要求时存储为CSV文件。
本文详解利用Python进行数据清洗与预处理的完整工作流。通过Pandas实现CSV/Excel数据加载、缺失值智能填充、重复行过滤、基于IQR的异常值检测与截断、类型转换以及Z-score与MinMax特征缩放。结合鸢尾花数据集提供可直接运行的端到端脚本与结果验证,助力开发者快速搭建高质量的机器学习数据输入管道。
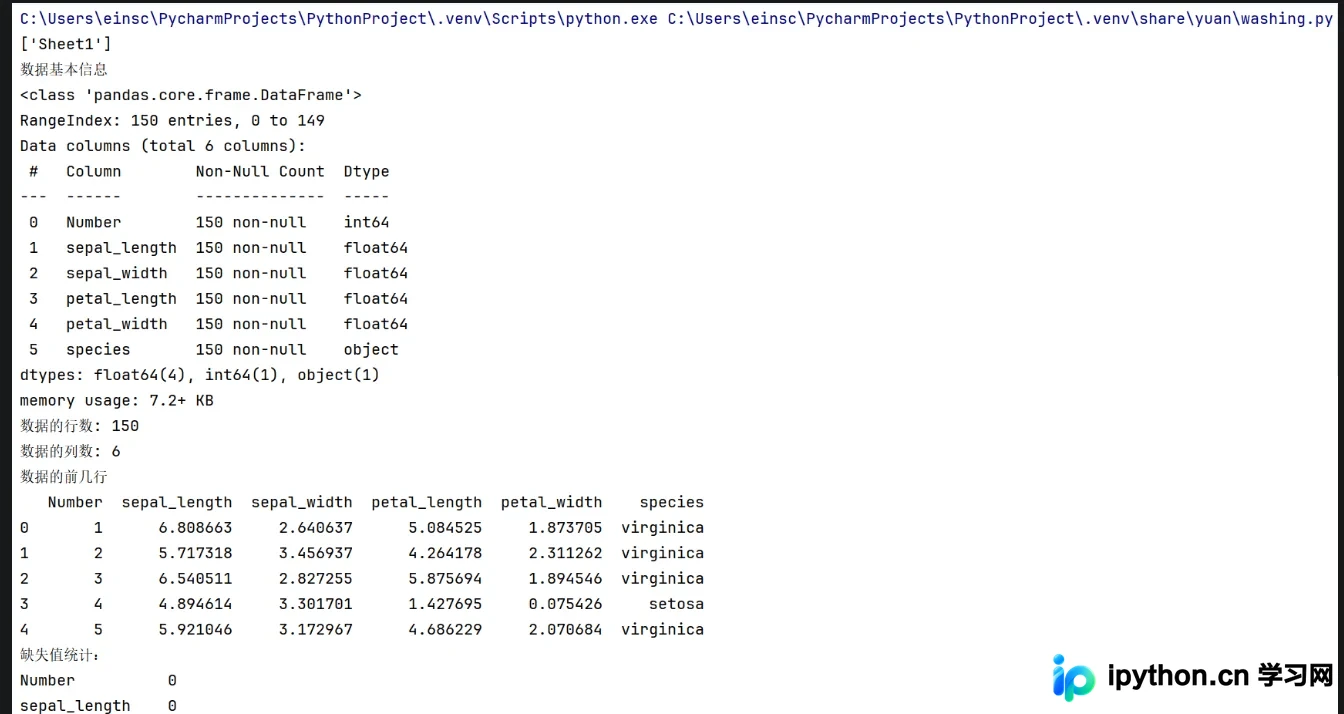
本文系统梳理 Python Pandas 库的结构化数据处理全流程,涵盖 DataFrame 构建、CSV 读写与探查、位置/标签/布尔索引、GroupBy 分组聚合、多表连接与透视表、时间序列解析,以及分块读取与类型转换等性能优化方案。结合可运行代码与预期输出对照,帮助开发者快速掌握数据清洗、转换与分析的核心操作。
本文详解pandas中Timestamp类的两种核心创建方式:直接构造与to_datetime()转换。通过具体代码示例,展示如何从整数、datetime对象及字符串生成Timestamp,并验证其类型与输出格式,帮助开发者高效处理时间序列数据。
数据质量直接决定分析结论的可靠性。本文系统梳理Python数据分析中12项核心清洗技术,覆盖缺失值处理、重复值过滤、类型转换、异常值拦截、量纲标准化、表结构合并、时空字段解析及分类编码等高频场景。结合Pandas与scikit-learn提供可运行代码与完成状态验证方法,助您快速搭建标准化数据预处理流水线。
针对企业报表中常遇到的.xls与.xlsx混用、表头偏移及多余序号列等问题,本文提供基于Python、Pandas与openpyxl/xlrd的自动化合并方案。通过封装通用读取函数支持动态跳行跳列,利用索引映射实现姓名精准匹配,并按业务需求将新字段定点插入指定位置。全程无需人工复制粘贴,大幅降低数据清洗成本。