

Python数据清洗与预处理实战指南

本文详解利用Python进行数据清洗与预处理的完整工作流。通过Pandas实现CSV/Excel数据加载、缺失值智能填充、重复行过滤、基于IQR的异常值检测与截断、类型转换以及Z-score与MinMax特征缩放。结合鸢尾花数据集提供可直接运行的端到端脚本与结果验证,助力开发者快速搭建高质量的机器学习数据输入管道。
数据清洗与预处理的标准流程
准备条件:基础库导入与显示配置
在使用Pandas进行结构化数据处理前,需统一全局显示参数以避免中文乱码与输出截断。以下脚本导入核心计算与可视化库,并配置终端输出宽度:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

plt.rcParams["font.family"] = ["SimHei", "WenQuanYi Micro Hei", "Heiti TC"]
pd.set_option('display.max_columns', None)
pd.set_option('display.width', 1000)
第1步:读取源文件并探索数据基线
目的:确认数据规模、字段类型与初始分布,避免后续操作在错误数据结构上执行。
入口与动作:通过pd.read_csv()或pd.ExcelFile().parse()加载文件。CSV支持自定义sep分隔符与na_values缺失标识;Excel多工作表需指定sheet_name。
重要参数:header定义表头行索引,usecols按列过滤。
完成状态:执行df.info()查看非空计数与内存占用,df.head()核对样本形态,df.describe()获取数值型分位数摘要,类别列通过value_counts()明确取值映射关系。
# 从CSV文件加载数据
df = pd.read_csv('data.csv')

# 从Excel文件加载数据(支持多工作表)
excel_file = pd.ExcelFile('data.xlsx')
df = excel_file.parse('Sheet1')

print(f"数据集规模:{df.shape[0]}行,{df.shape[1]}列")
第2步:统计并处理缺失值
目的:消除NaN导致的模型计算中断或偏差。
入口与动作:使用df.isnull().sum()定位缺失比例,按数据类型选择策略。
重要参数:dropna(axis=0/how='any')适用于缺失率极低(<1%)的场景;fillna()支持传入统计量或字典映射。时间序列建议使用滚动窗口填充而非全局均值。
完成状态:再次调用df.isnull().sum()全列返回0,且原始数据分布未因极端填充发生剧烈偏移。
missing_count = df.isnull().sum()
missing_df = pd.DataFrame({'缺失值数量': missing_count, '缺失比例': missing_count / len(df)})
print(missing_df[missing_df['缺失值数量'] > 0])

# 数值列用中位数抗噪填充,类别列用众数覆盖
df['数值列'] = df['数值列'].fillna(df['数值列'].median())
df['类别列'] = df['类别列'].fillna(df['类别列'].mode()[0])
第3步:定位并移除重复记录
目的:防止同一观测被模型多次权重放大。
入口与动作:df.duplicated()返回布尔Series标记冗余行。指定subset=['col1','col2']可按业务主键判定重复。
重要参数:keep='first'/'last'控制保留首尾实例,keep=False清除全部副本。
完成状态:df.drop_duplicates()返回新DataFrame,其行数与原数据差值等于duplicated().sum()。
duplicate_rows = df.duplicated()
print(f"重复行数量:{duplicate_rows.sum()}")
df_clean = df.drop_duplicates(keep='first')
print(f"清理后行数:{df_clean.shape[0]}")
第4步:识别与裁剪数值型异常值
目的:隔离传感器漂移或录入错误引发的离群点。
入口与动作:绘制箱线图初步观察,随后采用IQR(四分位距)法严格划定边界:IQR = Q3 - Q1,阈值设为[Q1-1.5*IQR, Q3+1.5*IQR]。
重要参数:剔除仅适用于确信为脏数据的场景;推荐df.clip(lower_bound, upper_bound)进行截断保护,避免破坏连续分布。
完成状态:截断后重新计算describe(),极值区间收紧,箱线图须线外无散点。
def detect_and_clip_outliers(df, col):
    Q1, Q3 = df[col].quantile(0.25), df[col].quantile(0.75)
    IQR = Q3 - Q1
    return df[col].clip(Q1 - 1.5 * IQR, Q3 + 1.5 * IQR)

for col in df.select_dtypes(include=np.number).columns:
    df[col] = detect_and_clip_outliers(df, col)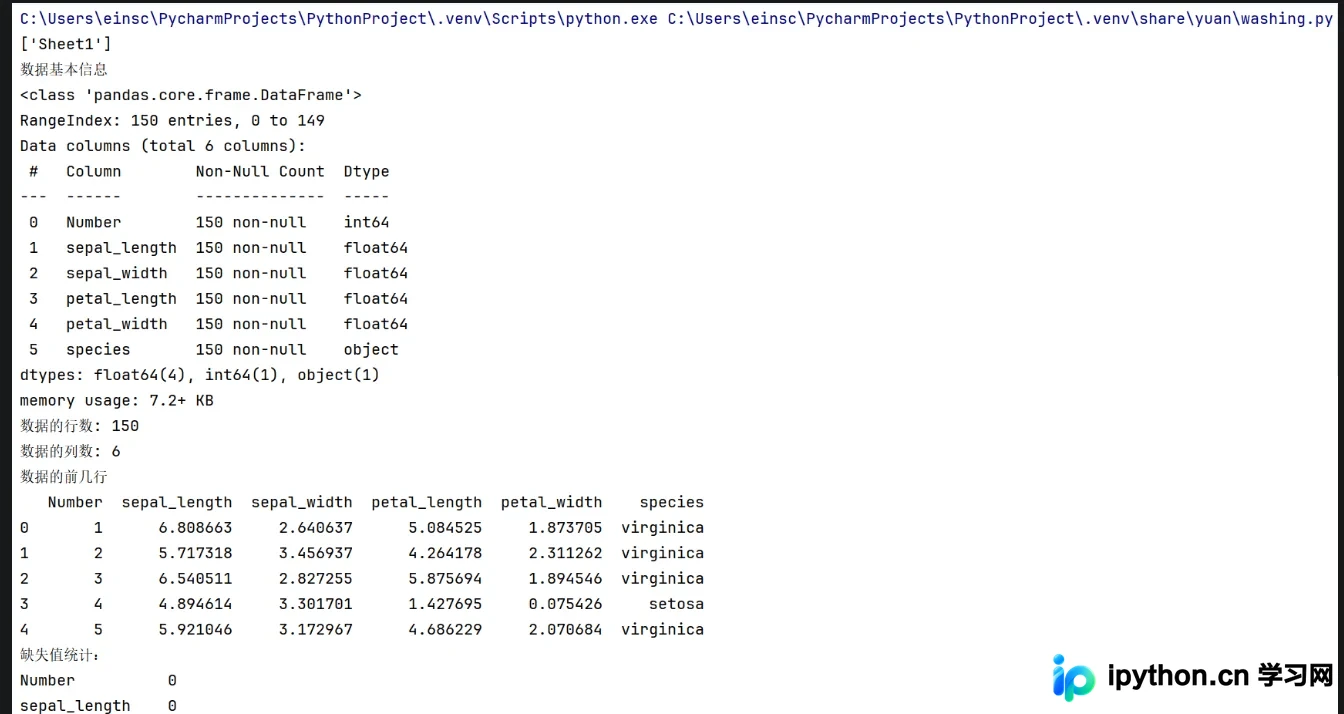
第5步:统一数据类型与特征缩放
目的:确保时序解析正确性,并将不同量纲特征对齐至相似尺度,加速梯度下降收敛。
入口与动作:pd.to_numeric(errors='coerce')强制清洗非数字字符;pd.to_datetime(format=)按固定模板解析日期;.astype('category')降低高频字符串内存开销。
重要参数:模型训练前调用StandardScaler()(Z-score)处理近似正态分布特征,或MinMaxScaler()将范围压缩至[0,1]。
完成状态:dtypes列全匹配预期类别;缩放后各特征均值为0±0.01,标准差趋近1(或限定区间内)。
from sklearn.preprocessing import StandardScaler, MinMaxScaler

numeric_cols = df.select_dtypes(include=np.number).columns
scaler = MinMaxScaler()
df[numeric_cols] = scaler.fit_transform(df[numeric_cols])
print(df[numeric_cols].describe())
完整实战:鸢尾花数据集清洗演示
以下为整合上述步骤的端到端脚本。流程涵盖加载、统计诊断、缺失/重复/异常值处理、类型校准与导出。注意将变量路径替换为实际项目目录:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

pd.set_option('display.max_columns', None)

# 读取数据
file_path = r'data/iris_dataset.xlsx'
sheet_names = pd.ExcelFile(file_path).sheet_names
df = pd.ExcelFile(file_path).parse(sheet_names[0])

print("原始信息:"); print(df.info()); print(df.head())

# 1. 缺失值填充
for col in df.columns:
    if df[col].dtype == 'object':
        df[col] = df[col].fillna(df[col].mode()[0])
    else:
        df[col] = df[col].fillna(df[col].mean())

# 2. 删除重复值
df = df.drop_duplicates().reset_index(drop=True)

# 3. IQR异常值过滤
num_cols = df.select_dtypes(include=[np.number]).columns
for col in num_cols:
    Q1, Q3 = df[col].quantile(0.25), df[col].quantile(0.75)
    IQR = Q3 - Q1
    mask = (df[col] <= Q3 + 1.5 * IQR) & (df[col] >= Q1 - 1.5 * IQR)
    df = df[mask]

df = df.reset_index(drop=True)
print("\n清洗后信息:"); print(df.info()); print(f"剩余行数:{df.shape[0]}")

# 保存结果
output_path = r'data/iris_dataset_cleaned.xlsx'
df.to_excel(output_path, index=False, sheet_name='CleanedData')
print(f"已保存至 {output_path}")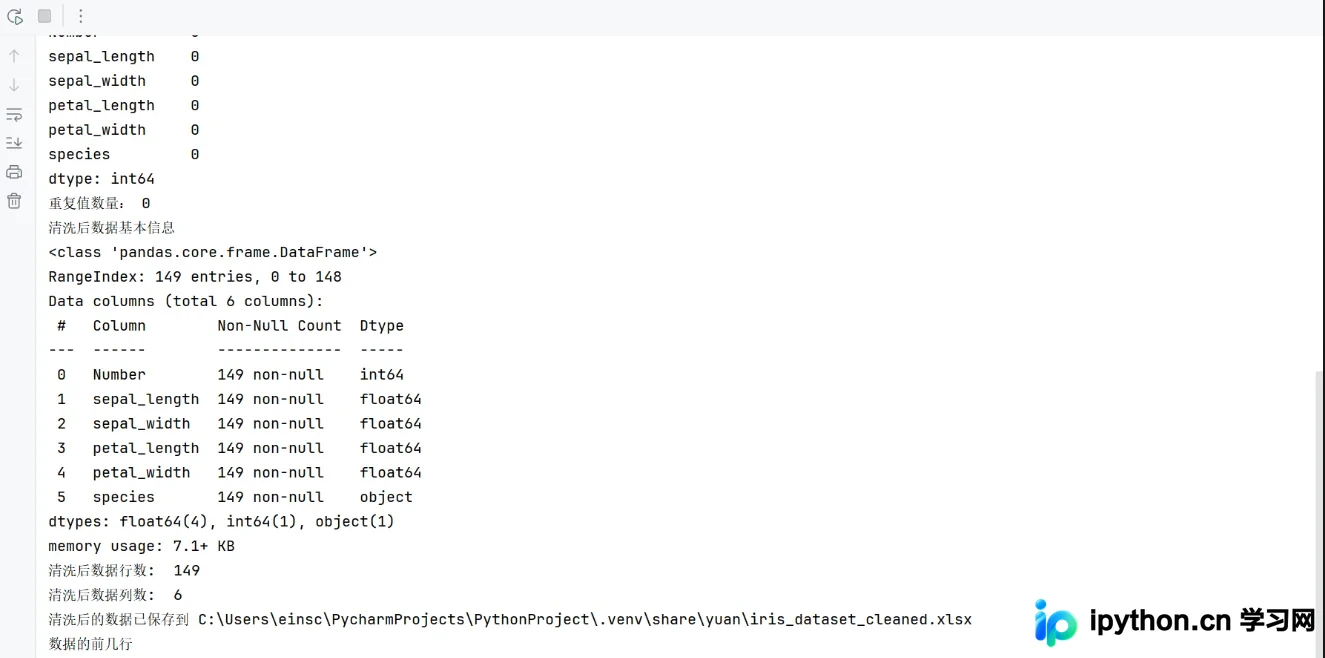
关键问题排查
ValueError: Could not convert string to float:检查to_numeric()是否遗漏了带单位后缀(如"10kg")的文本,需先剥离单位或配置errors='coerce'转为NaN再处理。UserWarning: Method .pad is deprecated...:新版Pandas已弃用fillna(method='ffill'),请替换为链式调用df.ffill()或df.bfill()。SettingWithCopyWarning:链式赋值引发视图引用歧义时,显式使用df.loc[:, 'col'] = ...或在筛选阶段追加.copy()。
总结
以上就是Python数据清洗与预处理技巧分享的详细内容,更多关于Python数据分析与机器学习的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









