

pandas读取HTML表格与JSON数据的完整指南
在使用Python进行数据分析时,经常需要从网页或配置文件中提取结构化内容。本文详细演示如何利用pandas库直接读取HTML网页表格与JSON文件数据,涵盖基础导入、数据清洗(去空值/类型转换)、统计分析方法,以及处理读取JSON时常见的“Trailing data”报错修复方案,助你快速完成数据获取与预处理工作。
2026-10-11
6

在使用Python进行数据分析时,经常需要从网页或配置文件中提取结构化内容。本文详细演示如何利用pandas库直接读取HTML网页表格与JSON文件数据,涵盖基础导入、数据清洗(去空值/类型转换)、统计分析方法,以及处理读取JSON时常见的“Trailing data”报错修复方案,助你快速完成数据获取与预处理工作。
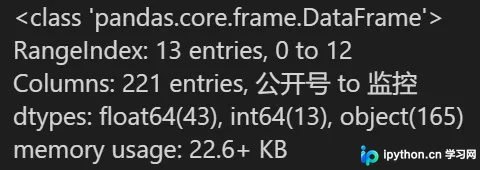
在使用Pandas进行数据探索时,常规调用info()仅显示基础摘要。通过配置verbose与null_counts参数可快速预览列数据类型与缺失数量;结合io模块的StringIO对象重定向buf参数,能将其直接转为字符串变量存储,避免控制台重复打印,大幅提升数据探查与日志记录的效率。
本文详解Pandas修改特定值的四种核心方法。通过对比Series的map与DataFrame的apply映射机制,演示带参函数与多列运算;结合loc按条件精准替换,以及fillna智能填充缺失值。附带完整代码示例与参数说明,助您高效完成表格数据清洗与字段转换。
本文深入解析Pandas中的聚合与分组运算。通过groupby实现数据分组,利用内置函数(如sum、mean)进行快速统计,并掌握使用agg()执行自定义聚合逻辑。文章还演示了多函数应用、列级指定运算、结果前缀添加,以及merge与transform在数据对齐与合并中的具体操作。
本文介绍如何使用 Python 的 Camelot 库从 PDF 文件中高效提取表格数据。通过简单的几行代码,即可将 PDF 表格转换为 Pandas DataFrame,并支持导出为 CSV、Excel 等多种格式。文章涵盖安装方法及核心 API 使用示例,帮助开发者快速处理文档数据。
本文介绍使用Python遍历指定目录并自动识别扩展名,分别调用python-docx与pandas库提取TXT、DOCX及Excel文件内容的完整流程。通过封装读取函数与条件分支,可快速实现多格式办公文档的内容抓取与结构化输出,适用于资料汇总与数据预处理场景。
本文介绍如何使用 Python Pandas 处理数据集中的时间信息。通过 pd.to_datetime 将字符串转换为标准日期格式,利用 datetime 对象计算时间差,并提取具体的天数信息。文章涵盖日期格式解析、时间差计算及属性访问方法,帮助开发者高效处理时间序列数据。
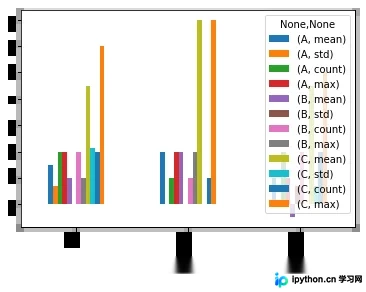
本文详解 Pandas 中 groupby() 函数的核心用法,涵盖按字典或列分组、apply 与 agg 的区别、多函数聚合及可视化。重点解析多级索引(MultiIndex)的透视表形式、使用 xs() 选取特定索引以及通过 reset_index() 恢复常规 DataFrame 结构的完整操作流程。
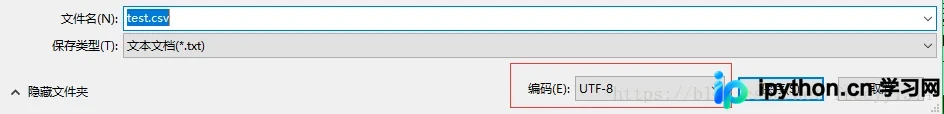
在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
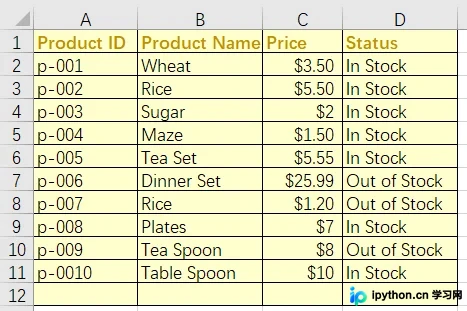
本文详细介绍在Python中将老旧的.xls文件格式转换为现代.xlsx格式的4种常用方法。通过pandas、win32com、xls2xlsx及pyexcel模块,分别演示安装步骤、核心代码与适用场景。读者可根据是否依赖Windows系统、是否需要保留单元格格式等实际需求,选择最合适的脚本方案快速完成批量转换。
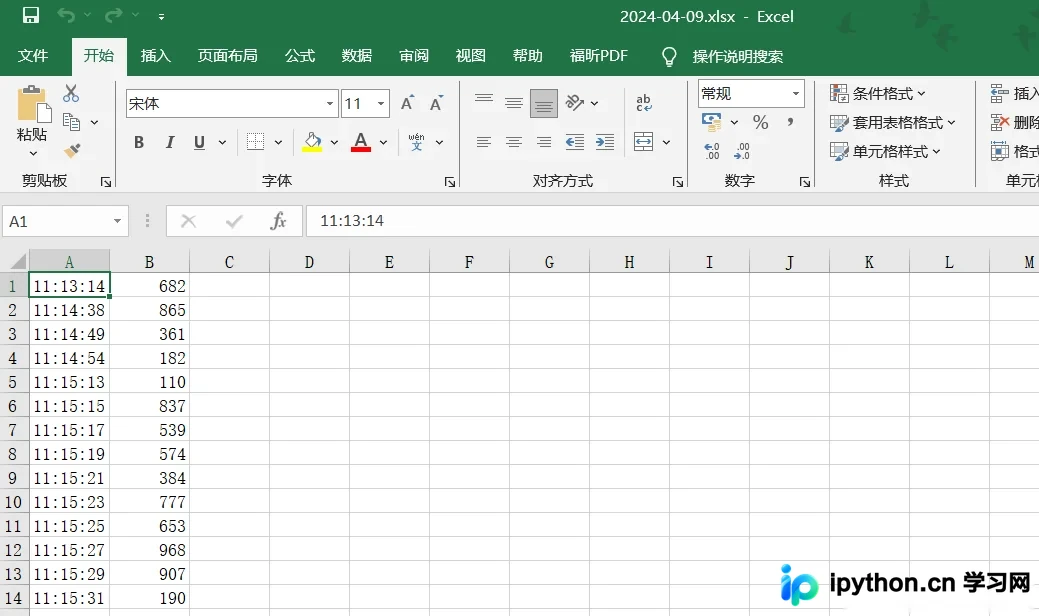
本文详解如何使用Python的openpyxl库高效读写.xlsx格式文件。涵盖环境安装、工作簿加载、单单元格读写、整行遍历、增量数据写入及避免覆盖原文件的保存技巧,并提供实时记录数据的实战代码示例,助你快速掌握Python表格数据处理流程。
该报错通常在Pandas尝试将含重复索引的数据映射至唯一新索引时触发。可通过保留首条记录的去重操作、重置默认索引或对重复项进行分组聚合来彻底消除冲突,并在执行reindex前利用index.is_unique进行校验,确保后续数据处理流程顺畅。