

如何在Python中使用openpyxl库读写.xlsx文件

详细讲解如何利用Python的openpyxl模块完成.xlsx文件的读取、写入与更新操作。内容包含基础API调用、安全保存策略、防覆盖写入逻辑以及定时追加数据的完整实现方案,附带可直接运行的代码片段与关键参数说明。
环境准备与模块说明
在使用 openpyxl 之前,需通过包管理工具安装对应版本。该库专为 .xlsx(Excel 2007及以上)设计,提供对工作簿、工作表及单元格的底层控制能力,适合需要精细排版、保留公式或样式的数据处理场景。
pip install openpyxl若仅需进行大规模行列转换或统计计算,可结合 pandas 提升性能;若需处理旧版 .xls 格式,则应改用 xlrd 与 xlwt。
读取工作表与定位单元格
打开现有表格后,可通过 load_workbook() 获取工作簿对象。默认会激活第一个工作表(通常命名为 Sheet),也可通过名称精准切换目标区域。
import openpyxl

# 加载指定路径的工作簿
wb = openpyxl.load_workbook('example.xlsx')

# 获取活动工作表,或通过索引/名称定位
ws = wb.active  # 等价于 wb[wb.sheetnames[0]]
# ws = wb['报表数据']  # 按名称切换

# 读取指定坐标单元格值
val_a1 = ws['A1'].value
print(val_a1)

# 按行列索引读取(序号从1开始)
val_cell = ws.cell(row=2, column=2).value
批量提取行列数据时,推荐使用 iter_rows() 配合 values_only=True 参数,该方法跳过对象包装直接返回元组,内存占用更低且执行速度更快。
# 逐行打印所有单元格的原始值
for row in ws.iter_rows(values_only=True):
    print(row)
写入数据与安全保存机制
新建文件需实例化 Workbook 类。写入操作支持坐标赋值或 cell() 方法,修改完成后必须调用 save() 持久化到磁盘。
from openpyxl import Workbook

wb = Workbook()
ws = wb.active

# 写入数据
ws['A1'] = '项目名称'
ws.cell(row=1, column=2, value='已完成')

# 保存至新文件(不会自动创建文件夹,需确保父目录存在)
wb.save('output.xlsx')workbook.save('existing_file.xlsx') 会直接覆盖源文件。执行前务必备份原始数据,或先另存为新路径确认无误后再替换。实战应用:增量记录与动态文件名生成
在实际监控或日志采集场景中,通常需要以日期命名文件,并在已有数据末尾追加新行,避免重新写入导致历史数据丢失。以下示例展示如何结合 time 与 os 模块实现定时采样写入:
import openpyxl
import time
import os
import random

# 生成当日文件名
file_name = f'{time.strftime("%Y-%m-%d")}.xlsx'

if os.path.exists(file_name):
    print(f'发现已存在的 {file_name}')
    wb = openpyxl.load_workbook(file_name)
else:
    print(f'当前目录无文件,创建新表')
    wb = openpyxl.Workbook()

ws = wb.active

# 利用AA1单元格作为游标标记下一写入行(避免频繁扫描空行)
cursor_cell = ws['AA1']
start_row = int(cursor_cell.value) + 1 if cursor_cell.value else 1

try:
    while True:
        ts = time.strftime('%H:%M:%S')
        data_val = random.randint(1, 999)

        # 追加记录
        ws.cell(row=start_row, column=1, value=ts)
        ws.cell(row=start_row, column=2, value=data_val)

        # 更新游标并立即落盘
        ws['AA1'].value = start_row
        wb.save(file_name)

        start_row += 1
        time.sleep(2)

        # 预览最近5条记录
        recent = [f'{ws[f"A{i}"].value}-{ws[f"B{i}"].value}' for i in range(start_row-5, start_row)]
        print(recent)
except KeyboardInterrupt:
    print('\n程序手动终止,数据已保存。')
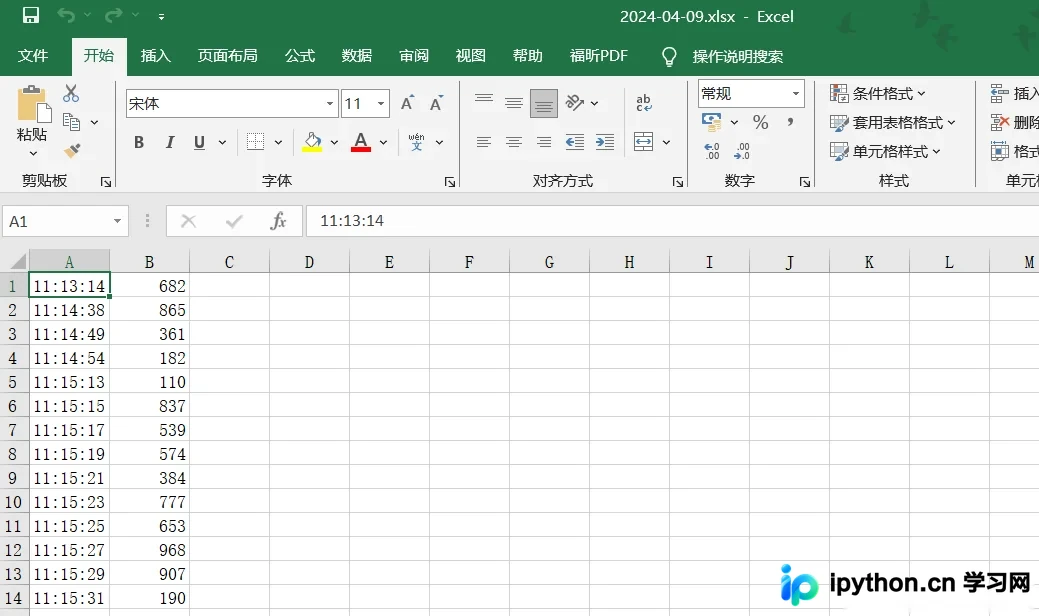
执行上述脚本后,当前运行目录会生成以当天日期命名的 Excel 表格,每隔两秒自动追加一行时间与随机观测值。运行状态与最终生成的表格结构如下:
性能优化与常见陷阱
- 空值判断:未赋值的单元格
ws['A1'].value返回None,循环清洗数据时需做好类型转换与过滤。 - 大文件压力:
openpyxl会将整个文件加载至内存,处理超过10万行的表格时易触发内存溢出,此时应切换到pandas.read_excel()或使用openpyxl.utils.iter_columns模式。 - 样式与公式:本库可完整保留字体、边框、颜色及内部函数。写入时若需复制样式,可使用
copy.copy(ws['A1'])进行单元格属性迁移。
总结
掌握 openpyxl 的核心在于理解工作簿层级关系与安全写入流程。通过灵活组合加载、定位、迭代与游标控制,即可稳定支撑日常报表自动化、日志采集与批量填充任务。以上就是在Python中使用openpyxl库读写.xlsx文件的详细内容,更多关于Python办公自动化与表格数据处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









