Python高效读取CSV指定行:skiprows与nrows参数详解
本文介绍如何利用Pandas的skiprows和nrows参数高效读取CSV文件中特定范围的行,避免全量加载导致内存溢出。同时提供根据列值筛选并获取对应索引的方法,适用于大规模数据处理场景。
2026-10-12
6

本文介绍如何利用Pandas的skiprows和nrows参数高效读取CSV文件中特定范围的行,避免全量加载导致内存溢出。同时提供根据列值筛选并获取对应索引的方法,适用于大规模数据处理场景。
本文详细介绍Pandas库中fillna方法处理缺失数据的多种策略。涵盖使用常数或字典填充、通过inplace直接修改原数据、利用method参数进行前后向填充,以及控制limit和axis限制填充范围与方向。适合需要掌握数据预处理技能的开发者参考。
本文详细介绍如何利用Python pandas库中的date_range函数生成指定频率的时间序列索引。通过设置start、end、periods及freq参数,可轻松创建日、小时、特定间隔甚至不规则频率(如每月第一个工作日)的DatetimeIndex,适用于数据清洗与时间序列分析场景。
本文介绍如何使用Python将多个结构一致的Excel文件进行横向合并。通过读取第一列作为索引,利用glob获取文件列表,并结合pandas与xlrd库提取数据,最终将所有工作表按列拼接为一个新文件。适用于月度数据分析等场景,提供完整代码示例及注意事项。
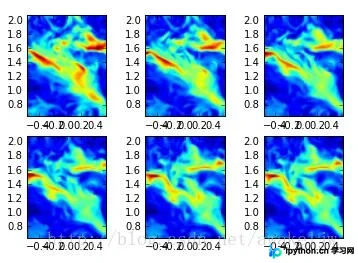
本文详解利用Python进行批量文件处理及科学计算的方法。通过os模块实现DAT文件批量转换为逗号分隔的CSV格式,确保数据可读性。结合Numpy、Pandas进行数据提取与处理,并使用Matplotlib进行多维数据可视化绘图,展示Python在科学计算领域的强大功能与便捷性。
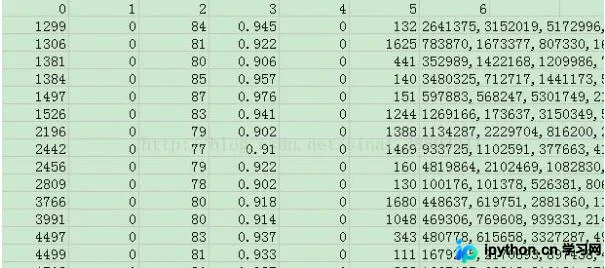
本文介绍如何使用Pandas处理包含逗号分隔数字的列,并通过字典映射将数字转换为对应类别,进而统计每行中各类别出现的频次。核心步骤包括读取数据、构建映射关系、解析字符串并计数,最终输出包含统计结果的DataFrame。
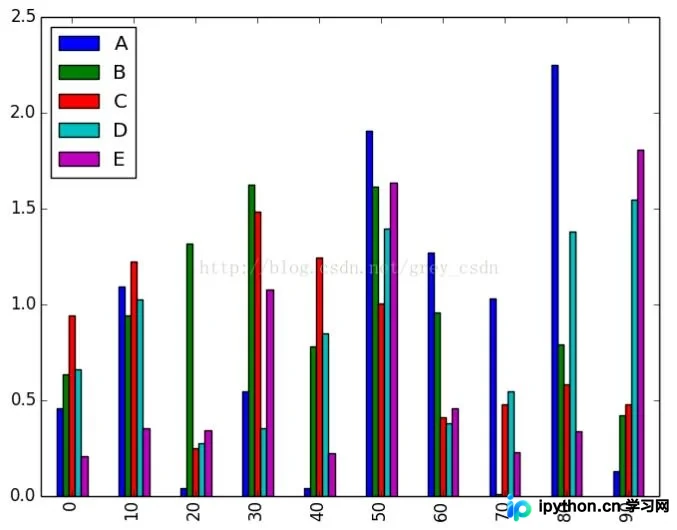
本文介绍如何使用pandas库中的DataFrame对象快速绘制柱状图,实现数据可视化与量化对比。通过调整折线图代码示例,展示了比Excel更便捷的数据处理流程,适合不熟悉Excel的用户参考。
本文深入解析Pandas中iloc与loc两种核心索引方法的本质区别。iloc基于整数位置进行切片,遵循左闭右开规则;loc基于标签进行索引,包含终点。通过自定义索引DataFrame实例,详细演示单行、多行、布尔索引及二维取值的具体用法,并重点剖析默认整数索引下的逻辑陷阱与切片边界差异,帮助开发者准确选择索引方式。
本文分享一个基于Python的电商平台销售数据分析实战项目。内容涵盖数据预处理、探索性分析、深度挖掘及可视化报告生成。通过Pandas、NumPy、Matplotlib等工具,解析销售趋势、用户行为及产品表现,为业务决策提供数据支持,适合后端开发者巩固数据分析技能。
本文介绍使用Python编写的一个身份证信息校验小项目。通过读取Excel区域代码文件,利用Pandas库解析18位身份证中的地区、出生日期及性别信息。重点详解了基于ISO 7064:1983.MOD 11-2标准的校验码算法,包括权值计算、取余映射及真伪判断逻辑,提供完整可运行代码供学习参考。
本文详细说明如何使用 Python 的 matplotlib 库绘制分组堆叠条形图。通过加载 Excel 数据,结合多次调用 plt.bar() 并配置 bottom 偏移量与柱体间距,实现多组数据的对比展示。附带完整代码、关键参数说明及图表导出方法,解决常规教程仅展示单组堆叠的不足。
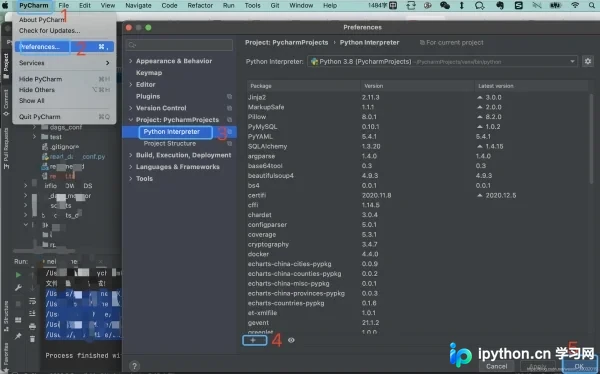
本文系统介绍Python数据分析生态中的七个核心库,涵盖NumPy、SciPy、Pandas、Scikit-learn及Matplotlib等可视化工具。详细解析各库功能特性,并提供Anaconda发行版、pip命令及PyCharm环境下的多种安装指南,最后通过NumPy的vdot函数示例展示基础应用,助力开发者快速构建数据处理工作流。