

NumPy .npy格式与pandas DataFrame序列化存储详解
本文对比了CSV与NumPy .npy格式在存储效率上的差异,并通过实例演示了如何利用NamedTemporaryFile进行临时文件操作。文章详细讲解了使用np.save保存数组、检查.npy文件大小及形状的方法,并进一步介绍了利用pickle格式序列化存储pandas DataFrame的过程及读取方式,展示了.npy文件相比CSV显著更小的体积优势。
2026-10-13
6

本文对比了CSV与NumPy .npy格式在存储效率上的差异,并通过实例演示了如何利用NamedTemporaryFile进行临时文件操作。文章详细讲解了使用np.save保存数组、检查.npy文件大小及形状的方法,并进一步介绍了利用pickle格式序列化存储pandas DataFrame的过程及读取方式,展示了.npy文件相比CSV显著更小的体积优势。
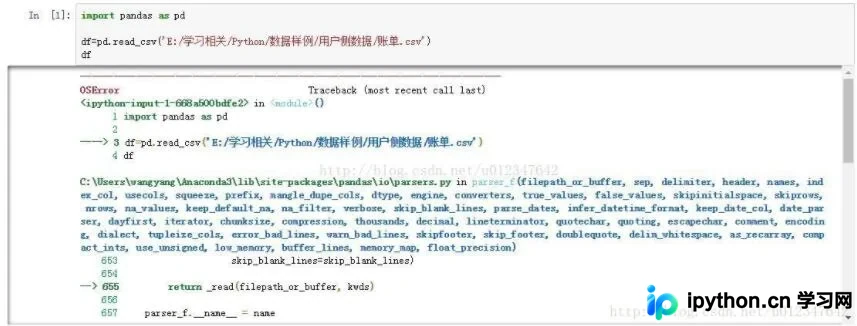
在使用pandas读取文件名含中文的csv文件时,常因默认C引擎兼容性问题触发OSError。通过将read_csv函数的engine参数显式设置为'python',可解决中文标题读取错误,尽管速度略慢但功能更完备。
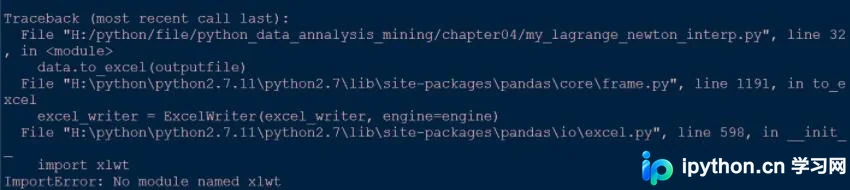
本文针对Python使用pandas库将DataFrame写入Excel时遇到的两个常见错误进行解析。首先介绍如何通过pip安装缺失的xlwt依赖库;其次重点解决因Windows路径中单斜杠导致的to_excel报错,指出需将路径中的单斜杠替换为双斜杠以正确处理转义字符,确保文件成功保存。
本文介绍如何使用pandas的read_table函数读取CSV文件。通过对比指定sep=','与不指定分隔符两种情况,分析read_table在默认行为下的数据解析差异。结果显示,明确指定分隔符可正确生成DataFrame结构,而省略sep参数可能导致列名合并及数据解析异常,建议在实际操作中显式声明分隔符以确保数据准确性。
在使用Pandas的read_csv函数时,若文件路径或文件名包含中文字符,直接导入会触发报错。本文介绍通过Python内置open函数先打开文件对象,再将其传递给read_csv的方法,从而成功读取含中文路径的数据文件。
本文介绍在Python中将mat文件转换为csv文件的两种常用方法。第一种利用h5py库直接读取HDF5格式数据并转为DataFrame;第二种通过scipy.io.loadmat加载结构体后提取数据。两种方案均使用pandas将结果保存为csv文件,适用于数据预处理及格式转换场景。
本文系统梳理了Python中处理CSV文件的两种主流方式:内置csv模块与第三方Pandas库。详细解析了csv.writer、csv.DictWriter等核心类的创建与读写方法,涵盖数据写入、读取及方言注册;同时深入讲解Pandas中read_csv、to_csv等导入导出接口,以及数据筛选、清洗、分组聚合、合并与统计等高频操作,助力开发者高效处理结构化数据。
本文介绍了如何使用pandas库将numpy数组高效转换为DataFrame并保存为CSV文件。通过示例代码展示了从迭代处理数据、构建numpy数组到最终调用to_csv方法保存文件的完整流程,适用于需要批量导出结构化数据的Python开发场景。
本文介绍使用 pandas 将字典转换为 DataFrame 的方法。当字典值为标量时直接转换会引发 ValueError 错误,可通过指定 index 或将字典放入列表两种方式进行修正,确保数据正确生成表格结构。
本文介绍在 Python 数据分析中,利用 pandas DataFrame 进行行筛选的常用技巧。通过 isin() 方法可实现按特定值选取行,而排除特定行则可通过将列转换为列表并移除目标值后再次使用 isin() 来实现,无需额外函数。
本文介绍利用Pandas库实现多列同元素去重的方法。通过合并列、排序字符并拼接,再执行唯一性筛选,可高效去除顺序不同但内容相同的重复行。适用于数据清洗场景,代码简洁且执行速度快,适合处理大规模表格数据。
本文详解Python3中如何使用pandas模块进行Excel文件的读写操作。重点介绍读取数据所需的read_excel函数及xlrd依赖,以及通过构造DataFrame并调用to_excel方法写入数据的完整流程,附带关键参数说明与代码示例,助力快速掌握数据处理技巧。