

Python利用pandas与SQLAlchemy快速将CSV数据导入数据库
本文介绍如何使用Python脚本结合pandas库与SQLAlchemy引擎,实现将本地CSV文件快速批量插入数据库的功能。脚本通过命令行接收文件名和表名,利用copy_from方法高效处理数据写入,适用于PostgreSQL等支持COPY命令的数据库场景。
2026-10-13
6

本文介绍如何使用Python脚本结合pandas库与SQLAlchemy引擎,实现将本地CSV文件快速批量插入数据库的功能。脚本通过命令行接收文件名和表名,利用copy_from方法高效处理数据写入,适用于PostgreSQL等支持COPY命令的数据库场景。
本文详细介绍Python中pandas模块DataFrame的多种创建方式,包括通过列表、字典及Numpy数组构建数据框。解析DataFrame的双索引机制及其与Series的关系,并提供代码示例,帮助开发者快速掌握数据框的初始化技巧。
在使用pandas的read_csv()函数读取CSV文件时,若未指定数据类型,数值列可能被默认读取为object类型,导致后续比较运算抛出TypeError。本文通过示例展示如何查看列类型,并利用dtype参数在读取时显式指定数值类型,从而解决字符串与整数比较的错误。
本文总结Pandas读取CSV文件时常见的OSError错误,主要原因为文件路径包含中文导致无法正确加载。提供两种解决方案:修改为全英文路径或在文件名前添加u前缀,推荐优先使用第一种方案以彻底避免编码问题。
本文详细演示如何使用NumPy的savetxt函数和pandas的to_csv方法将数组数据保存为CSV文件。内容涵盖设置随机种子、生成含NaN值的3x4数组、指定格式与分隔符,以及处理DataFrame列名和缺失值字符串,提供完整的代码示例与参数说明。
本文详解利用Numpy和Pandas库将CSV文件数据读取为数组或矩阵的方法。重点解决路径转义字符导致的SyntaxError,并演示使用Pandas处理缺失值及结合Sklearn的Imputer进行数据清洗的完整流程。
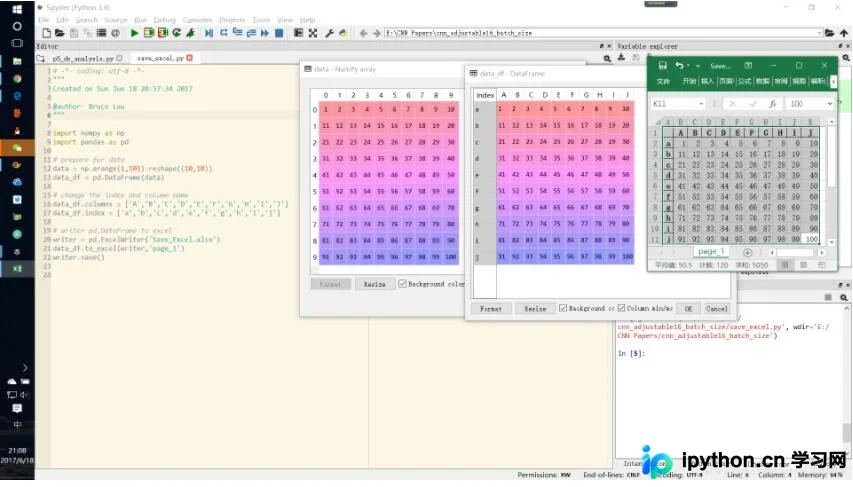
本文介绍如何使用pandas库将numpy数组转换为DataFrame并导出为Excel文件。通过设置列名、索引及浮点数精度,实现数据的高效保存。示例代码展示了从数据准备到文件写入的完整流程,适用于需要批量处理数值数据的场景。
本文介绍如何在Python中使用Pandas库筛选数据集中特定列字符串长度大于20的记录。核心步骤包括将目标列强制转换为字符串类型,利用str.len()方法计算长度,并通过布尔索引过滤出满足条件的数据行。该方法简洁高效,适用于处理包含长文本字段的数据集。
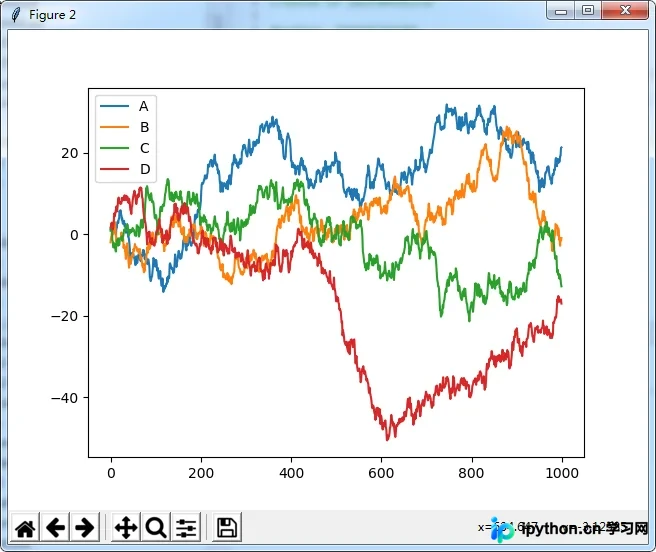
本文汇总了Python中利用matplotlib和pandas库进行数据可视化的经典示例。内容涵盖折线图、散点图、条形图、饼图、三维曲面图及矩阵散点图等多种图表类型的实现代码与运行效果,旨在帮助开发者快速掌握Python绘图技巧。
本文详解Python中实现多条件数据筛选的三种方法:内建filter函数、pandas库及普通循环。通过词性标注示例对比代码实现与运行结果,指出filter与pandas在速度上更具优势,适合高效处理结构化数据。
本文详细解析Python Pandas中数据选取的三种核心方法:.loc、.iloc和.ix。通过具体代码示例,阐述在已知列名与索引时使用.loc,通过整数位置切片时使用.iloc,以及混合使用标签与下标时使用.ix的适用场景。文章旨在帮助开发者清晰区分三者差异,提升数据处理的效率与准确性。
本文介绍在Python中利用Pandas库的map函数,对DataFrame中百万级大规模数据进行高效批量映射赋值的方法。通过定义状态字典,将原始状态码如HUMAN_REFUSE等映射为中文结果,并创建新列存储,实现数据清洗与转换。