

Python pandas to_excel 写入 Excel 文件报错解决方案

发布时间:2026-10-13| 4人浏览过
本文针对Python使用pandas库将DataFrame写入Excel时遇到的两个常见错误进行解析。首先介绍如何通过pip安装缺失的xlwt依赖库;其次重点解决因Windows路径中单斜杠导致的to_excel报错,指出需将路径中的单斜杠替换为双斜杠以正确处理转义字符,确保文件成功保存。
在研读《Python数据分析挖掘实战》一书的过程中,数据预处理章节涉及利用拉格朗日插值法填补缺失值,具体实现代码如下:
#-*- coding:utf-8 -*-
import pandas as pd
import matplotlib.pyplot as plt
from scipy.interpolate import lagrange#导入拉格朗日插值函数

inputfile="catering_sale.xls"
outputfile="H:\python\file\python_data_annalysis_mining\chapter04\sales.xls"

data=pd.read_excel(inputfile,sheetname=0)
statistic=data.describe()#保存基本统计量
print statistic

time=data[u'日期'].values
number=data[u'销量'].values
plt.scatter(time,number)
plt.show()#根据散点图找过滤异常值的方法

data[u'销量'][(data[u'销量']<300)|(data[u'销量']>6000)]=None#过滤异常值,设置为空

#自定义列向量插值函数
#s为列向量,n为插值位置,k为取前后的数据个数,默认为5,不宜太多,受到数值不稳定性影响
def ployinterp_column(s,n,k=5):
 y=s[list(range(n-k,n))+list(range(n+1,n+1+k))]
 y=y[y.notnull()]#剔除异常值
 return lagrange(y.index,list(y))(n)#插值并返回插值结果

for i in data.columns:
 for j in range(len(data)):
  if(data[i].isnull())[j]:
   data[i][j]=ployinterp_column(data[i],j)

data.to_excel(outputfile)
1. 导入 xlwt 模块报错
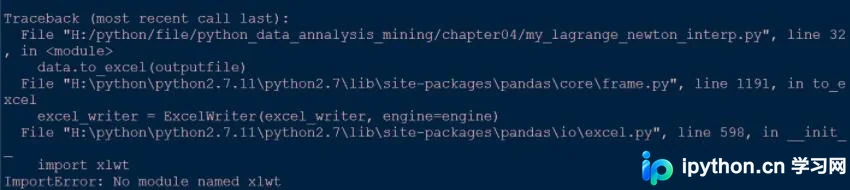
该问题处理较为简单,可通过官方网站下载安装相关包,或在集成开发环境中执行以下命令完成安装:
pip install xlwt
2. to_excel 方法报错
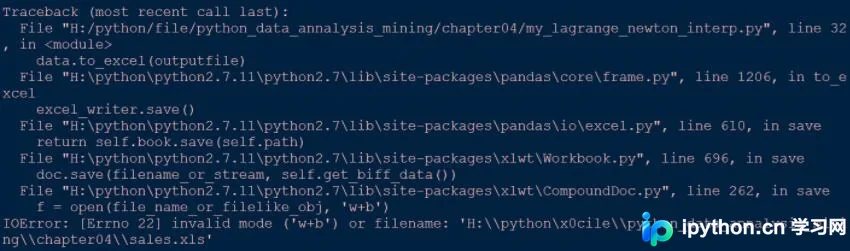
此错误由以下代码片段触发:
data.to_excel(outputfile)
错误提示为“无效的模式('w+b')或者文件名”,这通常意味着两个原因之一:一是目标文件不可写('w'代表写入权限),二是打开模式不正确('b'代表二进制模式);另一种可能是文件名路径配置有误。经排查,确认为路径问题所致,相关代码如下:
outputfile="H:\python\file\python_data_annalysis_mining\chapter04\sales.xls"
修正后的代码如下:
outputfile="H:\\python\\file\\python_data_annalysis_mining\\chapter04\\sales.xls"
即将路径中的单斜杠替换为双斜杠,以解决字符串转义带来的问题。
上述内容即为解决Python pandas DataFrame写入Excel时出现问题的完整方案,希望能对读者有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









