

pandas DataFrame 算术、逻辑与统计运算详解
本文详细介绍 pandas DataFrame 的核心运算方法。涵盖 add/sub 算术运算、逻辑符号与 query/isin 筛选、describe 及各类统计函数(max/min/median/std等)、累计统计 cumsum,以及通过 apply 实现自定义列或行运算。
2026-10-14
6

本文详细介绍 pandas DataFrame 的核心运算方法。涵盖 add/sub 算术运算、逻辑符号与 query/isin 筛选、describe 及各类统计函数(max/min/median/std等)、累计统计 cumsum,以及通过 apply 实现自定义列或行运算。
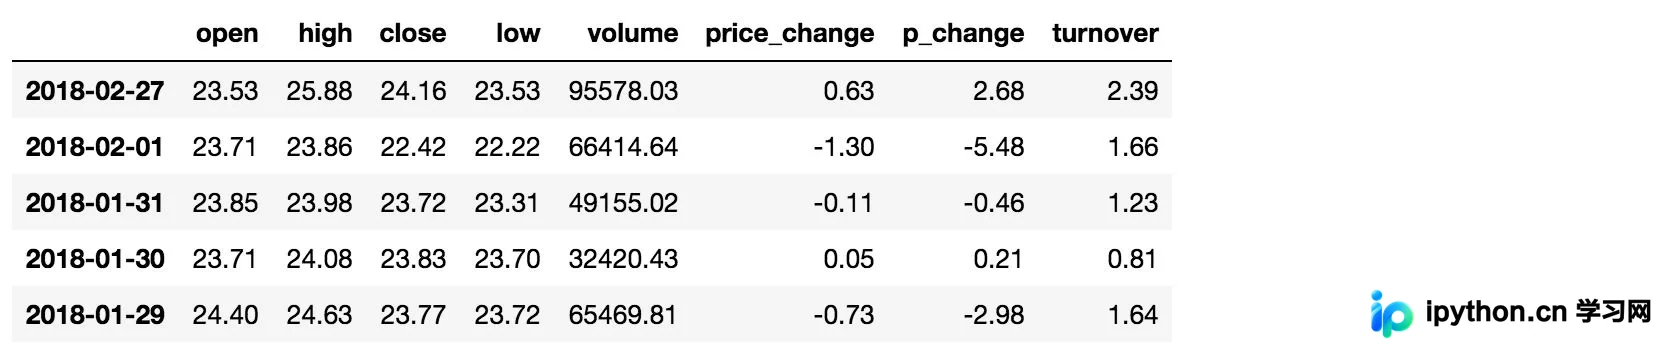
本文深入解析 pandas 库中 DataFrame.plot() 函数的核心参数与用法。详细讲解如何配置图形类型(折线、条形、散点等)、子图布局及坐标轴设置,并指出散点图需传入双Y列的关键细节。同时提供在 Jupyter Notebook 与脚本环境中创建画布、子图及显示图形的标准流程,帮助开发者高效实现数据可视化。
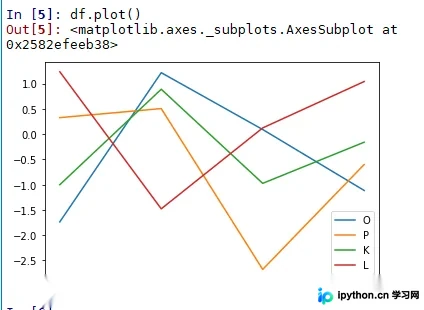
本文详细讲解在Python Pandas库中,如何将Dataframe和Series对象转换为List列表格式,包括提取单列、去重及多维转换。同时介绍将Dataframe转换为字典(Dict)的两种常用方法:直接转换与设置索引后转换,并对比其结果差异,适用于词云生成等场景。
本文详细介绍在Python pandas中获取Dataframe元素值的多种方法。包括通过遍历、类字典属性访问Series,以及使用at、iat、loc和iloc等属性根据行索引、列名或索引位置精准获取单个元素、单行或多行数据,涵盖Series与Dataframe的返回类型差异。
本文深入解析Pandas中DataFrame的单列、多列及分组运算方法。通过map实现元素级操作,利用apply处理行或列聚合,结合transform进行组内映射,以及使用agg执行复杂分组统计。涵盖具体代码示例与参数说明,帮助开发者高效处理数据。
本文总结了在pandas库中创建DataFrame的七种常用方法,包括利用Python字典、指定列与索引、读取Excel/CSV文件、使用NumPy数组、合并元组以及基于Series生成数据。文章提供了相应的代码示例与注意事项,如读取Excel需安装xlrd包,旨在帮助开发者快速掌握数据框的构建技巧。
本文详细介绍Python中Pandas库对DataFrame行和列的选取与删除方法。重点解决读取CSV时产生的未命名索引列问题,通过重命名或删除列索引实现数据清洗。涵盖iloc、loc、head、tail等常用函数的使用场景及版本兼容性注意事项,帮助开发者高效处理结构化数据。
本文详解Pandas中处理缺失值的两种主要方式。首先介绍针对np.nan类型缺失值的直接删除(dropna)与均值/自定义值填充(fillna)操作;其次讲解如何处理带有特定标记的非标准缺失值,通过replace将其转换为np.nan后再进行常规处理。
本文介绍如何在Python Pandas中使用rolling和apply函数实现数据框的向下取值及多列滚动操作。通过自定义函数处理窗口内的数据,演示如何生成新列及进行多列滚动计算,包含具体代码示例与结果分析,帮助开发者掌握相关技巧。
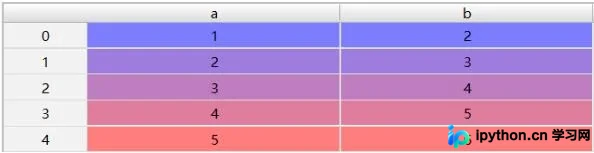
本文介绍如何在Python中使用NumPy实现类似Pandas的rolling滚动窗口功能。通过调整数组形状和步幅,利用NumPy底层C代码执行高效循环。文章详细解析了滚动窗口的参数设置、计算方法及与Pandas rolling函数的区别,并提供具体代码示例,帮助开发者在时间序列数据分析中灵活应用滚动计算。
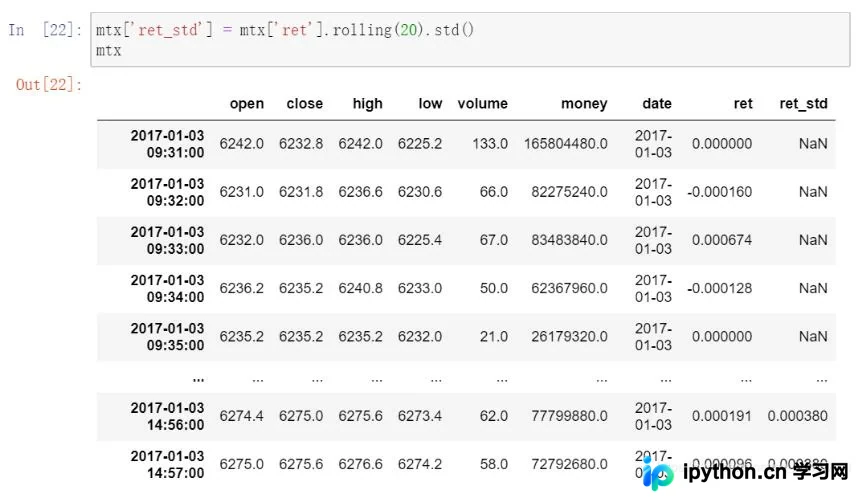
本文详解Python中计算滚动方差和标准差的两种常用方法:Talib库的VAR/STDDEV函数与Pandas的rolling函数。重点分析两者在分母处理(N与N-1)及数据输入类型上的差异,通过代码示例展示具体实现及结果对比。
本文介绍如何在Python中使用NumPy计算数组按列非零元素的平均值,通过判断非零元素并求和除以数量实现。同时补充了利用Pandas DataFrame统计行列零值个数的方法,包括按行返回Series及按列返回Series的操作示例,为数据处理提供实用参考。