pandas重新生成索引的方法
本文介绍在pandas数据处理中,筛选数据导致索引从非零值开始(如600多)时的解决方案。通过对比reindex引入NaN值的局限性,重点讲解使用set_index(drop=True)方法重新生成从0开始的连续索引,并强调需重新赋值以生效。
2026-10-14
6

本文介绍在pandas数据处理中,筛选数据导致索引从非零值开始(如600多)时的解决方案。通过对比reindex引入NaN值的局限性,重点讲解使用set_index(drop=True)方法重新生成从0开始的连续索引,并强调需重新赋值以生效。
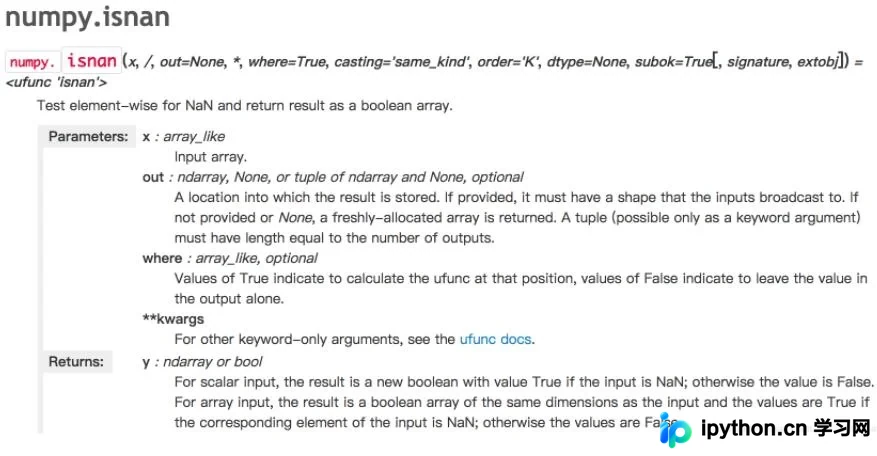
本文介绍在 Python 中使用 Numpy 查找数组中 np.nan 值的方法。通过 numpy.isnan 函数定位 NaN 元素及其索引,并针对 Pandas 读取数据时可能出现的 TypeError 问题,推荐使用 pandas.isnull 进行空值判断,确保数据处理流程的稳定性。
在使用pandas DataFrame的fillna方法时,若未设置inplace=True,填充操作不会修改原数据框,导致看似填充失败。本文通过对比直接打印结果与修改原数据两种方式,详细解析inplace参数的作用,确保数据变更持久保存。
本文介绍基于Python 3.5.0的Pandas数据处理技巧,涵盖对特定列进行加减乘除、列间相乘、生成新列及加权评分计算。重点演示数据归一化逻辑,并详细解析sort_values方法的升序与降序排序参数及inplace属性的使用,帮助读者掌握基础数据清洗与排序操作。
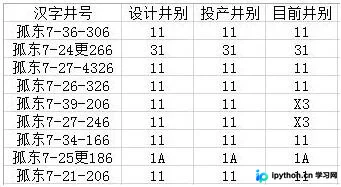
本文介绍如何使用pandas根据多个列的组合条件筛选数据。通过示例展示如何筛选“设计井别”、“投产井别”和“目前井别”均为11的记录,并演示如何通过反向逻辑删除这些行。包含完整的代码实现及文件读写注意事项,适用于需要复杂条件过滤的数据处理场景。
本文介绍在pandas中如何对指定列进行数据填充。通过选取特定列并使用ffill()方法,可实现向下填充缺失值。示例展示了仅对X和Y列执行前向填充,而Z列保持不变的操作过程及结果。
本文介绍如何在 Python 的 pandas DataFrame 中添加新行。通过示例代码展示如何创建空 DataFrame 并使用 loc 方法循环插入包含随机数的数据行,供开发者参考。
本文介绍如何使用Python的Pandas库将Excel文件转换为CSV格式。通过读取指定工作表并设置索引列,即可快速生成UTF-8编码的CSV文件,适用于数据处理场景。
本文介绍如何使用Python的pdfplumber库提取PDF中的表格数据。通过安装模块、导入库、打开文件并调用extract_table()函数,可将表格转换为Pandas数据框。文章还涵盖了单页提取与多页批量处理的代码示例,并提醒注意表格边框及换行对识别结果的影响。
本文详解在Pandas中使用read_csv读取CSV文件时如何灵活处理列名。涵盖文件自带标题、自定义重命名、无标题文件处理等场景。重点讲解header和names参数的正确用法,特别是避免在读取无标题文件时误用header=0导致首行数据丢失的关键注意事项,帮助开发者高效管理数据列结构。
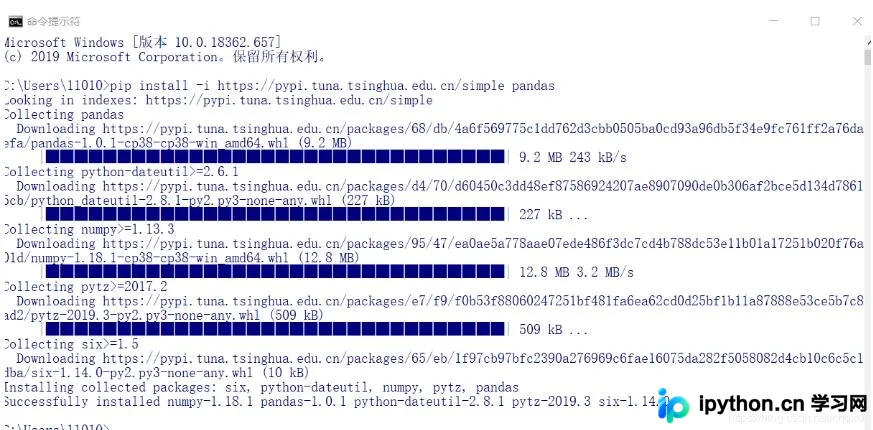
本文详细解决PyCharm中导入Pandas包失败的常见问题。涵盖通过cmd使用清华源pip加速安装、验证安装状态,以及当包未自动识别时,手动配置Project Interpreter、指定pythonw.exe路径及切换Existing environment的完整操作步骤,帮助初学者快速恢复开发环境。
本文介绍如何利用Python的Pandas库进行数据清洗与比对,结合xlwings操作Excel文件以保留原有格式。通过对比项目行数差异并动态插入行,实现多部门Excel内容的自动化汇总,同时确保排版格式不被破坏。