如何在 SQL 视图中使用子查询
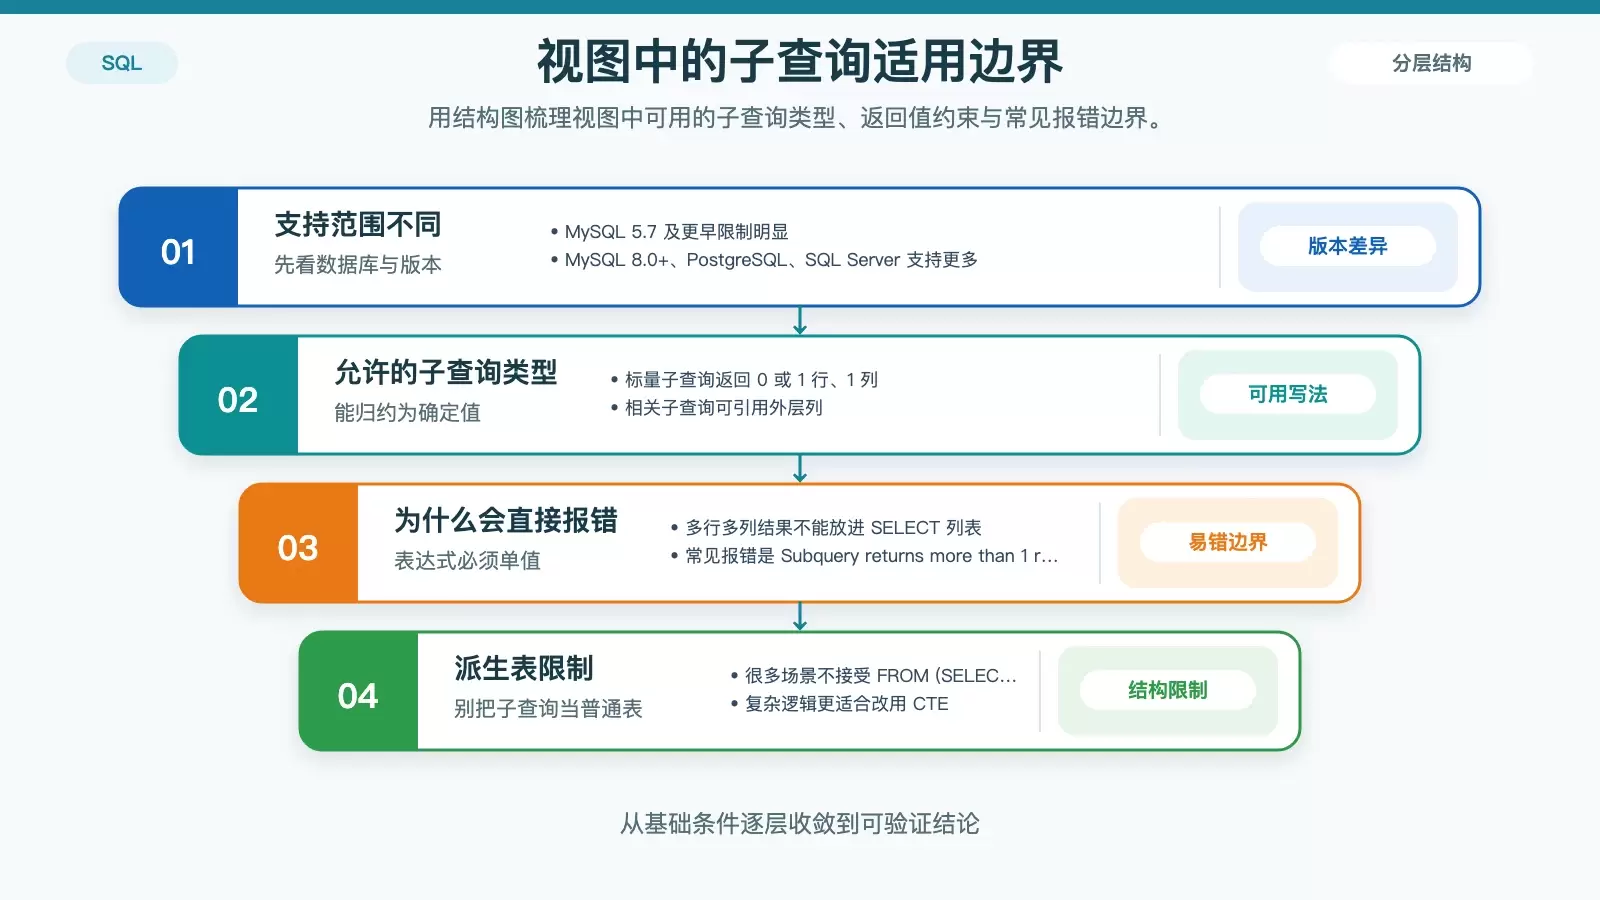
在 SQL 视图中使用子查询并非一律可行,关键在于数据库版本、子查询类型以及优化器的处理方式。本文从能否直接写、何时用 WITH 改写、MySQL 5.7 的替代方案,到常见性能失速原因,梳理出一套更适合落地判断的写法与排查思路。
2026-08-24
99

在 SQL 视图中使用子查询并非一律可行,关键在于数据库版本、子查询类型以及优化器的处理方式。本文从能否直接写、何时用 WITH 改写、MySQL 5.7 的替代方案,到常见性能失速原因,梳理出一套更适合落地判断的写法与排查思路。
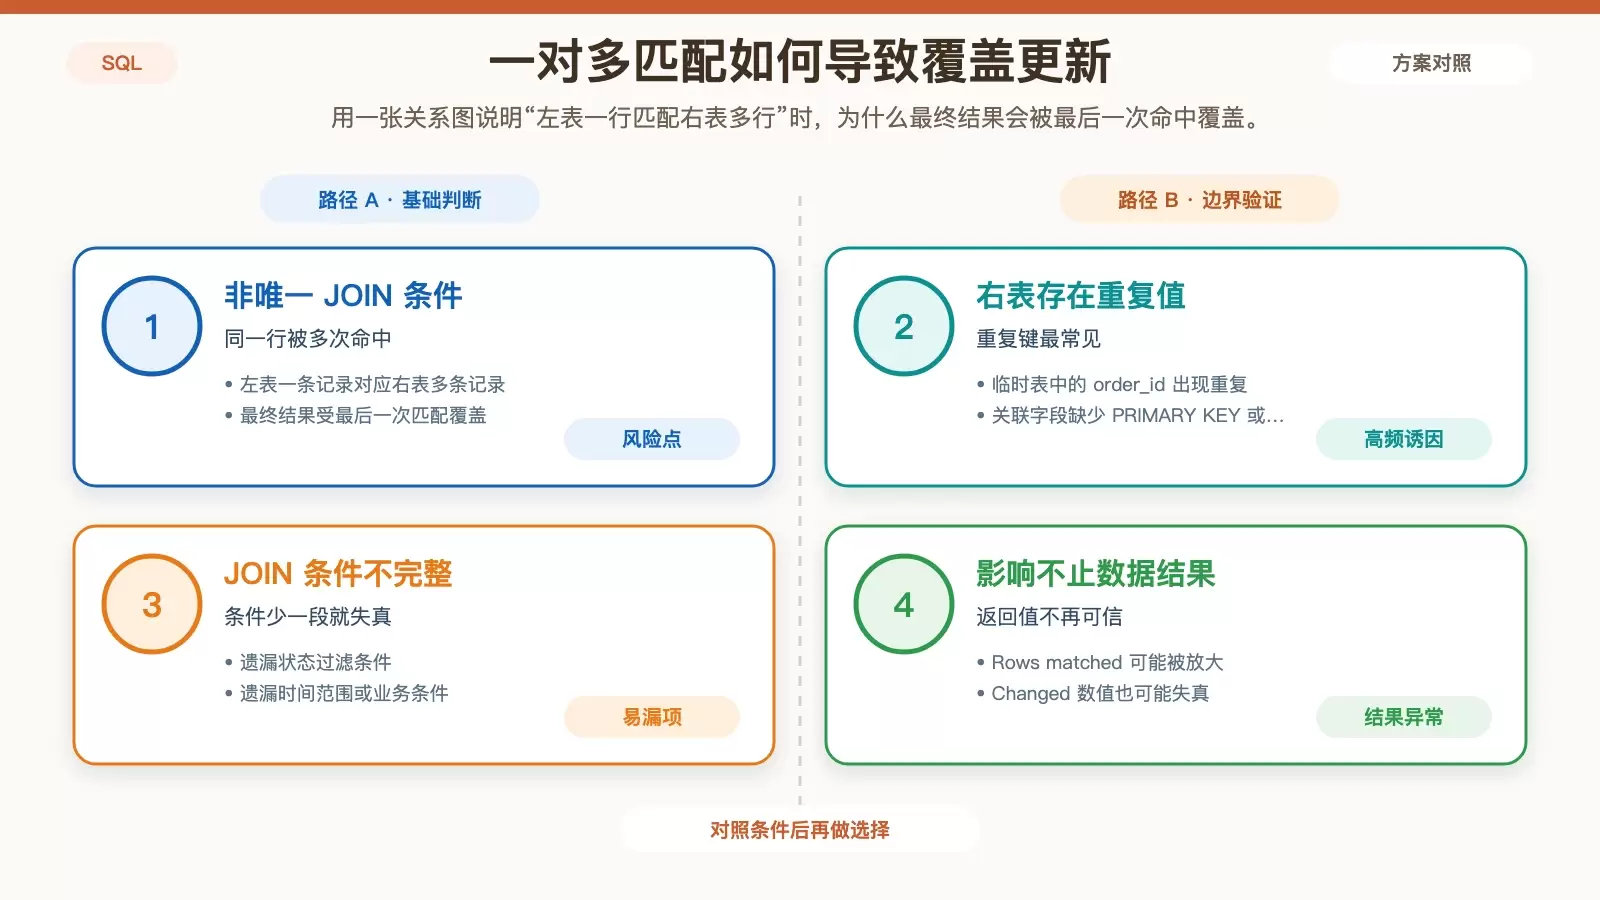
MySQL 的 `UPDATE ... JOIN` 一旦遇到非唯一匹配,往往不会报错,而是让同一行被多次命中,最终只保留最后一次结果。这类问题常由临时表重复、过滤条件缺失或误用 `LEFT JOIN` 引起。本文从成因、排查、改写方式和上线前校验四个方面,梳理一套更稳妥的处理方法。
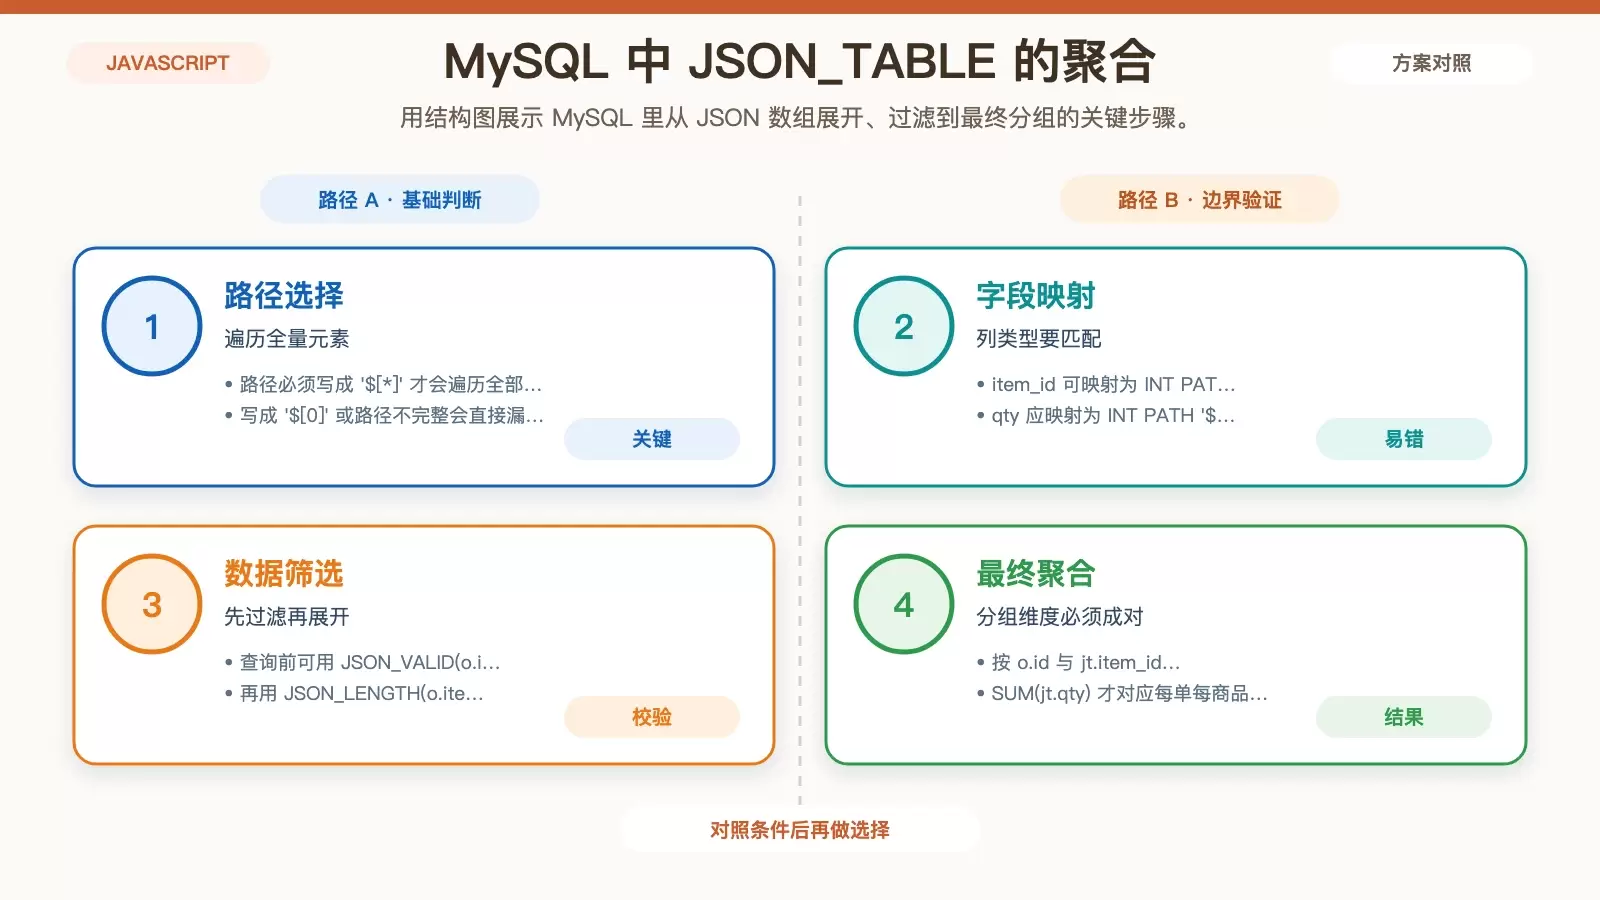
JSON 字段里的数组或对象,不能直接拿来做 `GROUP BY`。这篇文章把 MySQL 8.0+ 的 `JSON_TABLE()` 和 PostgreSQL 的 `jsonb_array_elements()` 拆开说明,并补上类型转换、空值过滤、分组维度选择这些最容易把统计结果做错的关键点。 JSON 字段里有数组或对象时,不能直接 GROUP BY 。正确做法是先展开成行,再按主键或提取字段分组。
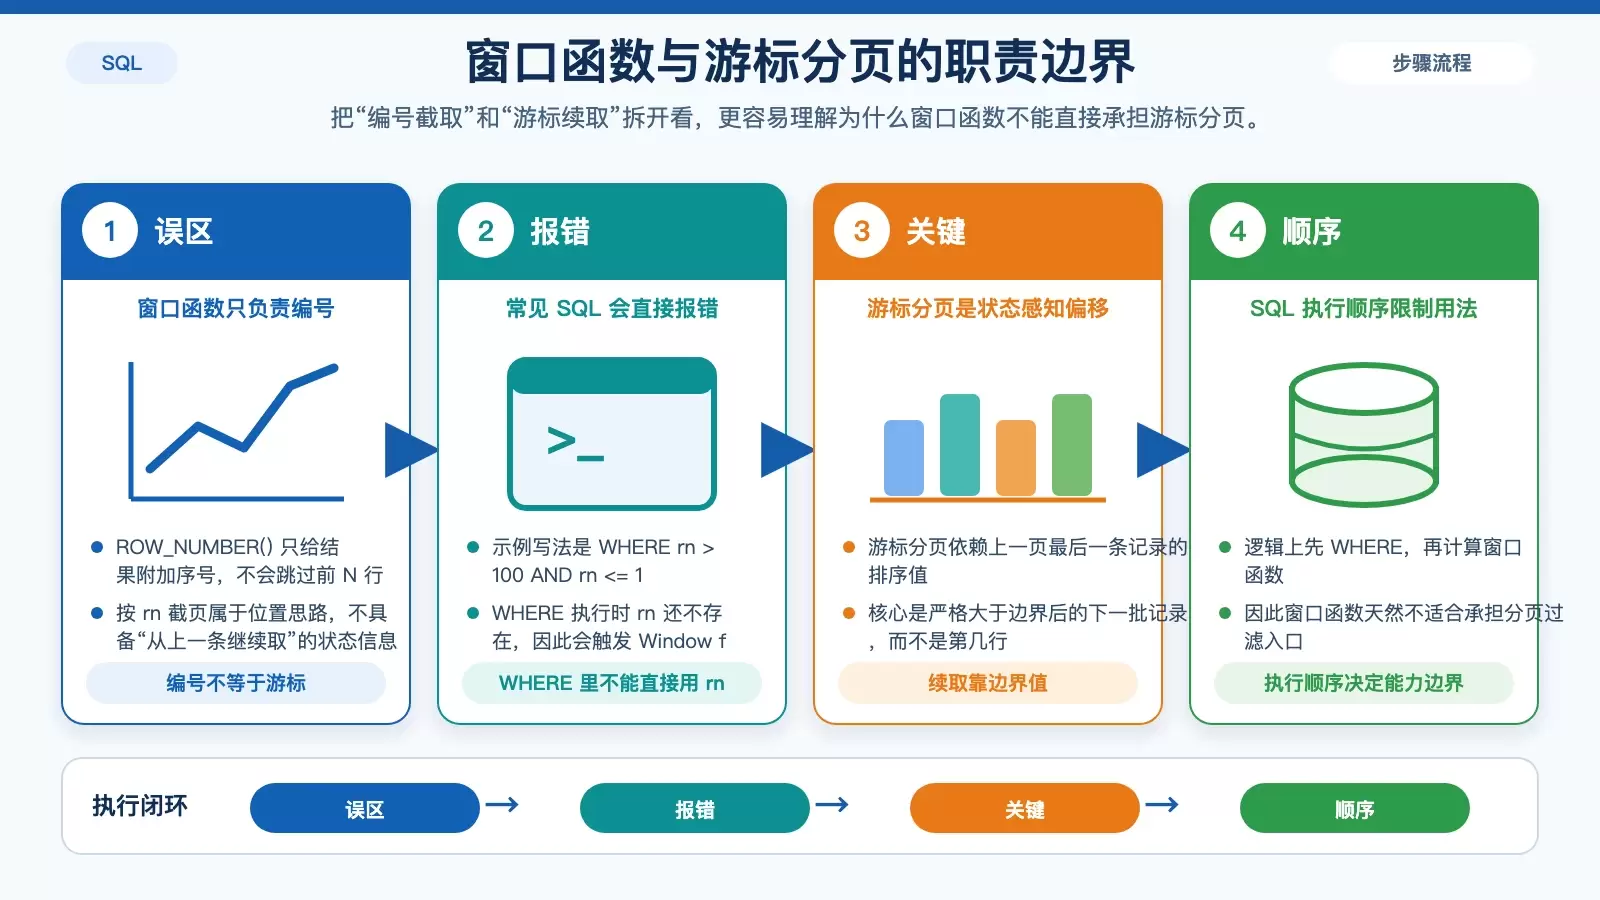
窗口函数适合给结果集编号,却不能承担游标分页的“从上一条继续取”的职责。本文拆开常见误区、正确 SQL 写法、窗口函数在分页中的辅助用法,以及 PostgreSQL、MySQL、SQLite、SQL Server 的实现差异。 很多 SQL 教程会把“窗口函数编号”和“游标分页”混在一起,结果写出来的语句不是直接报错,就是翻页时重复、漏数。
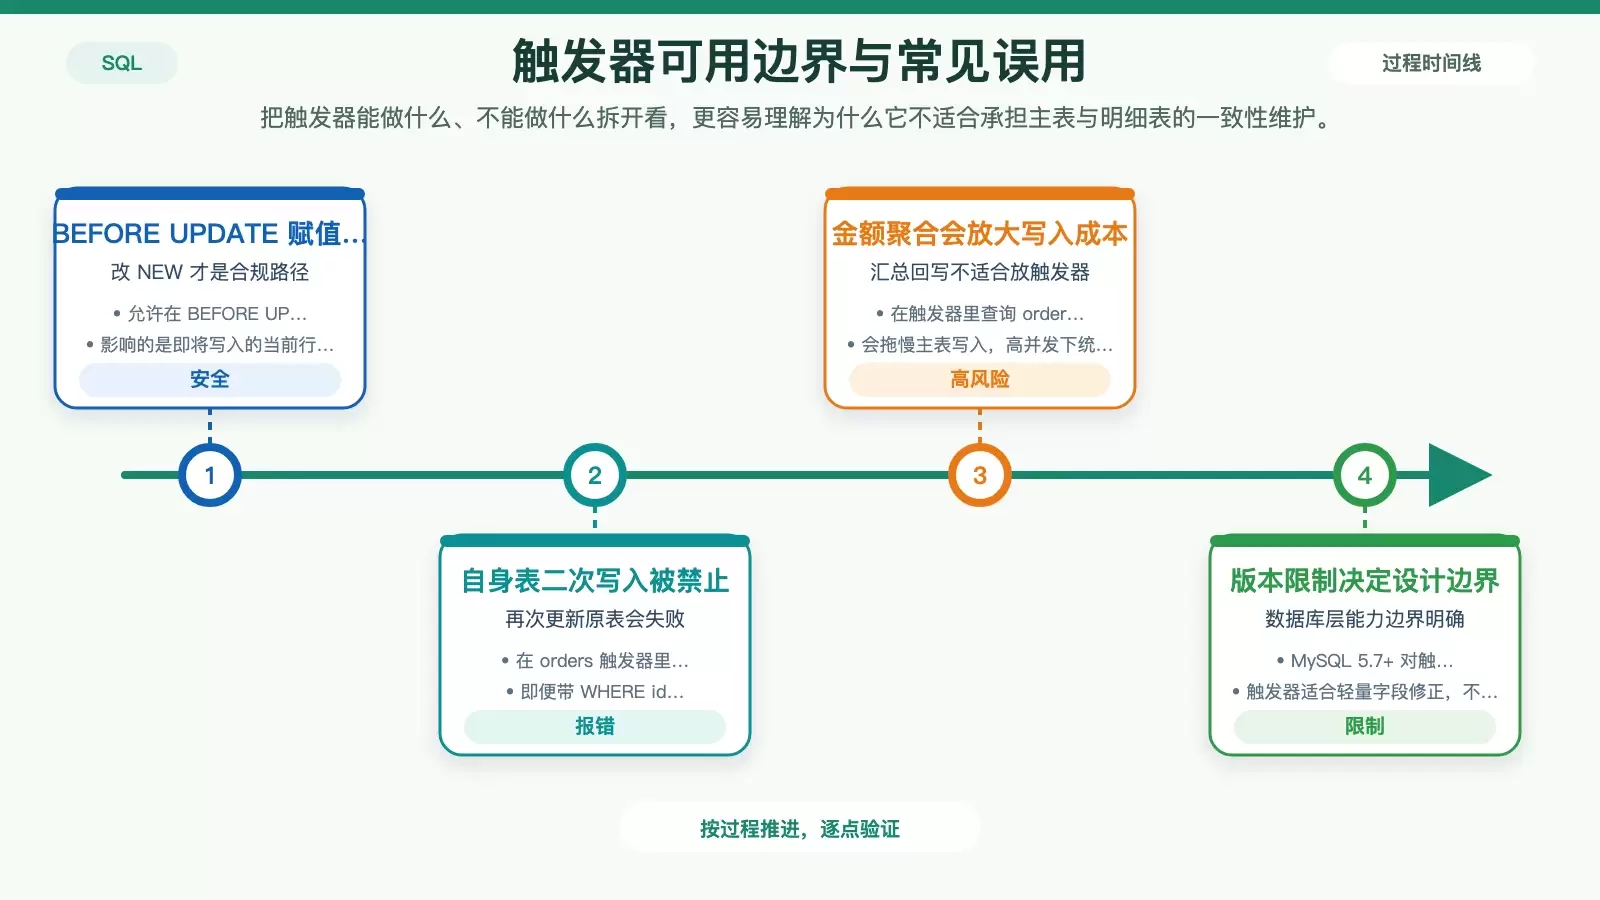
主表与明细表的一致性,不能指望 SQL 触发器“自动兜底”。这类方案在 MySQL 5.7+ 下限制很多,跨表同步还容易在并发、批量写入和多路径更新时失效。真正稳妥的做法,是把强一致性交给应用层事务,把报表类同步改成队列异步处理。
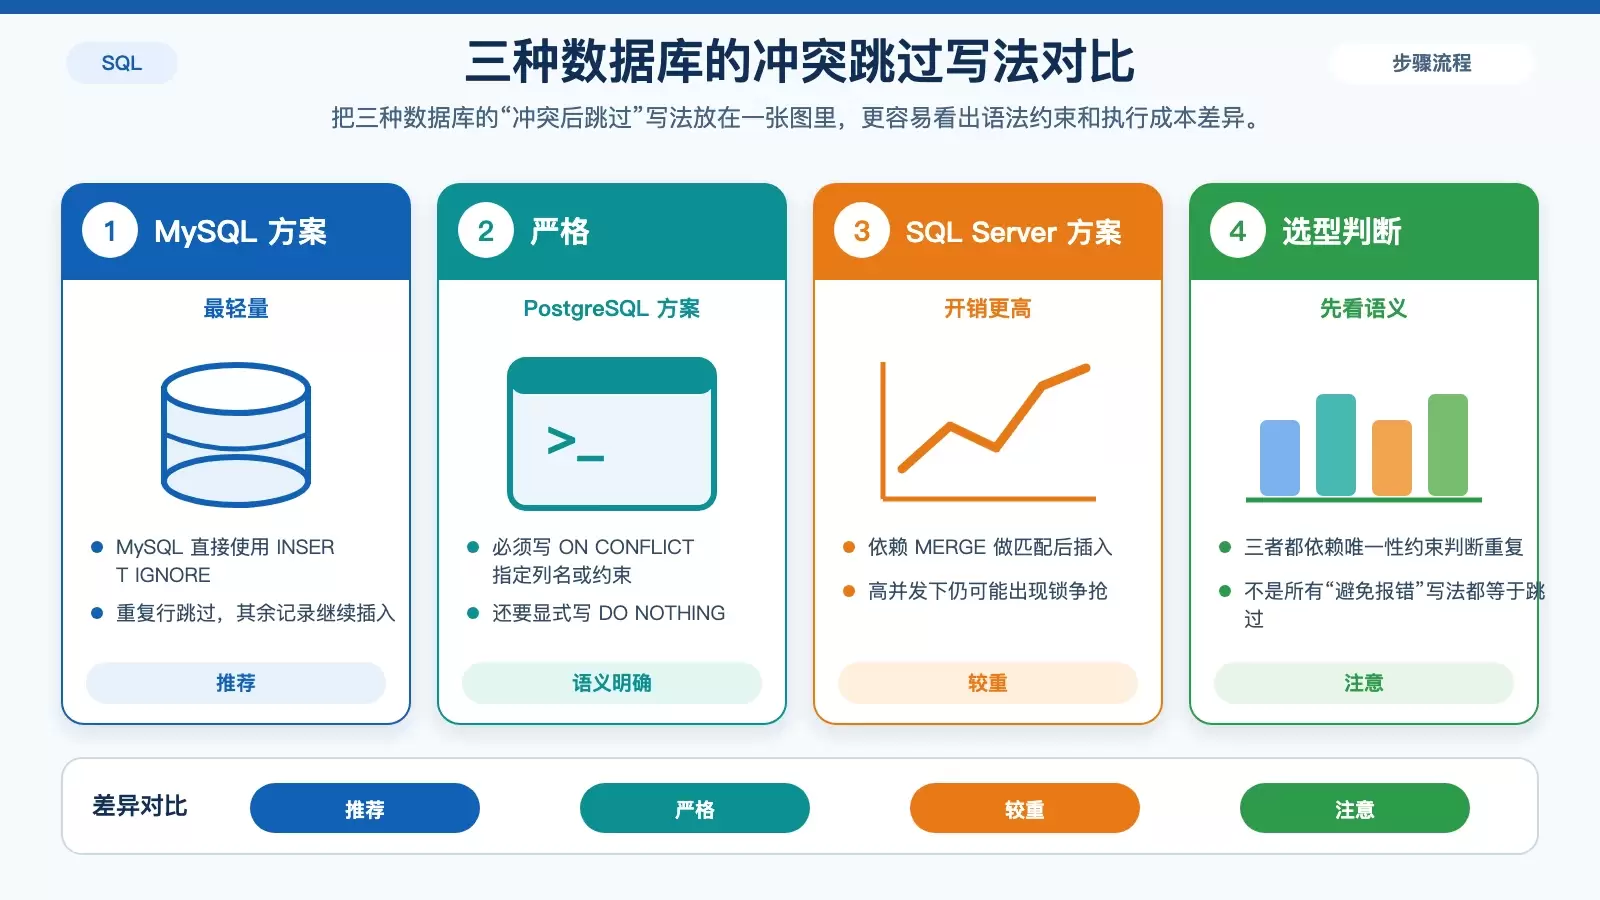
批量插入遇到主键或唯一键重复时,核心不是“怎么不报错”,而是按数据库方言选择真正的跳过写法。MySQL、PostgreSQL 和 SQL Server 的语义、锁行为与开销差异很大,用错语句往往会把简单去重变成阻塞和死锁问题。
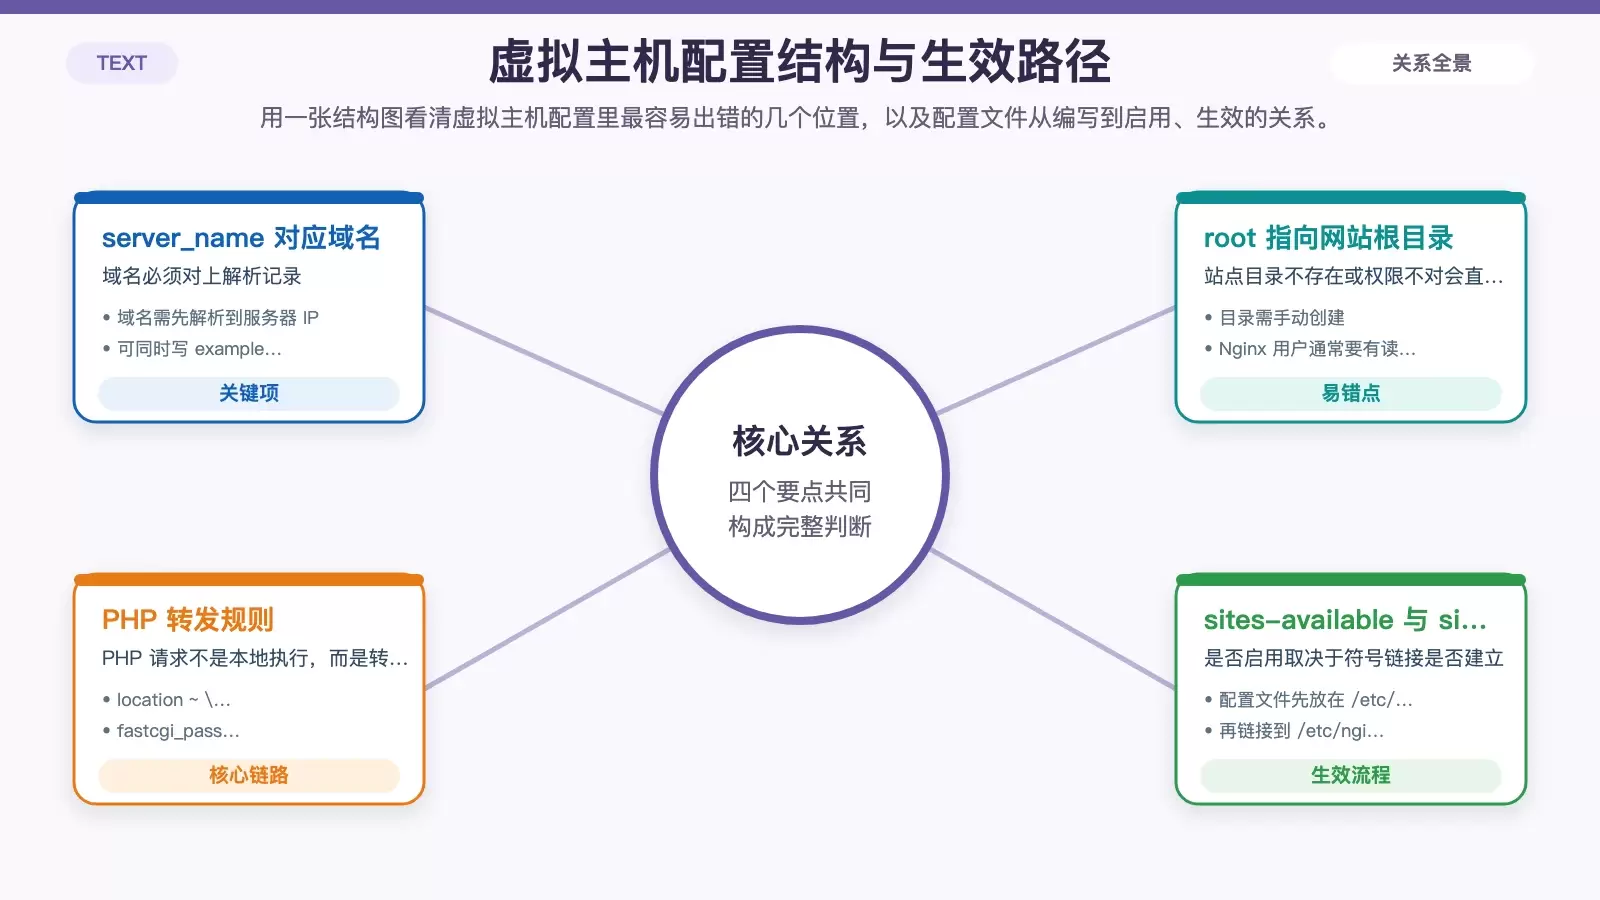
本文按 LNMP 实际部署顺序,梳理 Nginx 在站点接入中的关键配置:安装、虚拟主机、PHP-FPM 对接、MySQL 准备,以及 HTTPS、缓存和防火墙等常见加固项。适合需要快速搭起可用 Web 环境,同时希望避开路径不匹配、权限错误和配置未生效等问题的读者。
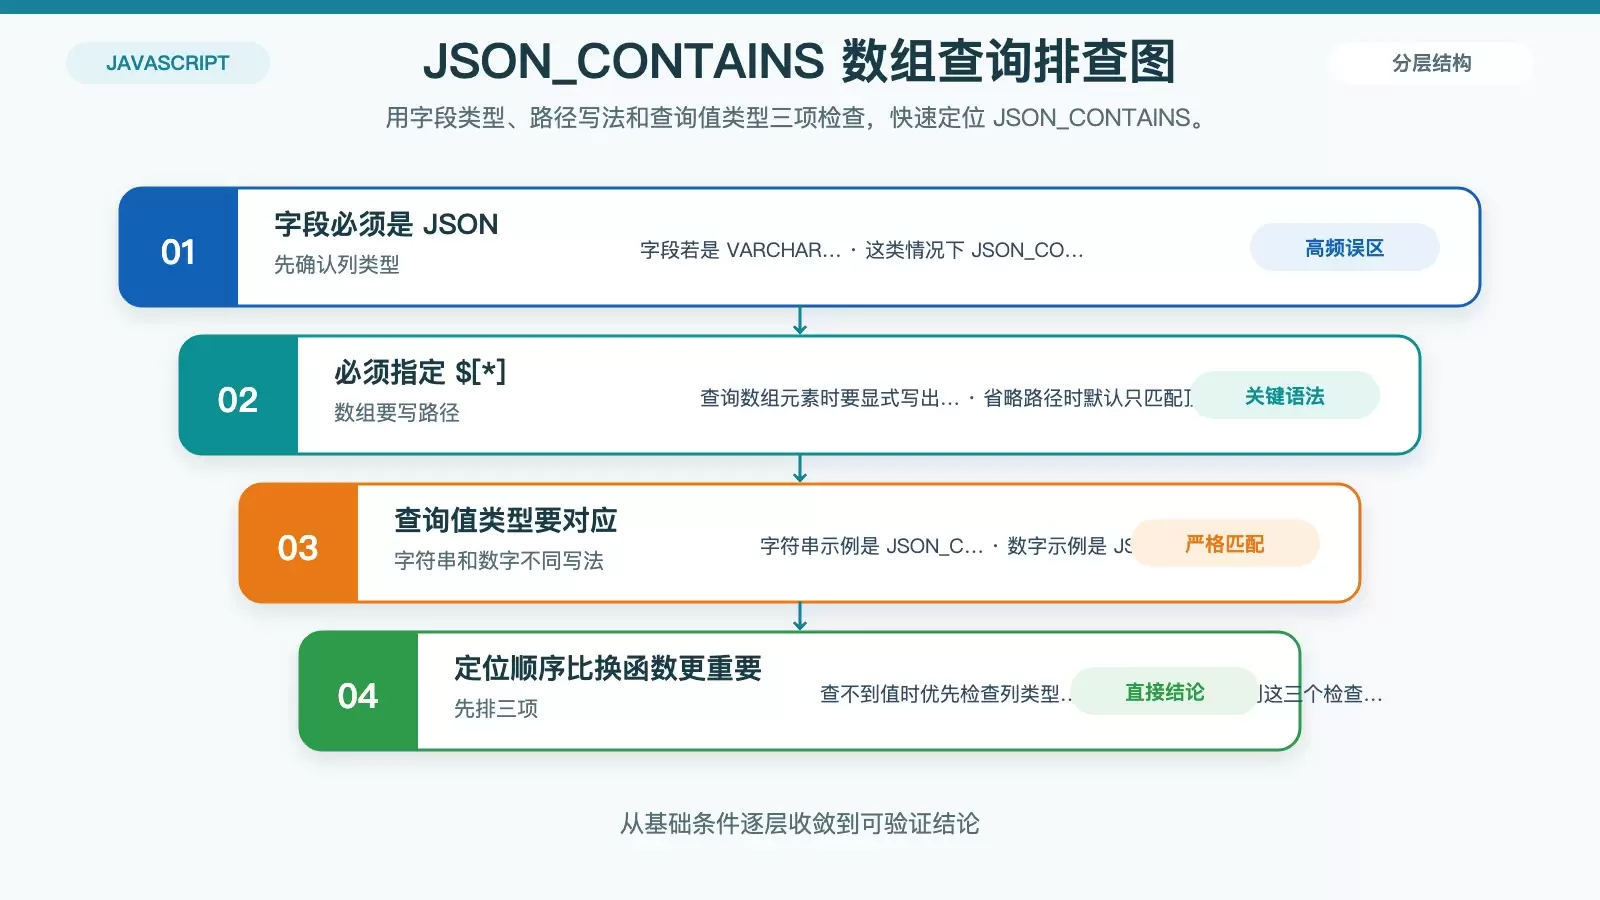
查询 SQL JSON 数组时,最常见的问题不是函数失效,而是字段类型、路径表达式和元素类型没对上。本文用 MySQL 与 PostgreSQL 两套写法,梳理 JSON_CONTAINS、JSON_EXTRACT、JSON_TABLE 与 jsonb 操作符的适用场景、坑点和性能差异。 很多人第一次查 SQL 里的 JSON 数组,都会遇到同一个现象:语句看起来没错,结果却始终查不到。
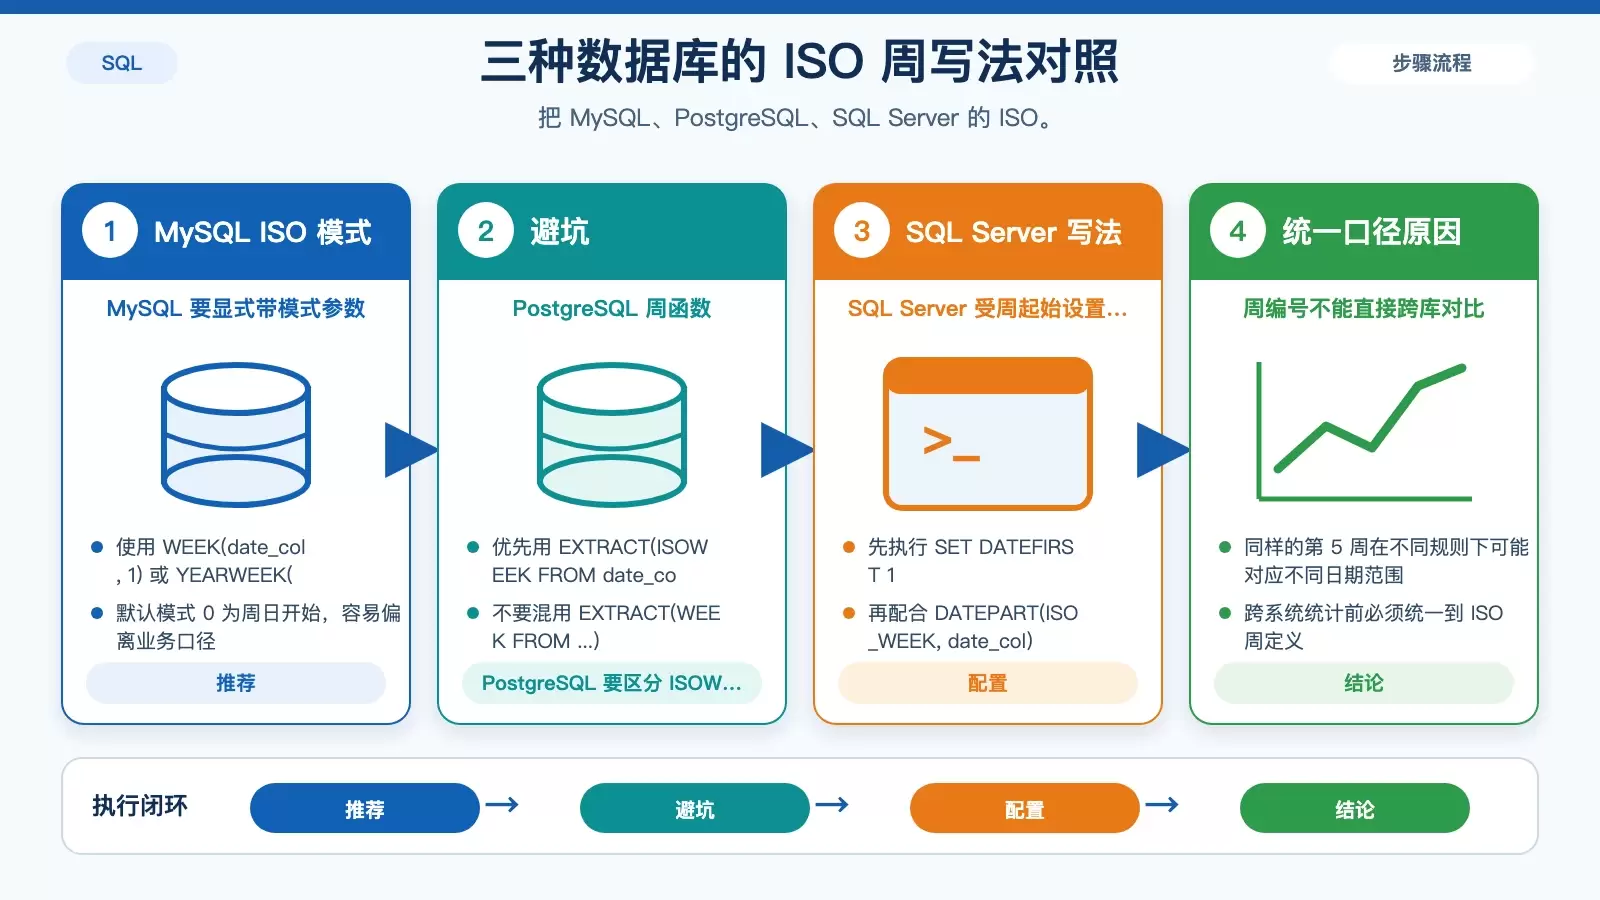
统计“每周新增用户”时,真正容易出错的不是 SQL 语法,而是周定义、首活口径和跨年分组。本文按 MySQL、PostgreSQL、SQL Server 分别说明 ISO 周写法,并给出新增用户统计、跨年周处理与索引优化的实操要点。 很多人写“每周新增用户”统计时,都会直接对时间字段套上 WEEK() ,但这一步很可能已经把结果做偏了。
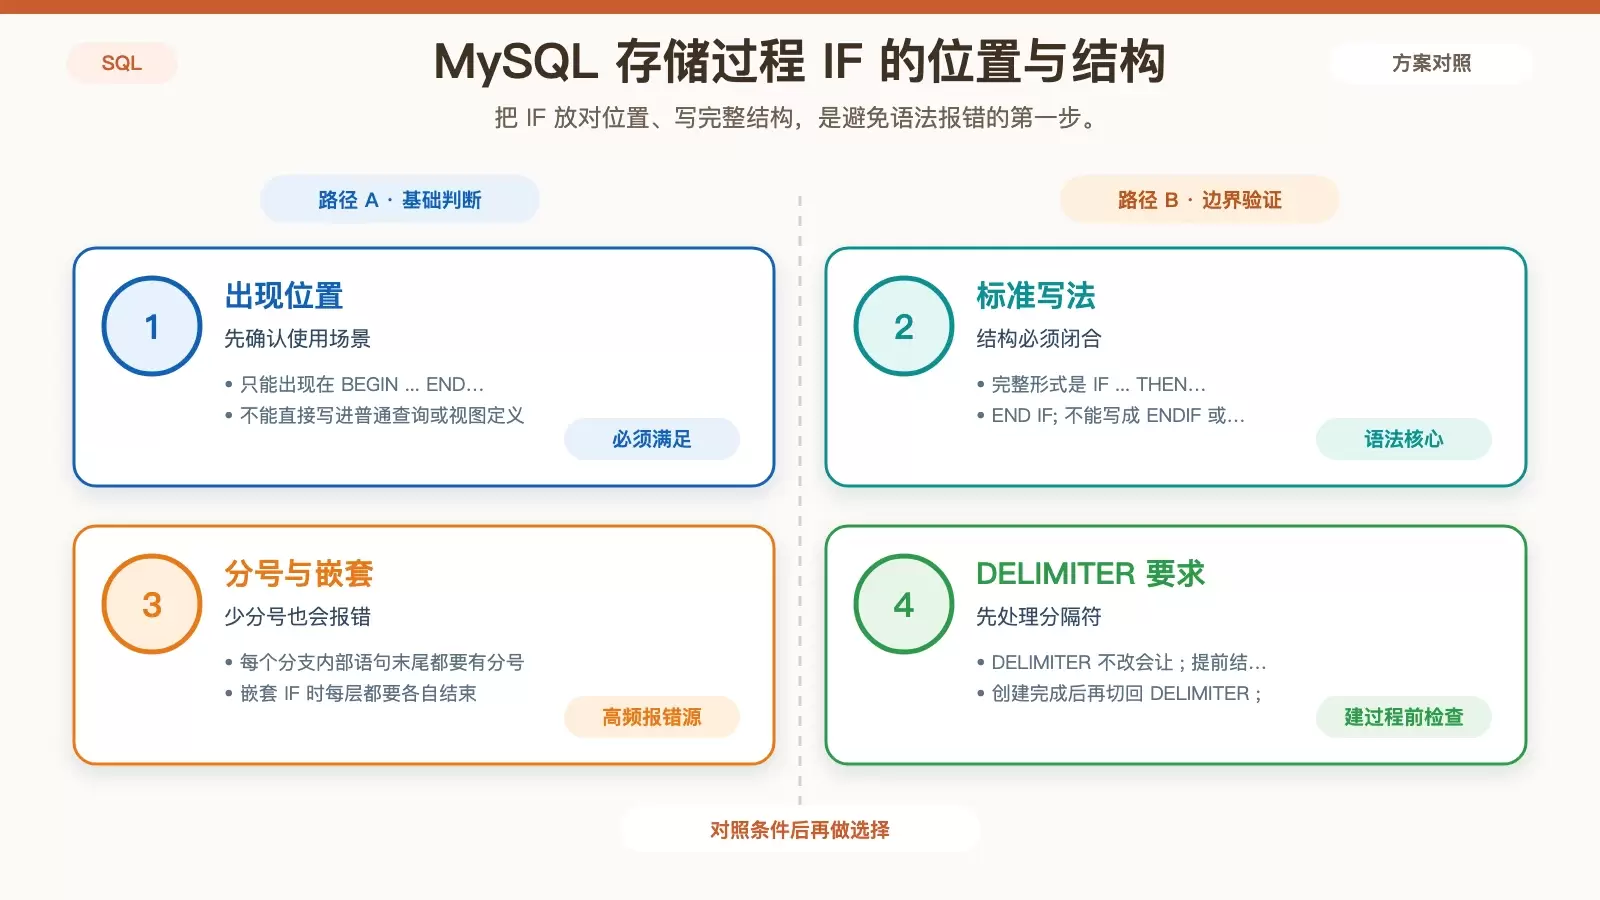
MySQL 存储过程里的 `IF` 不是查询里的函数表达式,而是只能写在 `BEGIN ... END` 内的流程控制语句。本文按语法位置、分支写法、`NULL` 与浮点比较、常见报错几个维度梳理易错点,帮你快速判断 `ERROR 1064`、`ERROR 1339` 到底错在什么地方。
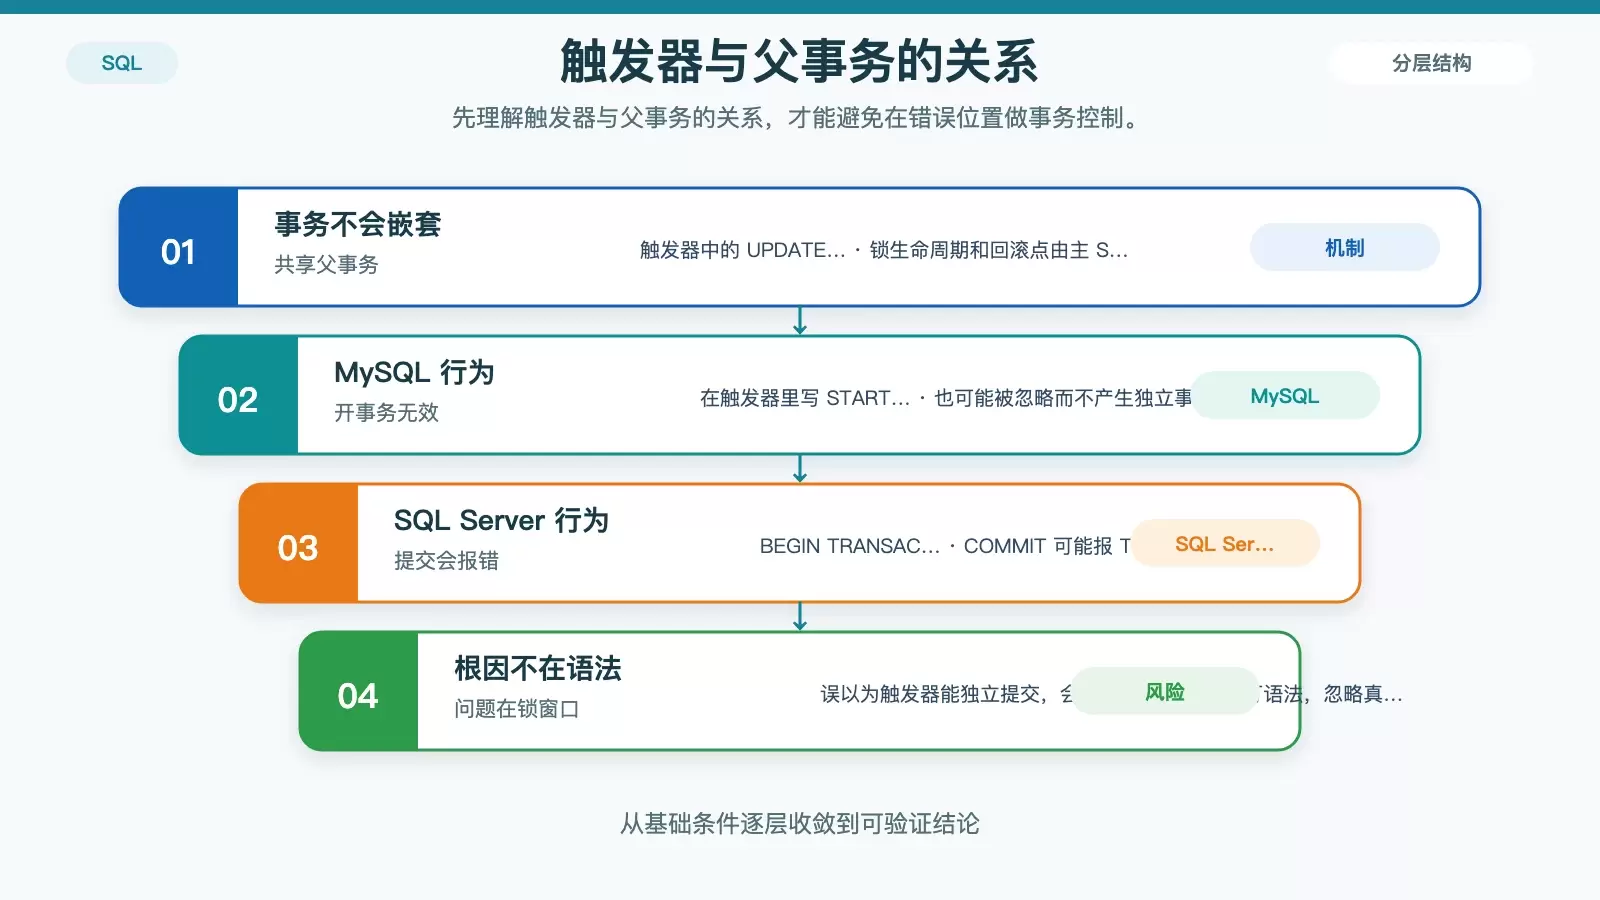
在 MySQL 和 SQL Server 里,DML 触发器并不会开启独立事务,而是直接运行在父事务上下文中。要减少死锁和锁等待,关键不在触发器里“补事务”,而在主事务开头预加锁、让触发器内 DML 只走唯一索引,并把非核心跨表操作尽量移出事务边界。
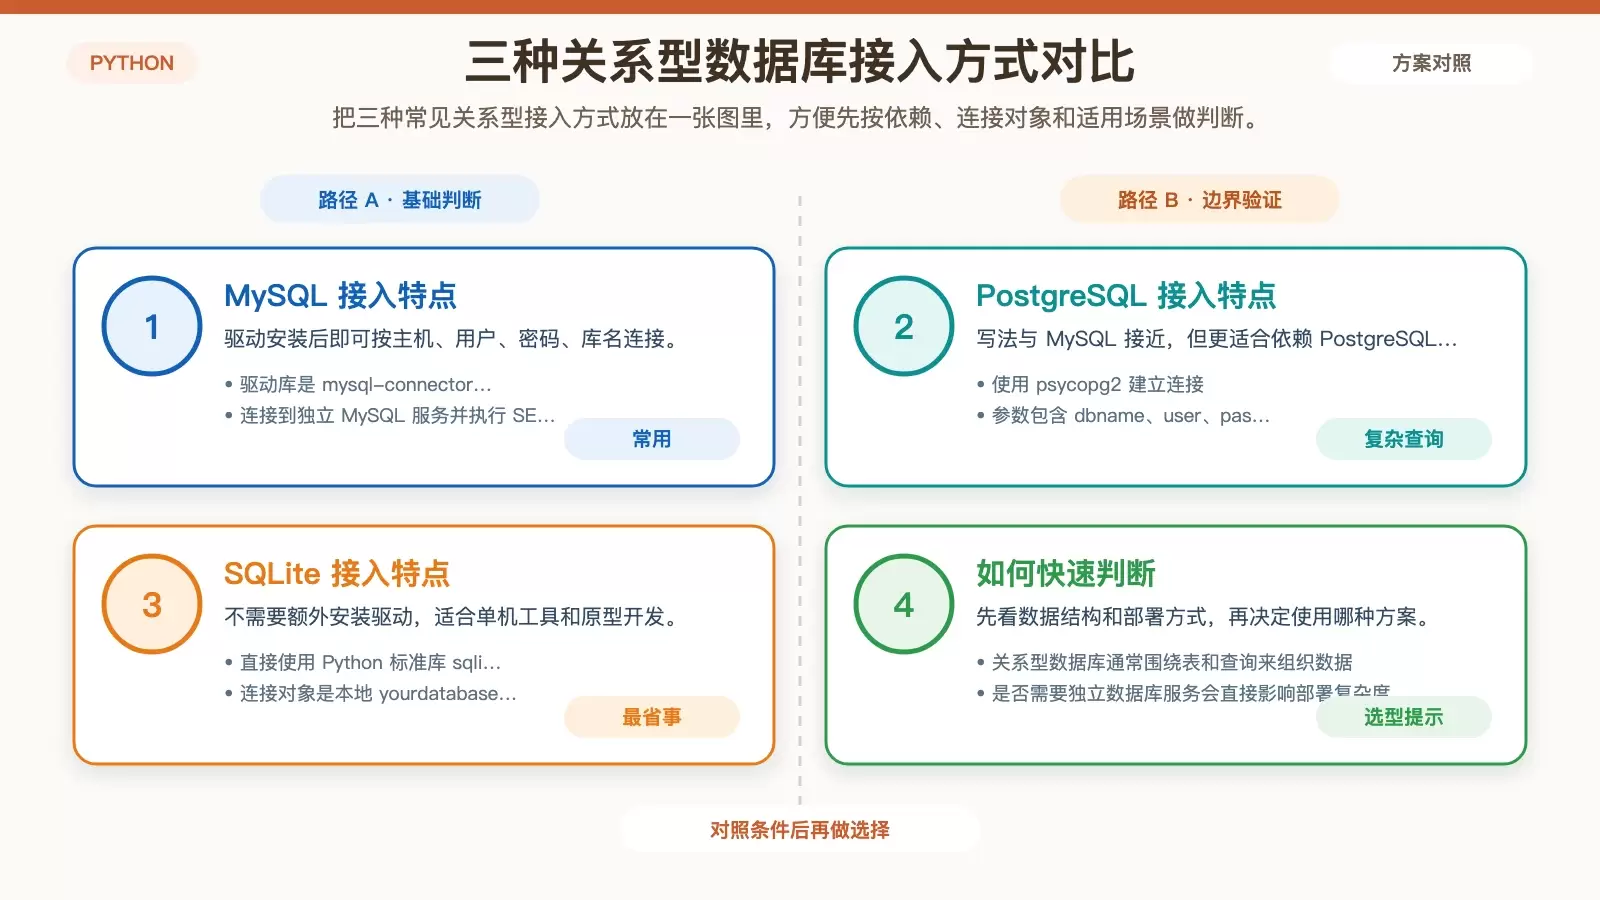
这篇文章按数据库类型梳理 Debian 下 Python 的常见连接方式,覆盖 MySQL、PostgreSQL、SQLite、MongoDB 和 Redis。除了保留原始安装命令与示例代码,还补充了选型思路和连接时最容易出错的配置检查点。 在 Debian 上用 Python 接数据库,难点通常不在“能不能连上”,而在于不同数据库的驱动、连接对象和使用场景差别很大。