


批量写入数据时,最常见的翻车点不是语法,而是“重复键出现后数据库到底会怎么处理”。同样是想跳过已存在记录,MySQL、PostgreSQL 和 SQL Server 给出的方案完全不是一个重量级:有的可以静默忽略,有的必须明确冲突目标,还有的本质上是在做匹配驱动操作。
这篇文章按“只插入新数据、重复就跳过”的真实需求来拆解,分别说明三种主流数据库该怎么写、各自会付出什么代价,以及为什么有些看似能用的写法其实更容易引入锁等待和死锁。读完后,你可以直接判断当前场景该选哪条语句,而不是只追求“不报错”。
先判断:你要的是静默跳过,还是冲突后更新
很多人把“避免主键冲突”理解成“别让 SQL 报错”,但在批量插入场景里,更重要的是先分清需求:
- 如果目标是只插入新数据,已存在记录直接跳过,应该优先选择真正的“忽略冲突”语义。
- 如果目标是冲突后顺便更新字段,那就是另一类问题,语句的锁行为和性能代价都会明显上升。
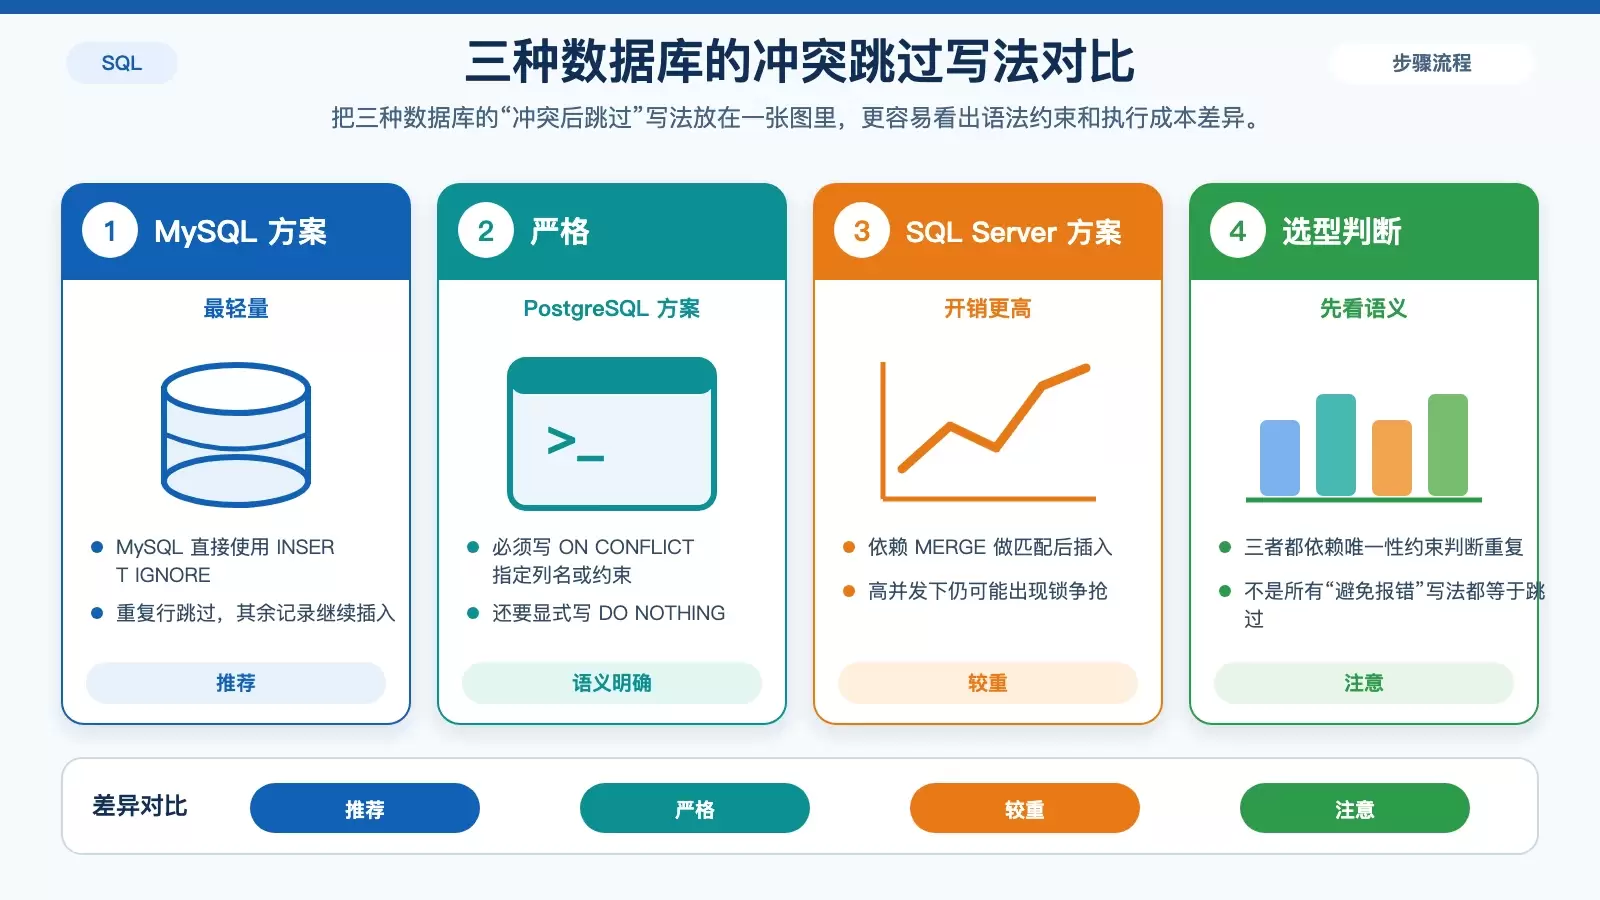
就这个需求而言,三类数据库的常见方案可以先这样理解:
- MySQL:
INSERT IGNORE最直接,适合“插入新数据,重复就跳过”。 - PostgreSQL:用
ON CONFLICT (...) DO NOTHING,语法更严格,但控制更明确。 - SQL Server:通常只能靠
MERGE模拟,能做,但不算轻量。
MySQL:用 INSERT IGNORE 跳过重复行
在 MySQL 中,INSERT IGNORE 是处理主键或唯一索引冲突时最轻量、最直接的方式。它的特点很明确:不报错、不更新、重复行直接忽略,其余行继续插入。
什么情况下适合用
当目标表存在 PRIMARY KEY 或 UNIQUE 索引,并且你的需求只是“新数据进表,重复数据跳过”时,INSERT IGNORE 基本就是首选。
如果你直接执行裸 INSERT,常见报错会是:
ERROR 1062 (23000): Duplicate entry 'xxx' for key 'PRIMARY'这说明当前语句没有任何冲突容错能力。
写法和执行效果
INSERT IGNORE INTO users (id, name) VALUES (1,'Alice'),(2,'Bob'),(1,'Charlie');在这条语句里,第二个 (1,'Charlie') 会因为主键冲突被直接跳过,不报错,也不会插入;其他不冲突的记录仍会成功写入。
它能忽略什么,不能忽略什么
INSERT IGNORE 只会忽略由唯一键或主键冲突引发的问题,这一点很容易被误解。下面这些错误并不会被它“顺手处理掉”:
- 字段超长
NOT NULL字段插入NULL- 其他不属于唯一性冲突的约束错误
出现这类问题时,整条语句仍然会报错并中止。
如何判断跳过了多少行
实际执行后,可以通过返回值里的 rows affected 观察效果。如果这个数字少于 VALUES 里的输入行数,差值通常就是被忽略掉的重复记录数,适合拿来做批量去重统计。
PostgreSQL:用 ON CONFLICT DO NOTHING 明确指定冲突目标
PostgreSQL 没有 MySQL 那种 IGNORE 语法,但它提供了更显式的写法:ON CONFLICT ... DO NOTHING。这套语法的关键不是“更省事”,而是“必须把冲突依据说清楚”。
核心规则:冲突依据不能省略
在 PostgreSQL 里,你必须明确指定冲突依据,可以是列名,也可以是约束名;同时 DO NOTHING 也不能漏写。
比如,你希望按 email 去重,而表上已经有:
CREATE UNIQUE INDEX idx_users_email ON users(email);那么插入时可以这样写:
INSERT INTO users (id, email) VALUES (1,'a@b.com'),(2,'c@d.com') ON CONFLICT (email) DO NOTHING;更稳妥的写法:显式引用约束名
如果表结构比较复杂,或者担心列名歧义,更稳妥的方式是直接引用约束名:
ON CONFLICT ON CONSTRAINT idx_users_email DO NOTHING这种写法对读代码和维护都更友好,尤其是在唯一性规则不只一条的时候。
两类常见误用
- 漏写
DO NOTHING:语法会直接报错。 - 写成
DO UPDATE SET:这已经不是“跳过冲突”,而是“冲突后更新”。
所以在 PostgreSQL 里,别把“避免报错”和“跳过插入”混成一件事,语义必须写得很清楚。
SQL Server:只能用 MERGE 模拟,但代价更高
SQL Server 没有与 INSERT IGNORE 对应的轻量写法,常见做法是用 MERGE 来模拟“有则跳过、无则插入”。但要注意,MERGE 不是 INSERT 的简单替代,它本质上是匹配驱动型语句。
“只插入不更新”的基本写法
如果你只是想跳过已存在记录,必须把逻辑限制在 WHEN NOT MATCHED THEN INSERT 这一支:
MERGE users AS t USING (VALUES (1,'Alice'),(2,'Bob')) AS s(id,name) ON t.id = s.id WHEN NOT MATCHED THEN INSERT (id,name) VALUES (s.id,s.name);这里的几个约束不能省:
- 源数据要通过
USING (VALUES ...)构造。 - 必须写全
WHEN NOT MATCHED THEN INSERT。 - 不要额外带上
WHEN MATCHED分支,否则容易误触发更新,甚至导致失败。
为什么唯一索引是前提
目标表必须存在唯一索引,例如 id 主键。否则 ON 条件无法保证单行匹配,语句行为会变得不可控。
为什么说它不轻量
和 MySQL 的 INSERT IGNORE 相比,MERGE 涉及匹配扫描和锁资源占用,高并发下仍然可能出现争抢。也就是说,它能实现“跳过”的结果,但做这件事的成本明显更高。
为什么不建议用 ON DUPLICATE KEY UPDATE 来假装“跳过”
很多项目为了图省事,会把“重复就忽略”写成 ON DUPLICATE KEY UPDATE,甚至配上类似 id=id 的伪更新。但这类写法在语义和性能上都不划算。
它不是跳过,而是查找、加锁、可能更新
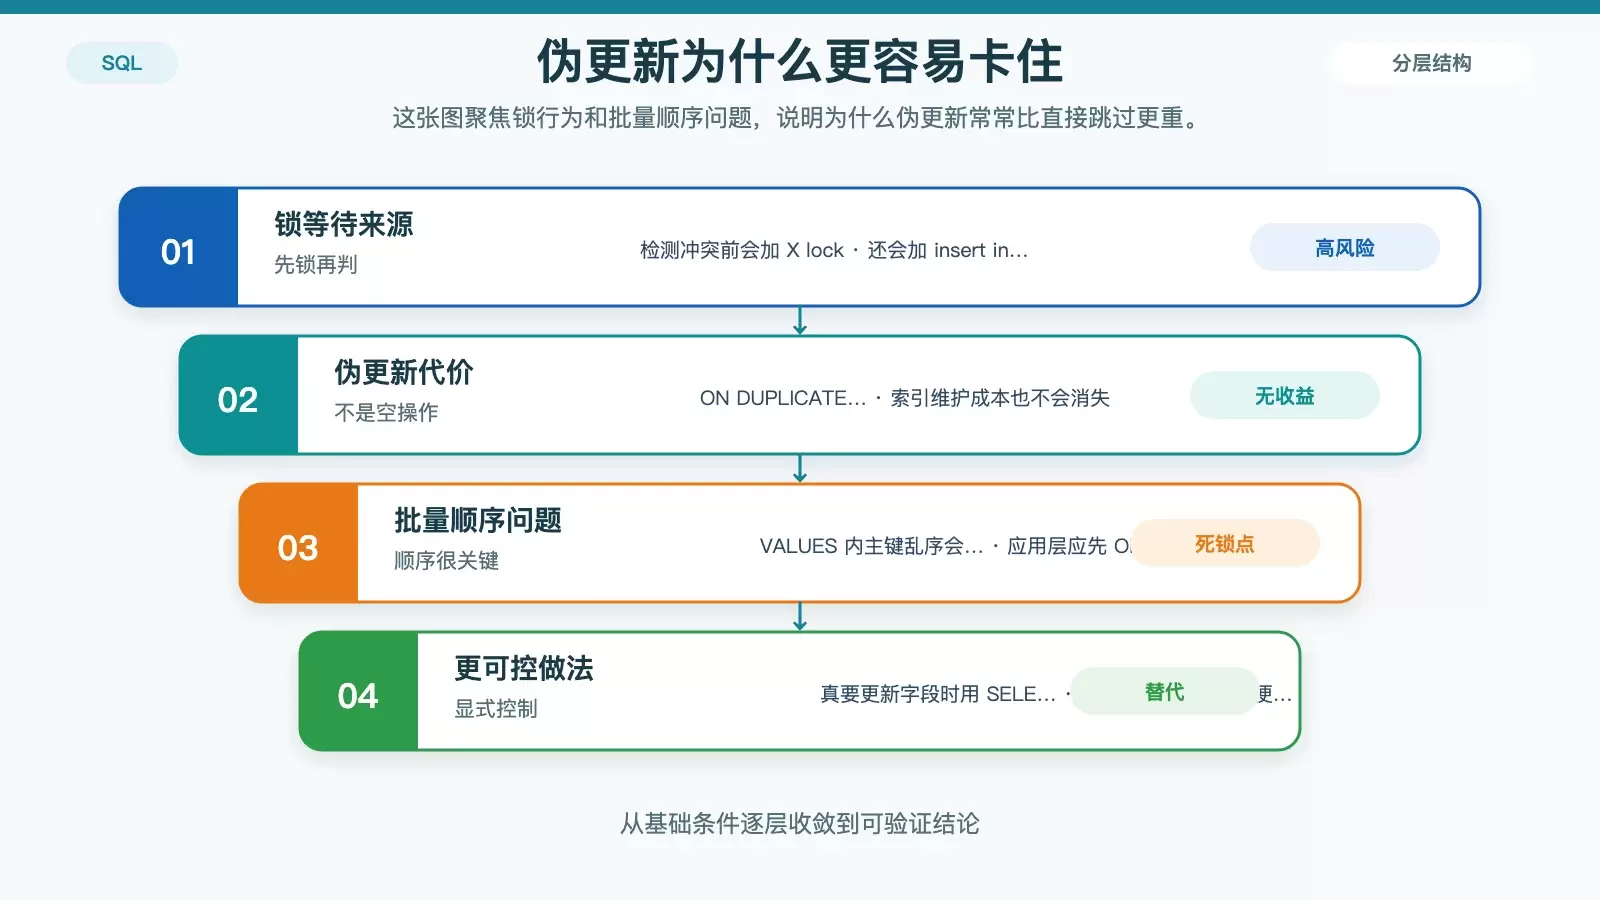
ON DUPLICATE KEY UPDATE 的本质不是忽略冲突,而是“查 + 锁 + 可能更新”。因此,即使你不是真的修改业务字段,它也会带来额外的锁和索引维护成本。
- 主键冲突时之所以可能不报错反而卡住,是因为它会在检测前加
X lock和insert intention lock。 - 多个事务同时插入相同键值时,就可能相互等待。
伪更新没有性能优势
像下面这种写法:
ON DUPLICATE KEY UPDATE id=id看起来像是在“什么都不做”,但实际上仍然会锁行,也仍然会触发索引维护,并不会因为你没有改业务值就自动变轻。
批量插入时还要警惕主键顺序
真正容易在实战中被忽略的,不只是语句选择,还有批量数据本身的顺序问题。批量插入时,如果 VALUES 里的主键是乱序的,InnoDB 间隙锁可能交叉加锁,进而引发死锁风险。
更稳妥的做法是:在应用层提前按主键排序。
ORDER BY id ASC这一步和“用哪条 SQL”一样重要,尤其是在高并发批量导入时。
如果真的需要更新,换成显式控制
如果你的真实需求已经不是“跳过”,而是“发现重复后更新字段”,建议改用显式控制方式,例如:
SELECT ... FOR UPDATE先明确加锁,再执行 UPDATE,整体逻辑通常更可控,也更容易排查锁等待问题。
实战结论:按方言选语句,再检查索引和顺序
把这件事放回实战里,最容易被忽略的其实是两点:批量内部的主键顺序,以及不同数据库方言背后的锁与匹配机制。
- MySQL 的
INSERT IGNORE最适合“只插入新数据、重复直接跳过”的场景。 - PostgreSQL 的
ON CONFLICT ... DO NOTHING更强调显式声明冲突目标,适合需要精确控制的环境。 - SQL Server 的
MERGE能实现类似效果,但别把它当成轻量方案。
另外,别忽视表上的二级唯一索引。对于 PostgreSQL 的 ON CONFLICT 和 SQL Server 的 MERGE 来说,唯一性判断都依赖底层索引结构;一旦额外存在多个唯一约束,就可能引入额外锁竞争。真正稳定的批量插入,不只是“写对一条 SQL”,而是要把语义、索引和数据顺序一起看清楚。









