


在 Debian 环境里,Python 连接数据库并不难,真正容易卡住的往往是“该用哪个驱动”“连接参数怎么写”“不同数据库的调用方式差在哪”。下面按常见数据库逐一拆开说明,保留可直接运行的安装命令和示例代码,同时补出适用场景与排错重点,方便你快速判断该怎么接入。
MySQL:适合常见 Web 业务的关系型连接方式
如果目标数据库是 MySQL,常见做法是使用 mysql-connector-python。先安装驱动:
pip install mysql-connector-python建立连接、执行查询和读取结果的基本写法如下:
import mysql.connector

mydb = mysql.connector.connect(
  host="localhost",
  user="yourusername",
  password="yourpassword",
  database="yourdatabase"
)

mycursor = mydb.cursor()
mycursor.execute("SELECT * FROM yourtable")
myresult = mycursor.fetchall()

for x in myresult:
  print(x)
这里的 yourusername、yourpassword、yourdatabase 都需要替换成真实配置。对于 Debian 上的本地开发环境,host="localhost" 是最常见的起点;如果数据库部署在远端服务器,还要一并确认主机地址、端口和访问权限。
PostgreSQL:适合更复杂查询和严谨数据场景
连接 PostgreSQL 时,Python 里最常见的驱动是 psycopg2。安装命令如下:
pip install psycopg2基本连接示例如下:
import psycopg2

conn = psycopg2.connect(
    dbname="yourdatabase",
    user="yourusername",
    password="yourpassword",
    host="localhost"
)

cur = conn.cursor()
cur.execute("SELECT * FROM yourtable")
rows = cur.fetchall()

for row in rows:
    print(row)
这类写法和 MySQL 非常接近,核心区别主要在驱动库和连接参数名称。若项目本身就依赖 PostgreSQL 的复杂查询能力、事务处理或更严格的数据约束,这套方案通常更合适。
SQLite:无需额外安装,适合轻量项目和原型验证
如果只是本地工具、小型应用,或者想快速做功能原型,SQLite 往往是最省事的选择。Python 标准库自带 sqlite3,不需要额外安装:
import sqlite3

conn = sqlite3.connect('yourdatabase.db')
cursor = conn.cursor()
cursor.execute("SELECT * FROM yourtable")
rows = cursor.fetchall()

for row in rows:
    print(row)
和前面的网络数据库不同,SQLite 直接操作本地数据库文件 yourdatabase.db。这意味着部署简单、依赖少,但也更适合单机、轻量、低并发场景。
MongoDB 与 Redis:一个偏文档存储,一个偏缓存读写
MongoDB 连接方式
如果使用 MongoDB,需要安装 pymongo:
pip install pymongo连接和读取集合文档的示例如下:
from pymongo import MongoClient

client = MongoClient("mongodb://localhost:27017/")
db = client["yourdatabase"]
collection = db["yourcollection"]

documents = collection.find()
for document in documents:
    print(document)
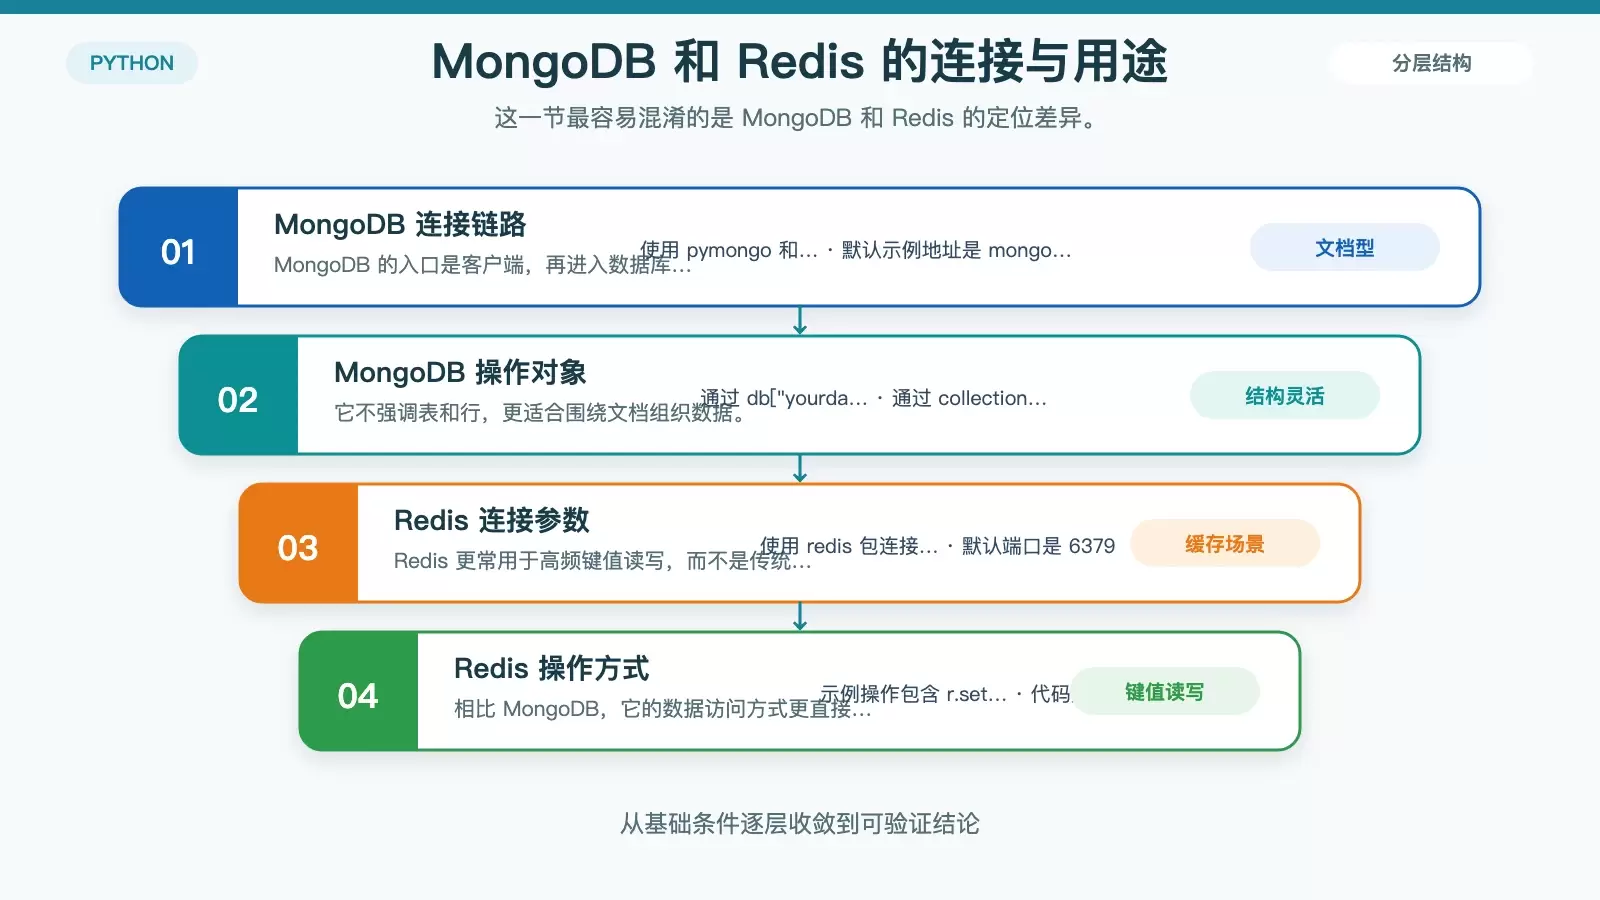
MongoDB 使用文档模型,和传统关系型数据库的表结构思路不同。你不再是通过表和行来组织数据,而是围绕数据库、集合和文档来操作,因此在结构灵活的业务里会更直观。
Redis 连接方式
如果目标是缓存、会话、计数器这类高频读写场景,Python 一般使用 redis 包:
pip install redis基本读写示例如下:
import redis

r = redis.Redis(host='localhost', port=6379, db=0)
r.set('yourkey', 'yourvalue')
value = r.get('yourkey')
print(value)
这里需要特别留意端口参数,Redis 默认端口是 6379。如果 Debian 上的 Redis 改过配置,代码里的 port=6379 也要同步调整。
怎么选:先看数据模型,再看部署复杂度
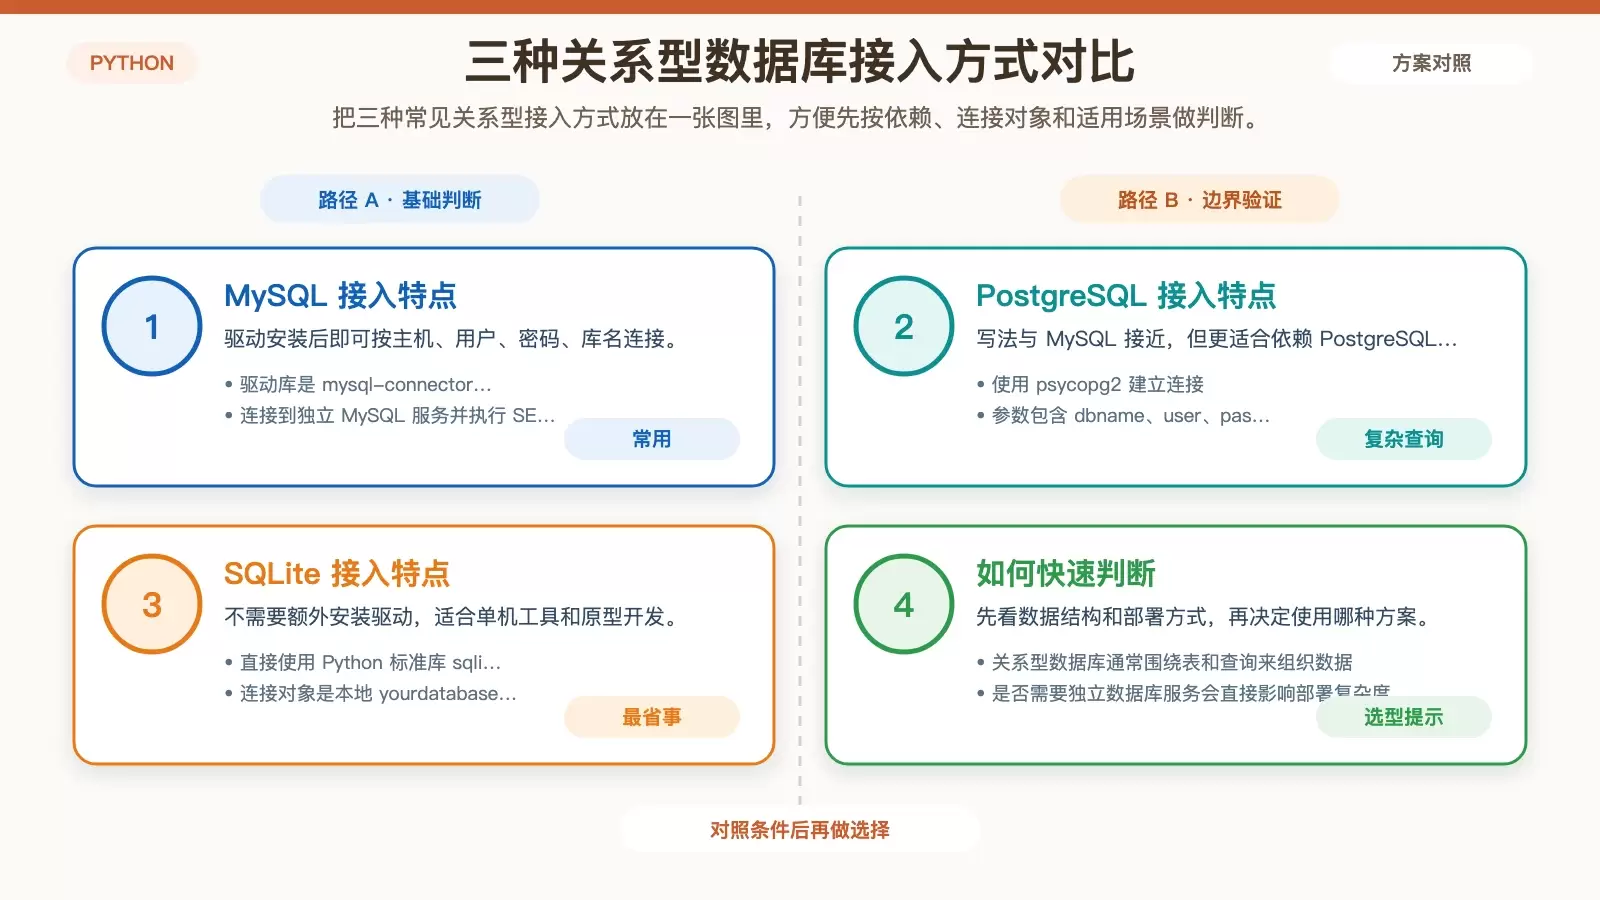
从接入难度来看,SQLite 最轻,适合快速起步;MySQL 和 PostgreSQL 适合标准关系型业务;MongoDB 更适合文档型数据;Redis 通常不是主存储,而是承担缓存或高频键值读写任务。
如果你面对的是一个新项目,可以先从这几个问题判断:
- 数据是规则表结构,还是灵活文档结构?
- 是本地单机使用,还是要连接独立数据库服务?
- 需要的是持久化业务数据,还是高频缓存访问?
把这几个问题想清楚,再选 Python 驱动和连接方式,后面的代码实现会顺畅很多。
连接数据库前,先检查这三件事
1. 依赖库是否已经安装
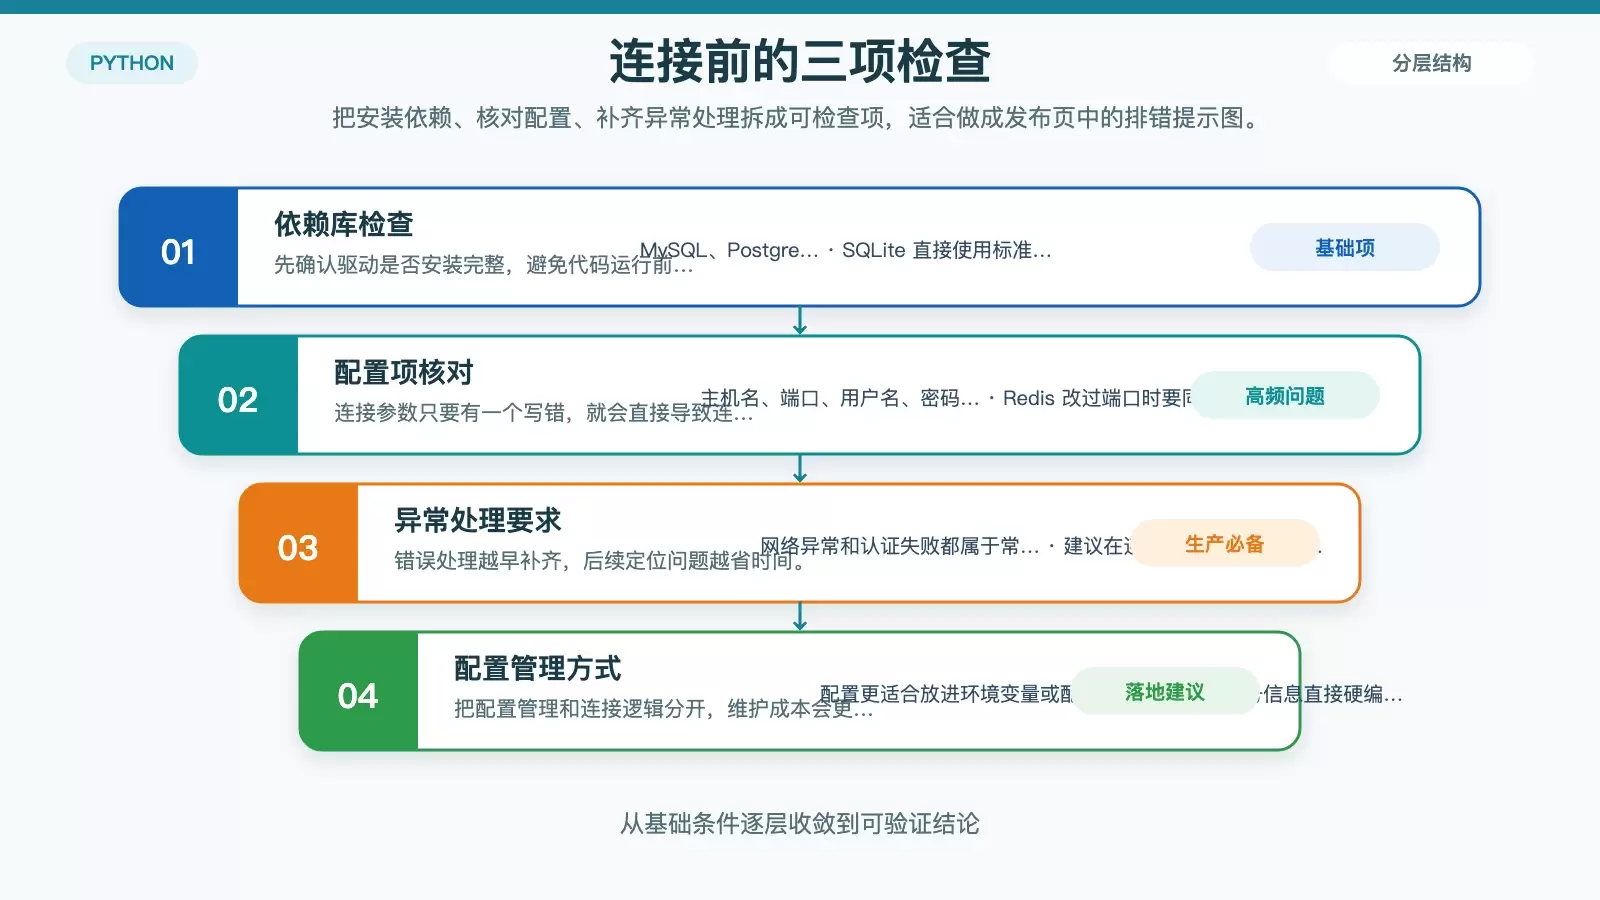
最常见的问题就是代码写好了,但忘了先执行 pip install。MySQL、PostgreSQL、MongoDB 和 Redis 都依赖额外 Python 包,只有 SQLite 可以直接使用标准库。
2. 连接参数是否准确
主机名、端口、用户名、密码、数据库名,这几个参数只要错一个,连接就会失败。实际项目中更建议把这些配置放进环境变量或配置文件,而不是直接硬编码在脚本里。
3. 错误处理是否补齐
到了生产环境,网络异常、认证失败、超时、中间件不可达都很常见。即便只是简单脚本,也建议在数据库连接和查询位置补上 try-except,这样排查问题会快很多。
如果只是想在 Debian 上快速打通 Python 与数据库之间的链路,上面几组示例已经覆盖了大多数常见场景。下一步要做的,就是根据你的数据库类型替换对应驱动、连接参数和查询语句,再把异常处理和配置管理补完整。









