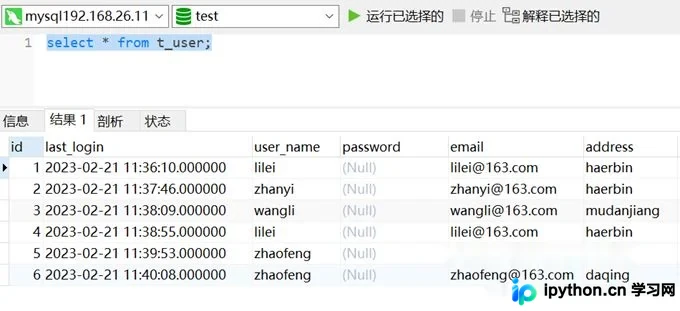
MySQL去重查询的三种方法:distinct、group by与row_number()
在处理MySQL数据库时,如何高效剔除重复数据是常见的SQL优化问题。本文详细解析并演示三种主流去重方案:适用于基础场景的DISTINCT语句、利用聚合逻辑的GROUP BY方法,以及针对复杂需求的窗口函数ROW_NUMBER()(含MySQL 8.0+与5.7及以下版本的差异写法)。通过真实代码示例帮助开发者选择最佳策略。
2026-10-15
6

在处理MySQL数据库时,如何高效剔除重复数据是常见的SQL优化问题。本文详细解析并演示三种主流去重方案:适用于基础场景的DISTINCT语句、利用聚合逻辑的GROUP BY方法,以及针对复杂需求的窗口函数ROW_NUMBER()(含MySQL 8.0+与5.7及以下版本的差异写法)。通过真实代码示例帮助开发者选择最佳策略。
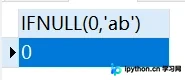
本文详细解析MySQL中处理空值(NULL)的三个常用函数:IFNULL、NULLIF和ISNULL。通过具体代码示例,讲解如何判断字段是否为空、在值相等时返回NULL以及替代默认值,帮助开发者更精准地控制数据查询结果。
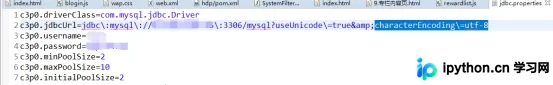
MySQL中存入中文变成问号,通常由客户端连接未指定字符集或数据库服务端编码非UTF-8引起。首先需在JDBC URL中添加useUnicode=true&characterEncoding=UTF-8,并检查Web应用的编码过滤器。其次进入MySQL命令行检查变量,若为latin1,需修改配置文件加入character-set-server=utf8mb4并重启服务。全程确保路径、参数准确即可彻底解决中文乱码问题。
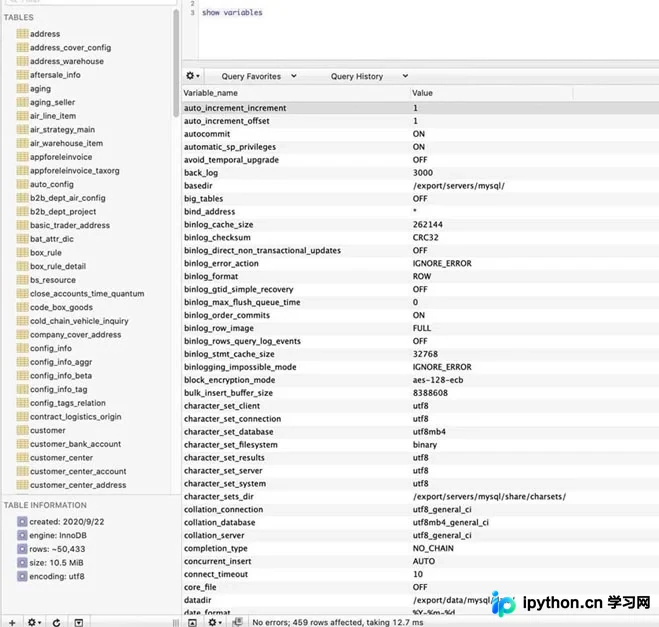
本文汇总了MySQL数据库常用运维命令,涵盖查看当前连接的客户端、服务器版本、最大及活跃连接数等核心指标。通过解析show variables、show status及information_schema表结构,帮助管理员准确定位数据库编码、空间占用及用户权限问题,确保系统稳定运行。
本文详细介绍了基于 CentOS 5.6 和 MySQL 5.5.8 环境的一主一从复制配置流程。涵盖从机与从机的 my.cnf 参数设置、授权复制用户、数据初始化同步以及 slave 状态监控与故障修复等关键步骤,帮助实现数据库的读写分离或容灾备份。
本文详解基于 MySQL 自带命令的监控方案,涵盖连接数、缓冲池命中率、锁等待、语句统计及吞吐量等七大核心维度。同时深入解析慢查询日志的配置流程,结合 mysqldumpslow 工具提供 SQL 优化的具体案例,帮助运维人员低成本获取关键性能数据并定位瓶颈。
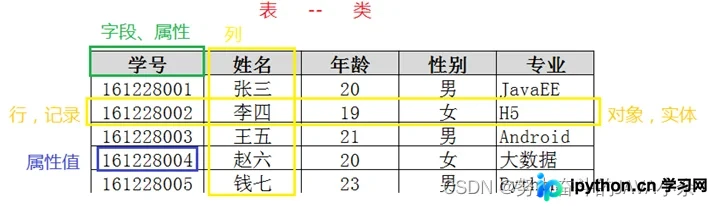
本文深入解析MySQL中的数据完整性、约束类型(主键、自增、唯一、非空、默认、外键)及索引机制。阐述关系型数据库设计原则,通过具体SQL语句演示如何创建和管理各类约束,并结合实际业务场景讲解外键关联与级联操作,帮助开发者规范数据库设计并提升查询性能。
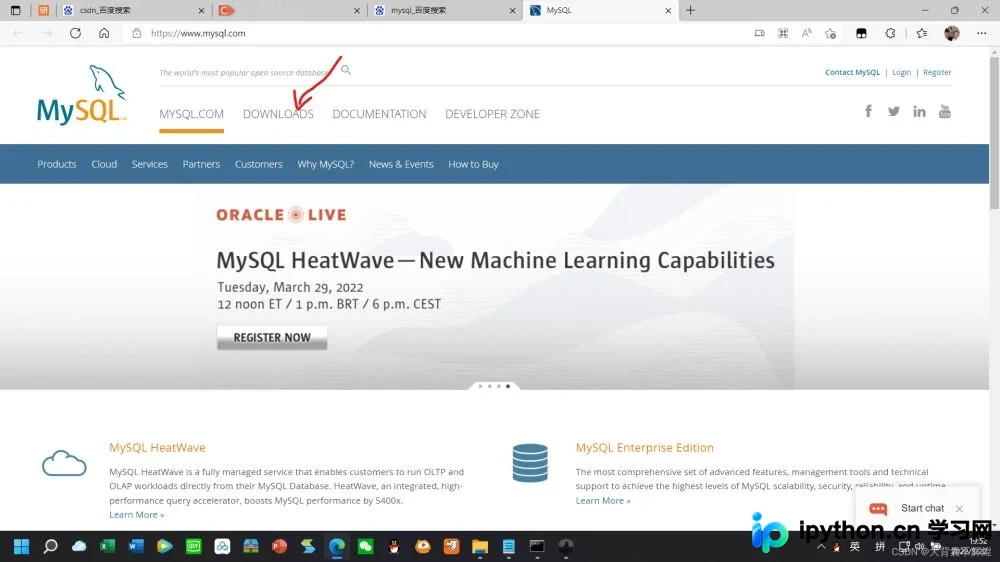
本文详细介绍了在 Windows 64位系统上安装 MySQL 8.0.28 的步骤。从官网下载社区版安装包开始,演示了 Developer Default 模式的全流程安装、设置 root 密码,以及配置系统环境变量以支持命令行直接调用。最后通过 cmd 测试验证安装是否成功。
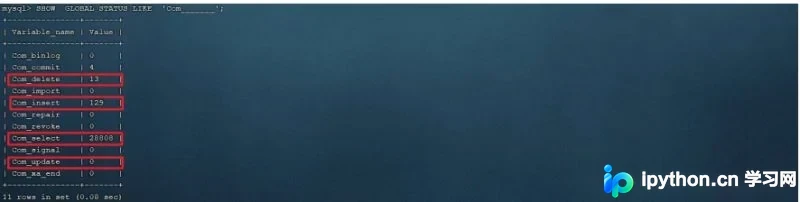
本文详解如何定位并优化MySQL中的低效SQL。通过开启慢查询日志记录超过阈值的语句,结合SHOW GLOBAL STATUS评估负载类型;利用SET profiling开启会话级性能剖析,精准定位耗时环节,为索引优化提供数据支撑。
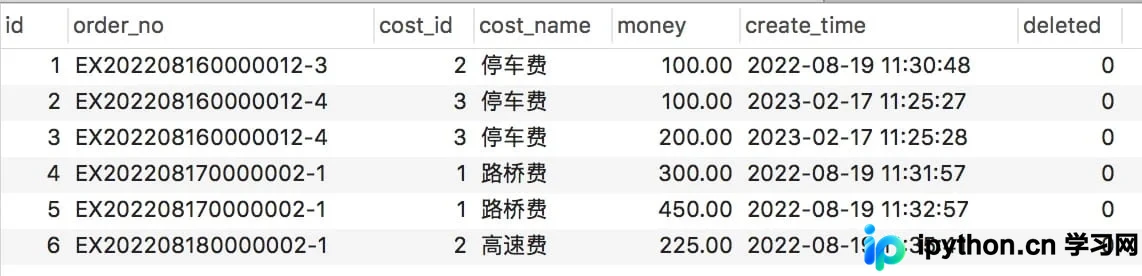
本文针对 MySQL 数据库中因业务 Bug 产生的重复脏数据,提供一种在保留“deleted”逻辑删除标记前提下,清理冗余记录并仅保留最新一条数据的方法。通过构建中间表规避 “You can't specify target table for update in FROM clause” 错误,实现高效的数据清洗。
本文总结了六条实用的MySQL SQL操作语句,涵盖通过生日计算年龄、获取两个时间点的时间差、统计字段出现次数、计算工作日天数以及查询表主键和数据库占用空间。这些示例帮助初学者快速掌握常用的数据处理与运维查询技巧。
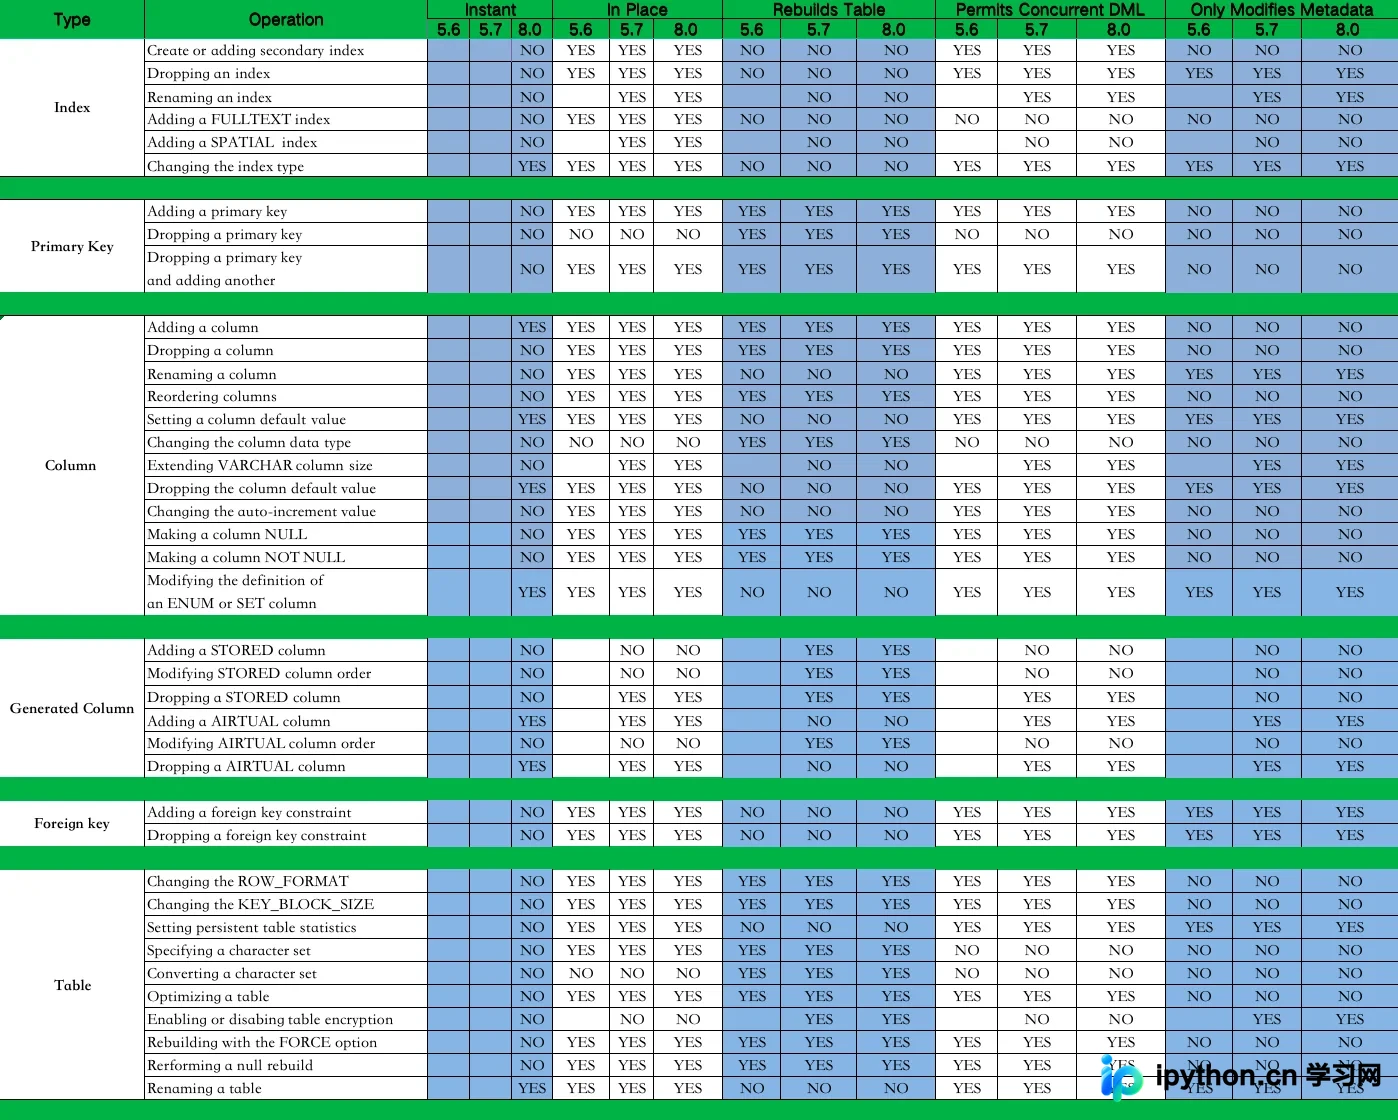
面对亿级数据的大表字段扩容需求,直接OnlineDDL可能阻塞业务。本文基于MySQL 8.0环境,详细演示如何利用M-S1-S2级联复制架构,在从库S2执行OnlineDDL以规避主库压力,并通过平滑切换实现零停机或短时停服的数据变更。涵盖参数调优、GTID验证及故障回退要点。