

MySQL 数据库监控:7大核心指标与慢查询排查指南

面对 MySQL 数据库的复杂运行环境,选择低损耗且精准的监控方式是保障业务稳定的关键。本文详细介绍如何利用 MySQL 自带的 `SHOW STATUS` 和 `SHOW VARIABLES` 命令,从连接数、缓存命中率、锁竞争、SQL 执行量及网络吞吐七个维度构建轻量级监控体系。此外,文章还系统梳理了慢查询日志(Slow Log)的配置步骤,演示如何通过 mysqldumpslow 分析高频耗时 SQL,并提供去重索引、避免函数失效等实用的性能优化手段。
结果或目标:建立轻量级全维监控体系
不同于昂贵的商业监控软件,利用 MySQL 原生指令可以零成本获取最核心的运行时数据。通过定期采集以下指标,能够快速掌握数据库的健康状态,并在异常发生初期进行干预。
准备条件
- 权限要求:操作账号需具备数据库的全局访问权限,以便执行
SHOW GLOBAL STATUS和SHOW GLOBAL VARIABLES。 - 引擎基础:默认以 InnoDB 作为监控示例,若使用其他存储引擎,相关参数可能存在差异。
- 客户端连接:确保能通过命令行或图形化工具连接到目标数据库实例。
真实操作顺序:七大核心监控维度
第一步:检查连接数(Connects)状况
目的:评估数据库承载能力,防止连接耗尽导致服务不可用。
- 最大历史并发连接数:查看自启动以来达到的峰值。
SHOW STATUS LIKE 'Max_used_connections';- 当前活跃连接数:了解当前的实时负载压力。
SHOW STATUS LIKE 'Threads_connected';第二步:分析缓冲池命中率(BufferCache)
目的:判断 InnoDB 内存分配是否合理,数据读取是否充分命中内存。
- 未命中缓冲池的物理读次数:数值越低越好,表示直接从磁盘读取的次数少。
SHOW STATUS LIKE 'Innodb_buffer_pool_reads';- 缓冲池逻辑读请求总数:发起的所有读取请求。
SHOW STATUS LIKE 'Innodb_buffer_pool_read_requests';- 计算命中率:公式为
(1 - Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests) * 100%,一般建议维持在 95%~99% 以上。 - 缓冲池容量利用率:通过总页数与空闲页数计算。
公式:((Innodb_buffer_pool_pages_total - Innodb_buffer_pool_pages_free) / Innodb_buffer_pool_pages_total) * 100%
-- 查看总页数
SHOW STATUS LIKE 'Innodb_buffer_pool_pages_total';
-- 查看空闲页数
SHOW STATUS LIKE 'Innodb_buffer_pool_pages_free';
第三步:监测锁竞争(Lock)
目的:发现潜在的阻塞问题,识别死锁风险。
- 行锁等待累计次数:这是一个累加值,对比两次采样数据的差值,即为新增的锁竞争情况。
SHOW STATUS LIKE 'Innodb_row_lock_waits';- 平均每次锁等待时间:反映锁资源的稀缺程度。
SHOW STATUS LIKE 'Innodb_row_lock_time_avg';- 表级锁检测:如果返回数据非空,说明存在正在被使用的表锁(表级别锁定会导致该表大部分操作阻塞)。
SHOW OPEN TABLES WHERE In_use > 0;第四步:统计 DML 语句执行量(Statement)
目的:掌握数据库的事务特征,用于估算资源消耗趋势。
SHOW STATUS LIKE 'Com_insert';  -- Insert 写入量
SHOW STATUS LIKE 'Com_delete';  -- Delete 删除量
SHOW STATUS LIKE 'Com_update';  -- Update 更新量
SHOW STATUS LIKE 'Com_select';  -- Select 查询量
第五步:追踪网络吞吐量(Throughputs)
目的:监控带宽使用情况,排查大量数据传输带来的 IO 瓶颈。
- 发送与接收总量:单位为字节。
SHOW STATUS LIKE 'Bytes_sent';
SHOW STATUS LIKE 'Bytes_received';
总吞吐量约为两者之和。
第六步:确认服务器配置参数(ServerConfig)
目的:核对当前运行的关键变量是否与预期一致。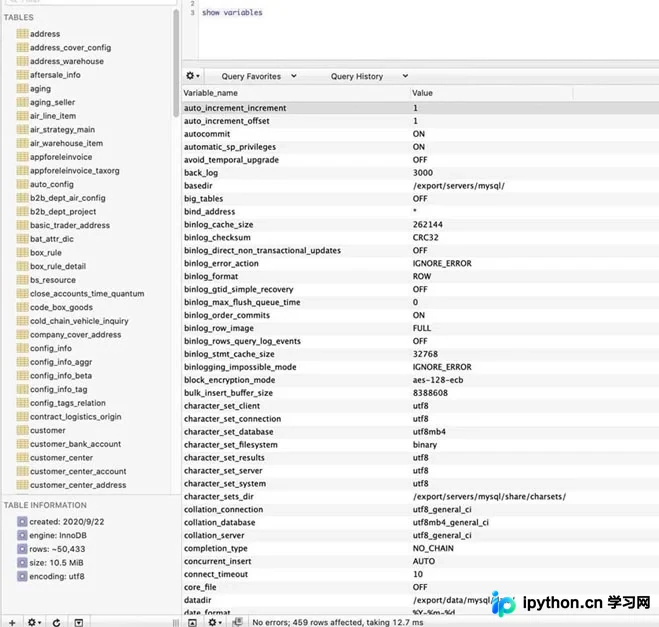
第七步:配置并排查慢 SQL(Slow Queries)
目的:精准定位耗时最长的 SQL 语句,这是性能优化的突破口。慢 SQL 定义为执行时间超过阈值(long_query_time)的语句。
第1步:开启慢查询日志
首先确认开关状态并开启:
SHOW VARIABLES LIKE 'slow_query_log';
-- 动态开启(重启后失效)
SET GLOBAL slow_query_log = 1;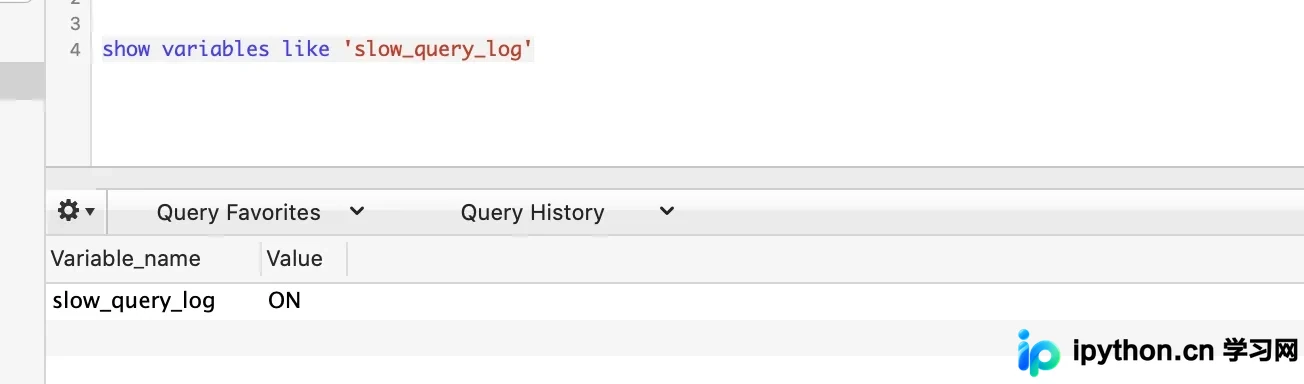
第2步:设置阈值(Long Query Time)
定义多少秒以上的 SQL 算作“慢”。默认通常为 10 秒,可根据业务容忍度调整(单位:秒)。
SHOW VARIABLES LIKE 'long_query_time';
-- 例如设置为 1 秒
SET GLOBAL long_query_time = 1;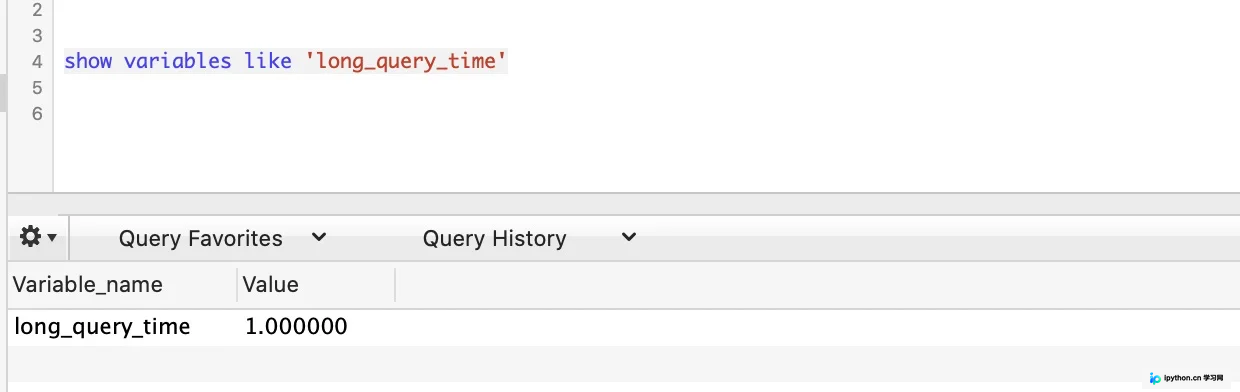
第3步:确认日志文件路径
找到生成的日志文件位置,后续分析将针对此文件。
SHOW VARIABLES LIKE 'slow_query_log_file';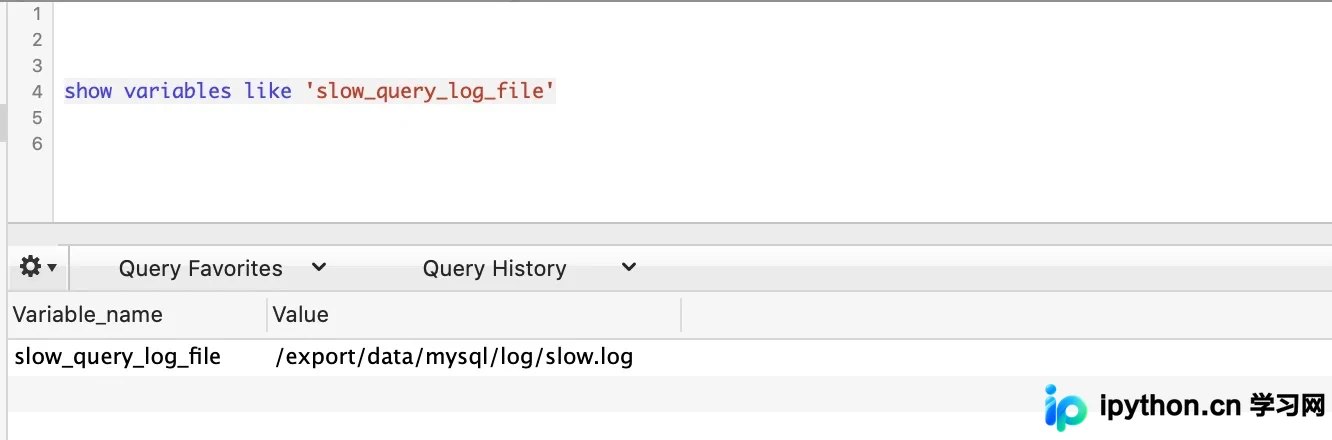
第4步:格式化分析慢 SQL 日志
直接使用文本编辑器查看原始日志较为困难,推荐使用 MySQL 自带的 mysqldumpslow 工具进行聚合分析。注意该命令仅在服务器端或安装 MySQL 的环境命令行中有效。
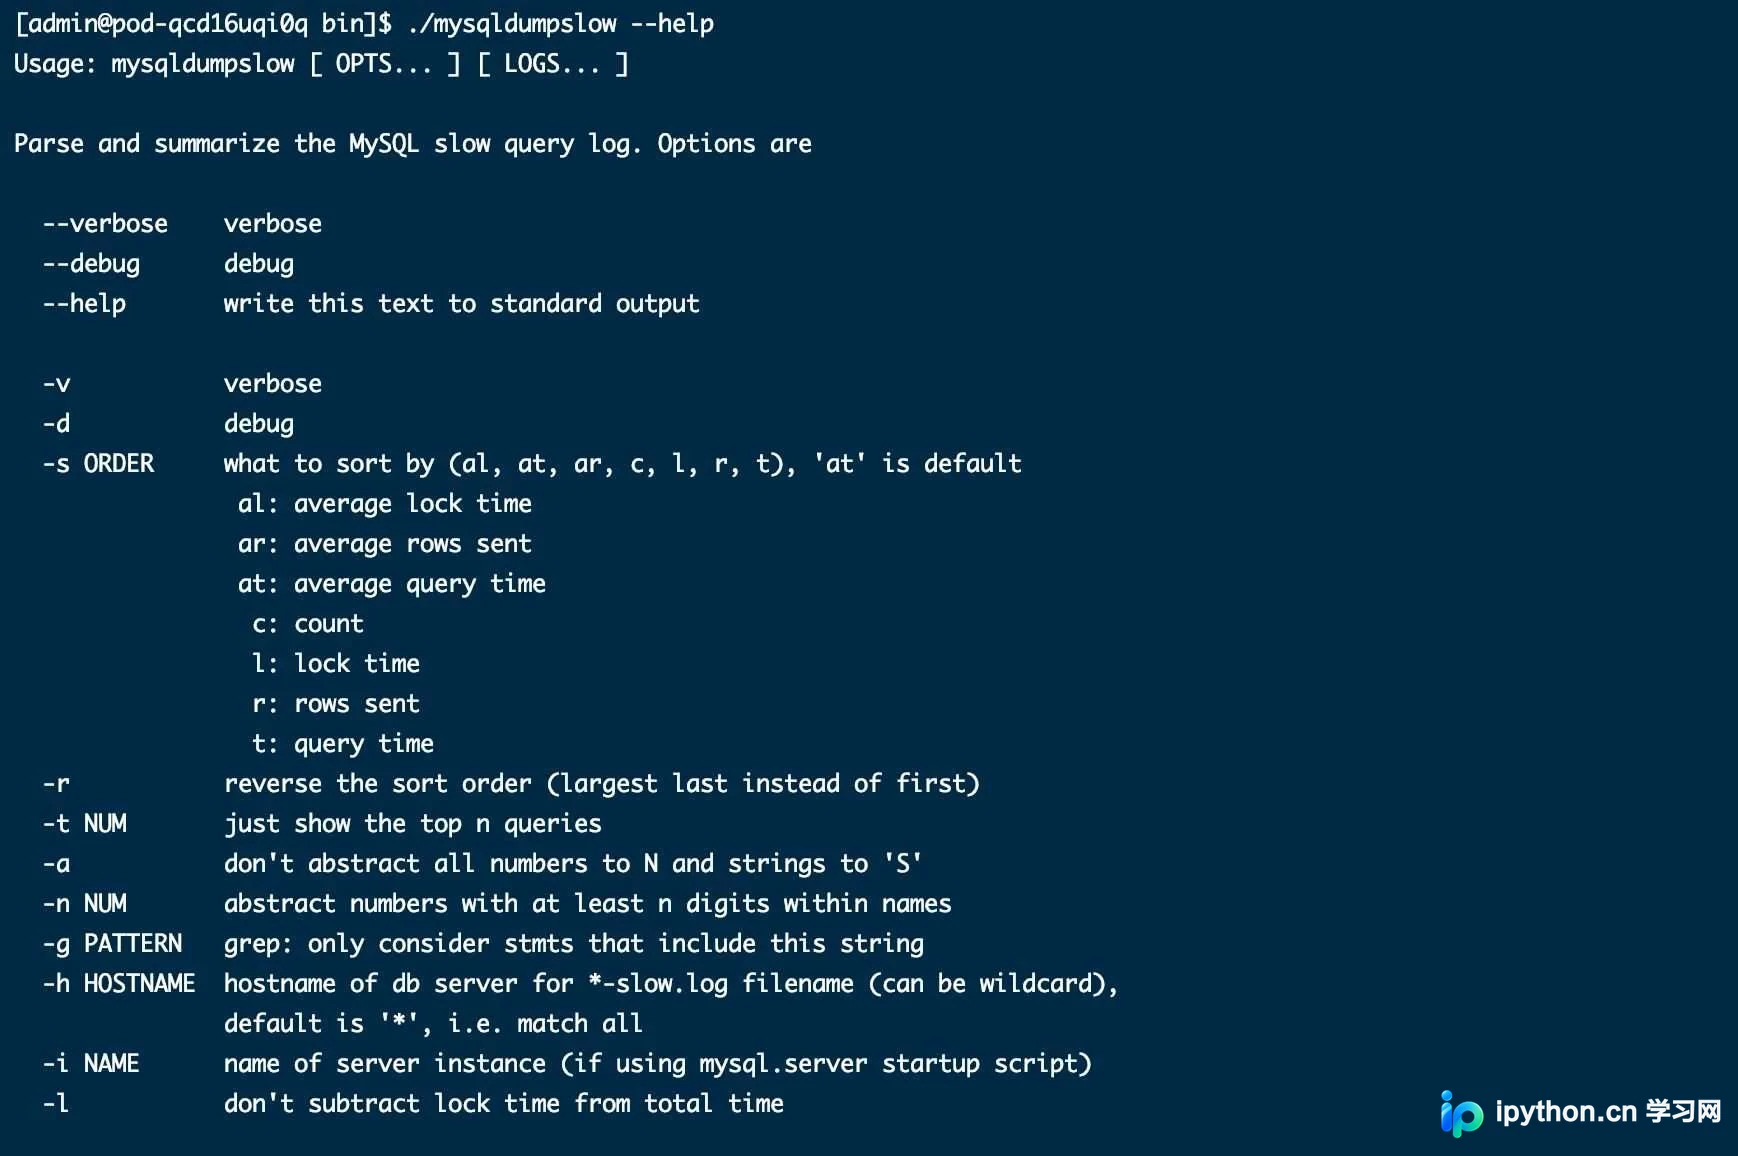
常用命令示例:
- 查看调用频率最高的前 N 条慢 SQL:
./mysqldumpslow -s c -t 10 /path/to/slow.log - 查看执行时间最慢的前 N 条慢 SQL:
./mysqldumpslow -s t -t 10 /path/to/slow.log
输出结果解析:
Count:该类 SQL 的执行次数。Time:平均执行时间及总耗时。Lock:获取锁的时间。Rows:单条 SQL 扫描或返回的平均行数。
注意:mysqldumpslow 会屏蔽具体的参数值,显示结构化的模板(如将 WHERE id=1 替换为 WHERE id=N),因此只能用于分类统计,无法直接用于复制执行。
完成判断与常见慢 SQL 排错优化
通过上述监控与日志分析,找出 Top 5 的高频/高耗时 SQL 并进行优化。以下是几种典型的无效写法及其优化方案:
优化点 1:避免子查询导致的性能倒退
在较老版本中,子查询往往是先查外表再匹配内表。建议改写为 Join 关联。
-- 较慢写法
SELECT * FROM t1 WHERE id IN (SELECT id FROM t2 WHERE name='hechunyang');
-- 优化后
SELECT t1.* FROM t1 JOIN t2 ON t1.id = t2.id;
优化点 2:防止函数操作导致索引失效
对索引列使用函数(如 YEAR, DATE_FORMAT)通常会触发全表扫描。应改为范围查询或使用函数索引(需特定版本支持)。
-- 失效写法:即使 d 字段有索引也不生效
SELECT * FROM t WHERE YEAR(d) >= 2016;
-- 优化后
SELECT * FROM t WHERE d >= '2016-01-01';
优化点 3:IN 替代 OR
当条件为多个相等值时,IN 的执行计划通常比多个 OR 更优。
-- 优化后
SELECT * FROM t WHERE loc_id IN (10, 20, 30);
优化点 4:谨慎使用模糊匹配
左模糊(LIKE '%abc')无法走索引。尽量改为右模糊(LIKE 'abc%'),或者使用搜索引擎解决方案。
优化点 5:减少不必要的数据排序
如果只需要统计数据而不关心最终结果的物理顺序,可以关闭默认排序以提升性能。
-- 添加 ORDER BY NULL 禁止排序
SELECT goods_id, COUNT(*) FROM t GROUP BY goods_id ORDER BY NULL;
简要总结
MySQL 的监控并非越贵越好,掌握核心指标的采集方式才是关键。通过关注连接数、BufferPool 命中率、锁等待以及利用 mysqldumpslow 剖析慢日志,可以在不增加额外服务器负担的前提下,实现对数据库状态的透明化管理。对于发现的慢 SQL,优先考虑索引覆盖、改写查询结构及减少不必要的排序来从根本上解决性能问题。
以上就是 MySQL 数据库的七维监控与慢查询排查的详细内容,更多关于 MySQL 性能调优的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









