

MySQL级联复制下大表字段扩容方案与实操

针对4亿行级别的大表进行字段扩容(如VARCHAR长度调整),直接在主库执行可能导致长时间DML阻塞或资源耗尽。本文介绍一种基于MySQL级联复制(M-S1-S2)的变通方案:利用空闲从库执行OnlineDDL,通过数据一致性与GTID比对完成主从切换,从而将核心变更窗口期压缩至分钟级,大幅降低对线上业务的干扰。
背景与挑战
在某客户场景中,需将约4亿行的表中 open_id 字段从 varchar(50) 扩容至 varchar(500)。该表数据文件超过280GB。由于业务24小时有流量,无法接受长时间的读写阻塞,仅争取到4小时的维护窗口。常见的修改方式包括原生OnlineDDL、gh-ost、pt-online-schema-change (pt-osc) 以及自定义的级联复制切换。
经过评估:
- OnlineDDL: 在主库使用
ALGORITHM=COPY会阻塞DML,且最后Rename阶段不可读写,风险不可控。 - Gh-ost: 虽可通过连接从库减少主库负载,但4亿数据量测试耗时长达70小时,效率难以满足短期窗口要求。
- Pt-osc: 第三方工具,大表操作失败回滚代价极大,且依赖触发器,逻辑复杂。
最终选择“备份恢复+级联复制切换”的方案,即利用多级从库异步执行DDL,待同步完成后进行主从切换,将漫长的DDL时间转移到非关键路径。
前置准备
- 环境检查: 确保Master和级联Slave开启GTID模式。检查磁盘空间,剩余空间需大于待变更表大小的2倍。
- Binlog保留: 为保证足够的时间窗口进行全量备份与恢复,建议延长Binlog过期时间。
SHOW GLOBAL VARIABLES LIKE 'binlog_expire_logs_seconds'; SET GLOBAL binlog_expire_logs_seconds=1209600; -- 设置为14天 - 结构构建: 搭建 M -> S1 -> S2 的级联复制拓扑。注意
lower_case_table_names设置一致性。
第1步:在从库(S2)执行OnlineDDL
此步骤的核心目的是利用从库的IO资源完成耗时最长的数据重建过程,同时保持主库(M)正常对外服务。
1. 配置从库运行参数
为防止因字段定义差异导致复制报错,并优化IO性能,需在S2上执行以下设置:
-- 防止复制报错 SQL_Errno: 13146
SET GLOBAL slave_type_conversions='ALL_NON_LOSSY';
-- 防止超时中断
SET GLOBAL interactive_timeout=144000;
SET GLOBAL wait_timeout =144000;

-- 增加Buffer Pool避免锁表过大报错(根据实际内存调整)
SET GLOBAL innodb_buffer_pool_size=32*1024*1024*1024;
-- 优化刷盘策略以加速DDL
SET GLOBAL sync_binlog=20000;
SET GLOBAL innodb_flush_log_at_trx_commit=2;
-- 提高IO能力上限
SET GLOBAL innodb_io_capacity=600000;
SET GLOBAL innodb_io_capacity_max=1200000;
2. 执行ALTER TABLE
建议使用 screen 或 tmux 挂起会话执行,监控进度:
# 替换 dbname, tablename 及实际socket路径
time mysql -S /data/mysql/3306/data/mysqld.sock -p'' dbname -NBe "ALTER TABLE tablename MODIFY COLUMN open_id VARCHAR(500) NULL DEFAULT NULL COMMENT 'Id' COLLATE 'utf8mb4_bin';"
查看DDL进度:
SELECT EVENT_NAME, WORK_COMPLETED, WORK_ESTIMATED FROM performance_schema.events_stages_current;3. 等待级联同步
DDL完成后,S2上的物理文件已变更。此时需等待 M -> S1 -> S2 的Binlog事件传播完毕,确保S1和S2的逻辑数据(除新字段外)与M一致。可通过比对主从的GTID Executed集合来确认延迟归零。
主从切换与收尾
当S2数据变更后,下一步是将其提升为主库,并将原主库降级或作为新从库。
第2步:移除S1并建立M-S2直连
为了缩短后续切换时的同步距离,先断开S1,让S2直接同步M。
在S1上(可选清理):
STOP SLAVE;
RESET SLAVE ALL;
-- systemctl stop mysql_3306
在S2上:
STOP SLAVE;
RESET SLAVE ALL;
CHANGE MASTER TO
  MASTER_HOST='M主机IP',
  MASTER_USER='replication_user',
  MASTER_PASSWORD='password',
  MASTER_PORT=3306,
  MASTER_AUTO_POSITION=1,
  MASTER_CONNECT_RETRY=10;
START SLAVE;
FLUSH PRIVILEGES; -- 验证是否可正常拉取BINLOG
第3步:利用XtraBackup恢复S1并重新级联
使用S2的全量备份重新初始化S1,使S1成为S2的从库。这样可以将S2的压力分担出去。
在S1服务器上操作:
rm -rf binlog/*
rm -rf redolog/*
# 执行XtraBackup恢复
xtrabackup --defaults-file=/data/mysql/3306/my.cnf.3306 --move-back --target-dir=/data/actionsky/xtrabackup_recovery/data
chown -R mysql. data/
chown -R mysql. binlog/*
chown -R mysql. redolog/*
systemctl start mysql_3306

-- 重置GTID以适配新的复制关系
SET GLOBAL gtid_purged='';
RESET SLAVE ALL;

-- 指向新的主库S2
CHANGE MASTER TO
  MASTER_HOST='S2主机IP',
  MASTER_USER='replication_user',
  MASTER_PASSWORD='password',
  MASTER_PORT=3306,
  MASTER_AUTO_POSITION=1,
  MASTER_CONNECT_RETRY=10;
-- MySQL 8.0 需注意安全连接
SET GLOBAL GET_MASTER_PUBLIC_KEY=1;
START SLAVE;
第4步:应用停服切换与回归
这是唯一的短停服窗口。由于S2已经是M的直接从库且完成了DDL,数据一致性极快达成。
1. 停服准备:在主库M设置只读并停止写入。
SET GLOBAL read_only=ON;
SET GLOBAL super_read_only=OFF; -- 视具体情况,若要做写操作则需关闭,通常此时M即将退役,保持readonly防误改
2. 确认一致:比对M与S2的GTID Executed,完全一致后,停止M的应用线程。
3. 切换主库:将S2提升为新的Master。
STOP SLAVE;
RESET SLAVE ALL;
SET GLOBAL read_only=OFF;
SET GLOBAL super_read_only=OFF;
SHOW MASTER STATUS; -- 观察是否有新事务产生
4. 应用层更新:修改前端连接配置,指向新的主库S2 IP。进行业务回归测试。
参数复原
切换完成后,记得将S2(新主库)上临时调整的DDL相关参数还原,以确保日常生产安全性(如 sync_binlog=1, innodb_flush_log_at_trx_commit=1):
SET GLOBAL interactive_timeout=28800;
SET GLOBAL wait_timeout =28800;
SET GLOBAL innodb_buffer_pool_size=8*1024*1024*1024; -- 根据服务器实际内存设定
SET GLOBAL slave_type_conversions='';
SET GLOBAL sync_binlog=1;
SET GLOBAL innodb_flush_log_at_trx_commit=1;
SET GLOBAL innodb_io_capacity=2000;
SET GLOBAL innodb_io_capacity_max=4000;
效果对比与总结
通过磁盘IO能力的测试对比可知:
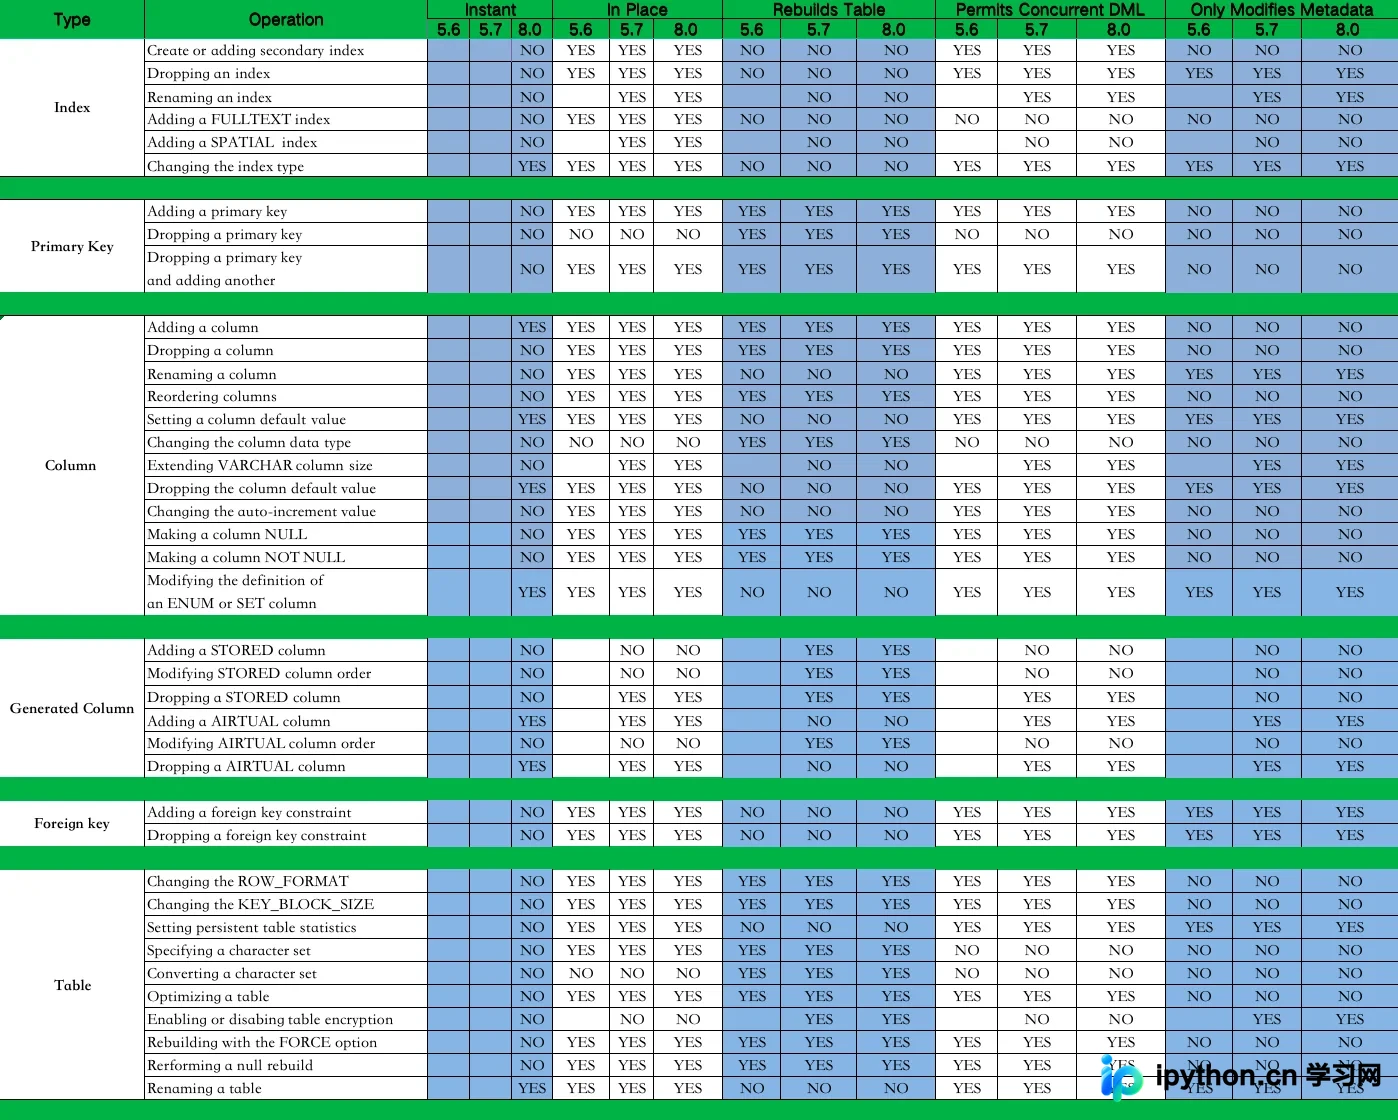
- NVME物理机:若无流量,直接修改约需5小时。
- 机械盘虚拟机:同样情况需40小时。
采用级联复制方案的收益在于:
- 并行处理:DDL时间在后台悄然进行,不占用应用响应时间。
- 风险隔离:若S2 DDL失败,不影响主库M;即使失败,M数据未受损,可快速重试S2。
- 切换快速:最后一步只需等待秒级的网络同步,即可切换VIP或配置,满足严苛的SLA要求。
注意:大表操作应贴合场景寻找合适方案,而非盲目追求单种最优工具。不建议在生产环境并行执行多个DDL。以上就是MySQL级联复制下进行大表的字段扩容的详细内容,更多关于MySQL数据库运维与大表优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









