

初学者入门python机器学习应优先掌握哪些库

先掌握NumPy与Pandas,打好机器学习数据处理基础
机器学习的第一步永远是数据处理。NumPy是Python科学计算的基石,其核心是高效的多维数组对象(ndarray),支持向量化运算与广播机制,能极大提升矩阵乘法、线性代数运算的速度。初学者需熟练掌握数组创建、切片、重塑(reshape)及基础统计函数(如mean, std)。Pandas则建立在NumPy之上,专注于结构化数据操作。通过pd.read_csv()读取数据后,应优先掌握info()、describe()查看数据概况,使用dropna()或fillna()处理缺失值,利用loc/iloc进行行列筛选,并通过groupby与apply完成特征聚合。验证是否掌握的标准是:能否独立加载一个包含数值与类别特征的CSV文件,完成缺失值填补、异常值过滤,并提取出模型所需的特征矩阵(X)与标签向量(y)。例如,使用df.drop(columns=['id'])剔除无关列,再通过pd.get_dummies()将离散变量转为独热编码,即可为后续建模提供干净的数据输入。
重点学习Scikit-learn,建立完整的机器学习实践流程
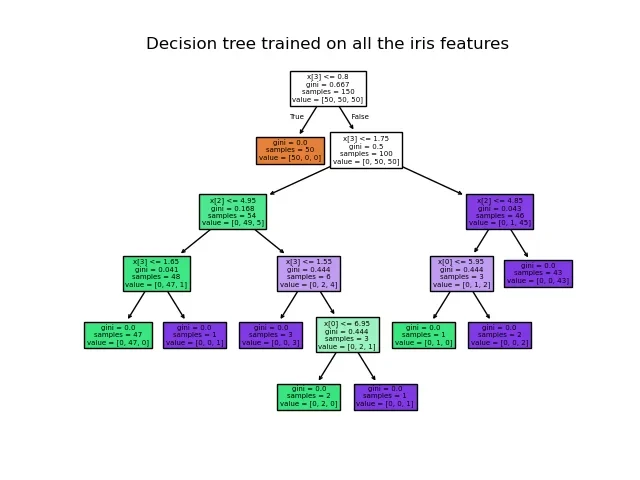
Scikit-learn是传统机器学习领域最成熟的工具库,其API设计高度统一,遵循“实例化-拟合-预测”的标准范式。初学者必须掌握从数据到模型落地的完整流水线:首先使用train_test_split将数据集划分为训练集与测试集,防止数据泄露;其次利用StandardScaler或MinMaxScaler进行特征缩放,消除量纲差异对距离型算法的影响;随后选择基础模型如LogisticRegression或RandomForestClassifier,调用.fit(X_train, y_train)进行训练,并通过.predict(X_test)输出预测结果。评估环节需结合业务场景选择指标,分类任务常用accuracy_score、classification_report查看精确率与召回率,回归任务则依赖mean_squared_error与r2_score。以鸢尾花数据集为例,仅需十余行代码即可完成数据划分、标准化、模型训练与交叉验证,这一过程能帮助初学者建立严谨的实验习惯,避免盲目调参。
补充Matplotlib与Seaborn,用可视化理解数据和模型
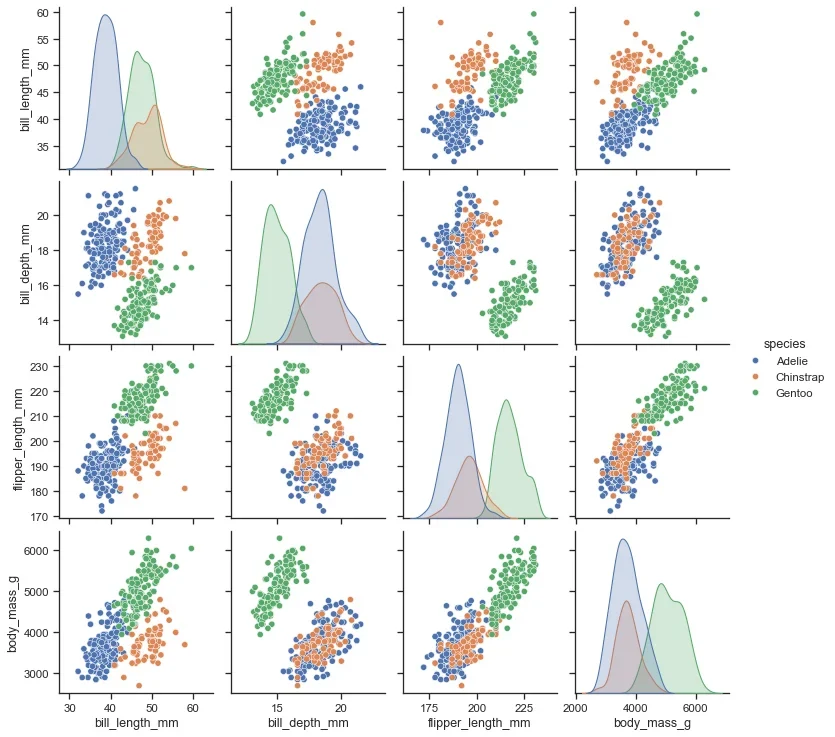
数据可视化是机器学习探索性分析(EDA)的核心手段,能将抽象的数值转化为直观的图形,帮助初学者快速洞察数据分布与特征关系。Matplotlib提供底层绘图控制,适合自定义坐标轴、图例与子图布局;Seaborn则基于Matplotlib封装,内置统计图表与美观主题,大幅降低绘图门槛。初学者应优先掌握三类图表:使用sns.histplot或sns.boxplot观察单变量分布并识别异常值;通过sns.scatterplot分析两个连续特征间的线性或非线性趋势;利用sns.heatmap(df.corr(), annot=True)绘制相关性热力图,排查多重共线性问题。例如,在房价预测任务中,若发现“房间数”与“价格”呈强正相关,而“房龄”与“价格”呈负相关,即可指导后续特征选择。可视化还能用于模型诊断,如绘制残差图判断回归假设是否成立,或绘制混淆矩阵直观展示分类错误的类别分布,从而针对性优化模型。
按学习阶段选择PyTorch或TensorFlow,避免过早深入深度学习
深度学习框架的学习必须建立在扎实的传统机器学习基础之上。初学者在熟练掌握NumPy、Pandas与Scikit-learn后,再根据具体方向选择PyTorch或TensorFlow。PyTorch以动态计算图著称,代码风格贴近原生Python,调试直观,在学术界与计算机视觉、自然语言处理领域占据主导;TensorFlow则凭借静态图优化与生产部署生态(如TFX、TensorFlow Lite)在工业界广泛应用。建议初学者仅选择其一深入,避免同时学习导致概念混淆与精力分散。入门时应从张量(Tensor)操作、自动求导(Autograd)与基础层(如nn.Linear、nn.Conv2d)开始,逐步过渡到自定义Dataset与DataLoader。例如,使用PyTorch搭建一个两层全连接网络处理MNIST手写数字分类,重点理解前向传播、损失函数(如nn.CrossEntropyLoss)与优化器(如torch.optim.Adam)的协同机制,而非急于复现复杂架构。
用一个完整小项目验证库的掌握程度并避开常见误区
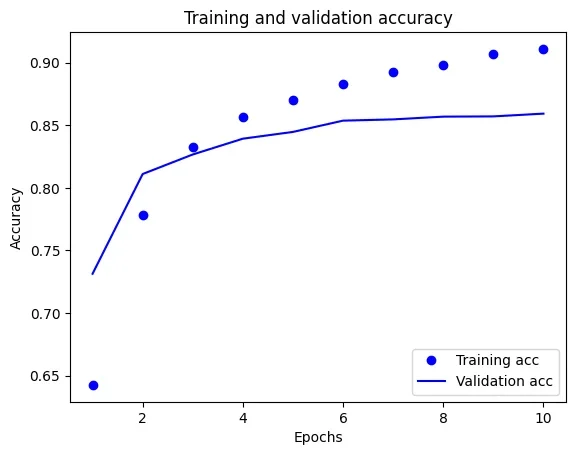
检验学习成果的最佳方式是独立完成一个端到端的微型机器学习项目。以“泰坦尼克号乘客生存预测”为例,完整流程应包含:使用Pandas读取CSV并处理缺失值与类别编码;借助Seaborn绘制特征分布与相关性图筛选关键变量;通过Scikit-learn的Pipeline串联特征缩放与随机森林分类器;利用交叉验证调优超参数,最终在测试集输出准确率与分类报告。验证掌握程度的标准是:能否不依赖教程独立写出可复现的代码,且模型性能达到合理基线(如准确率大于百分之七十八)。初学者常陷入四大误区:一是贪多求全,同时安装十余个库却无一精通;二是重模型轻数据,跳过清洗与探索直接调用算法;三是忽视评估,仅看训练集准确率而忽略过拟合;四是基础未稳便强攻深度学习。避开这些陷阱,坚持“数据处理优先、流程闭环验证、单点深入迭代”的原则,才能稳步构建机器学习工程能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









