

Python实用脚本:文件查找、编码转换与注释清理
本文整理了四个Python常用小脚本,涵盖文件操作与代码清理场景。包括递归查找指定后缀文件、将GB2312编码转换为UTF8、针对C语言等语言删除行内及块注释,以及简化字符串中的多余空白字符。这些脚本可直接调用,适用于日常开发中的文件批量处理与代码规范化需求。
2026-10-13
5

本文整理了四个Python常用小脚本,涵盖文件操作与代码清理场景。包括递归查找指定后缀文件、将GB2312编码转换为UTF8、针对C语言等语言删除行内及块注释,以及简化字符串中的多余空白字符。这些脚本可直接调用,适用于日常开发中的文件批量处理与代码规范化需求。
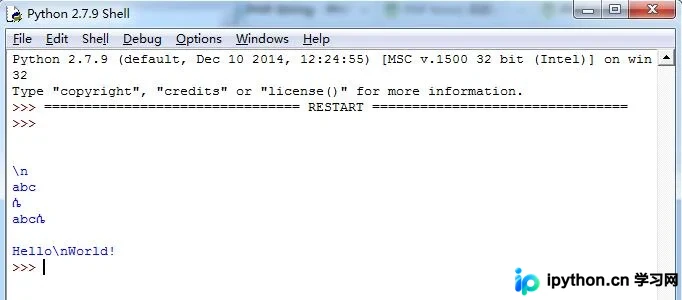
本文深入解析Python中原始字符串(r/R)与Unicode字符串(u/U)操作符的具体用法。通过代码实例演示了原始字符串在避免转义字符干扰及处理文件路径时的优势,以及Unicode操作符对标准字符串和原始Unicode字符串的转换机制。文章提供了相关在线编码转换工具链接,并附带完整可运行代码,帮助开发者掌握字符串处理技巧。
本文介绍Python中将Unicode编码转换为中文的方法,并深入分析Python2中修改默认编码为UTF-8的潜在风险。通过示例展示了改变sys.setdefaultencoding可能导致编码错误和字典行为异常,最后给出显式编码转换的最佳实践建议。
在 Web 开发与安全处理中,经常需要将 HTML 原始字符串转换为安全的实体编码。本文将详细演示如何利用 Python 标准库轻松完成 HTML 字符转义,确保特殊符号不被浏览器误解析,附带可直接运行的测试代码。
本文详解 Python 字符串核心操作。涵盖驻留机制原理、字符查询与替换、大小写对齐、切片比较及三大格式化方案,并梳理 Unicode 编码转换规范。掌握相关方法与底层逻辑,可显著提升文本处理效率并规避性能陷阱。
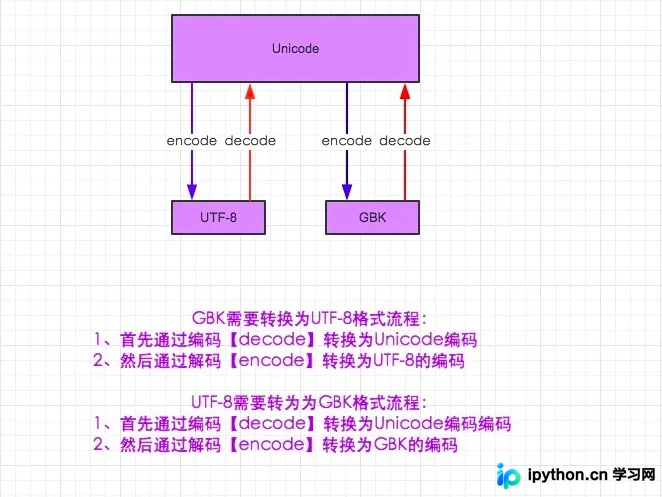
本文详细解析Python中字符编码转换的原理与操作。重点对比Python 2与Python 3在字符串处理上的差异,通过具体代码示例演示GBK与UTF-8编码的互转过程。文章涵盖encode与decode的使用场景,以及不同版本中字符串类型的变化,帮助开发者解决乱码问题。
本文详解 Python3 中处理中文文件读写的方法。Python3 默认使用 Unicode 字符串,读写文件时需指定编码(如 utf-8 或 gb2312)。通过 codecs.open 可简化编码处理,避免手动 decode/encode 转换。文章提供具体代码示例,展示如何读取、写入及转换不同编码的文本文件,解决中文乱码问题。