

Python3中bytes与str类型的区别及编码转换详解
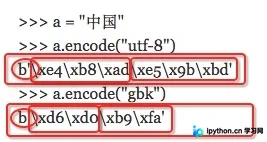
本文详解Python3中bytes与str类型的核心区别,重点演示如何创建bytes数据,并通过UTF-8和GB2312编码将字符串转换为字节序列,再解码回字符串。内容涵盖encode与decode方法的具体用法及参数设置,帮助开发者掌握二进制与文本数据的处理技巧。
2026-10-13
6

本文详解Python3中bytes与str类型的核心区别,重点演示如何创建bytes数据,并通过UTF-8和GB2312编码将字符串转换为字节序列,再解码回字符串。内容涵盖encode与decode方法的具体用法及参数设置,帮助开发者掌握二进制与文本数据的处理技巧。
本文详解Python3中str与bytes的编码转换机制。Python3默认使用Unicode,需通过encode方法转换为UTF-8或GBK等字节格式以用于存储传输。文章对比了UTF-8(通常24位)与GBK(通常16位)的位数差异,并提供Python交互环境下的具体代码示例,帮助开发者解决中文字符编码问题。
本文介绍如何使用Python的re模块和lxml模块提取指定URL页面的title。通过对比正则表达式与XPath两种方法,重点解决特殊页面编码冲突导致的乱码问题,提供完整的代码实现与结果展示,帮助开发者高效获取网页标题信息。
本文总结了 Python 2 中常见的中文处理问题,包括文件注释乱码、变量打印异常及编码转换方法。通过添加编码声明、使用 sys.setdefaultencoding 及 codecs 库,可有效解决 UTF-8 与 GBK 互转、复杂结构打印乱码等难题,帮助开发者在迁移至 Python 3 前优化现有代码。
本文详解Python中使用requests库爬取网页时常见的中文乱码问题。通过分析网页源码确定编码格式,并演示如何利用decode与encode方法将内容转换为GBK编码,从而正确显示中文内容。
本文总结Python中字符串与十六进制、二进制、八进制之间的转换方法,涵盖decode('hex')、hex()、binascii库及int()函数的使用。结合CTF赛题实例,提供二进制、ASCII、十六进制转字符串的Python脚本工具,帮助安全研究人员高效处理编码转换任务。
本文详细介绍如何利用 Python 进行常见的编码转换操作,涵盖 URL 编码、Base64、Hex 十六进制、ASCII 码及 Md5 哈希计算。通过具体代码示例,展示在 Web 安全和渗透测试场景中如何绕过过滤函数或处理乱码问题,帮助开发者高效解决日常编码处理需求。
本文提供Python实现摩尔斯电码与英文互译的完整代码示例。支持两种输入格式:字母间用斜杠或空格分隔、单词间用双斜杠或双空格分隔。程序自动处理大小写,输出时首字母大写其余小写,并严格遵循指定的分隔符规范,适用于基础加密学习及字符串处理练习。
本文详细讲解Python中如何使用字节模式处理文件。通过添加mode参数'b',文件方法将返回bytes对象。示例展示了如何识别PNG文件头,以及如何将文件字节流转换为十六进制字符串、Base64编码,并将十六进制数据还原为二进制文件写入,涵盖常见文件处理场景。
本文详细解析了C++调用Python时出现中文乱码的原因,并提供完整的解决方案。通过设置执行字符集和实现GBK到UTF-8的转换函数,确保中文字符在跨语言调用中正确传递。
在Python中,print语句前加u表示定义Unicode字符串。该前缀不仅适用于中文,也适用于任何字符串,用于指定Unicode编码。英文字符通常无需此标识,而中文字符若未明确编码易出现乱码。建议统一采用UTF-8编码以确保兼容性。
本文详细解析Python3中str、bytes和bytearray三种数据类型的区别与联系。重点讲解str与bytes之间的encode/decode及构造函数转换方式,深入剖析bytearray作为可变字节序列的初始化参数规则及常用操作方法,并对比bytes不可变与bytearray可变的特性,提供完整的类型间转换示例。