

PHP 数组编码转换:自动识别与递归处理
在PHP开发中,处理多源数据时常遇编码不一致导致的乱码。本文提供了一个自定义函数 array_iconv,利用 mb_detect_encoding 自动检测输入数据的字符集,并通过递归逻辑遍历数组,将所有遇到的字符串统一转换为 UTF-8 编码,解决深层嵌套数组的编码兼容问题。
2026-10-14
6

在PHP开发中,处理多源数据时常遇编码不一致导致的乱码。本文提供了一个自定义函数 array_iconv,利用 mb_detect_encoding 自动检测输入数据的字符集,并通过递归逻辑遍历数组,将所有遇到的字符串统一转换为 UTF-8 编码,解决深层嵌套数组的编码兼容问题。
在 PHP 开发中,直接使用 iconv() 进行字符集转换时常因特殊字符报错导致转换失败。本文介绍通过在目标编码后添加 //IGNORE 参数,使函数自动忽略无法识别的字符并继续执行,从而解决 UTF-8 与 GB2312 之间的编码转换难题。
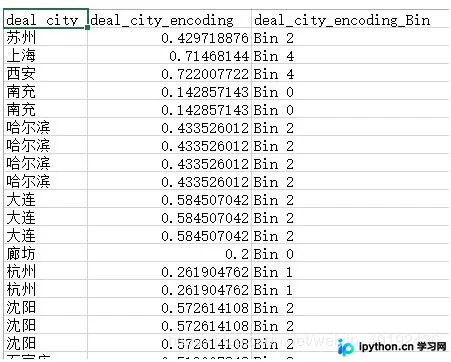
本文介绍一个Python实现的等深分箱工具,旨在解决最优分箱与等宽分箱之外的分箱需求。通过自定义类实现数值列表的排序、分割及编码替换,支持将原始数据转换为分箱后的编码形式。文章包含完整代码示例、GitHub源码链接及基于Pandas的实际应用案例,帮助开发者快速进行特征工程中的变量离散化处理。
本文深入讲解Python3中字符串与字节码的转换机制。重点解析encode和decode方法的正确用法,阐明Python3默认使用Unicode编码的特性。通过实例演示UTF-8与GBK互转流程,并指出常见的AttributeError错误原因,帮助开发者避免编码转换陷阱。
本文详细解析Python中处理含中文字符串时的编码问题,重点讲解str与unicode的转换机制及正则表达式匹配中文的规则。通过Python2.7环境下的实测案例,演示了如何正确设置文件编码、处理不同编码格式文件的读取显示,以及利用Unicode范围匹配中日韩文字与标点符号,为开发中解决中文乱码和匹配问题提供实用参考。
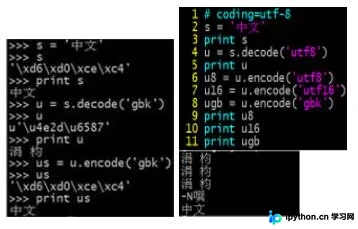
本文深入解析Python中str与unicode对象的存储机制及拼接规则。str以字节码形式存在,其编码取决于解释器或文件声明;unicode则采用双字节存储以支持跨平台。通过正确的decode与encode操作统一编码格式,可避免拼接错误,确保中文处理无误。
本文介绍在 Python 3.5 环境中,通过 GBK 编码转换与 ASCII 码区间判断,实现将中文字符串转换为拼音首字母的方法。代码包含核心转换逻辑及完整调用示例,适用于需要快速获取中文拼音首字符的场景。
本文详解Python3中bytes与str类型的核心区别,重点演示如何创建bytes数据,并通过UTF-8和GB2312编码将字符串转换为字节序列,再解码回字符串。内容涵盖encode与decode方法的具体用法及参数设置,帮助开发者掌握二进制与文本数据的处理技巧。
本文介绍如何使用Python的re模块和lxml模块提取指定URL页面的title。通过对比正则表达式与XPath两种方法,重点解决特殊页面编码冲突导致的乱码问题,提供完整的代码实现与结果展示,帮助开发者高效获取网页标题信息。
本文总结了Python中常见的中文乱码问题及解决方法,涵盖SyntaxError、UnicodeDecodeError和UnicodeEncodeError等典型错误。文章详细解释了decode与encode的工作原理,分析了IDE控制台输出限制,并提供了针对特定环境(如UliPad、Windows XP)的编码转换代码示例,包括处理网页内容时的编码转换策略。
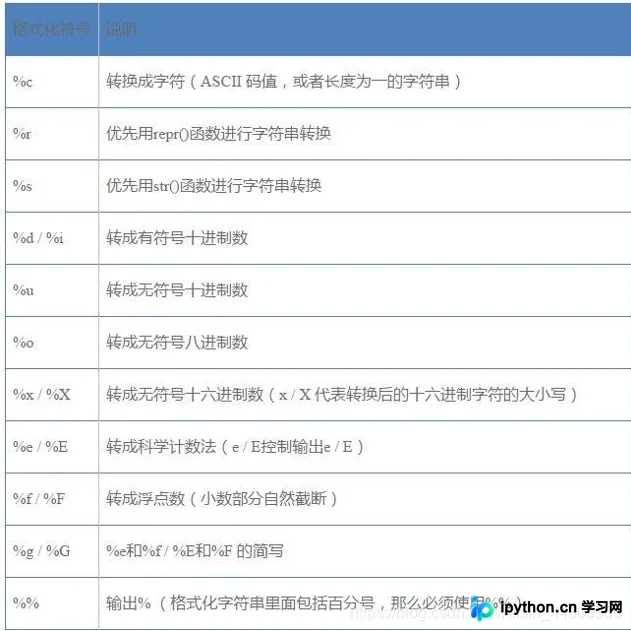
本文系统讲解Python中字符串的常规操作。涵盖使用+运算符拼接、利用len与encode计算字节长度、通过切片语法截取、split与join分割合并,以及find、index等检索方法。详细解析%与format两种格式化方式,并深入说明str与bytes类型的encode编码及decode解码转换机制,助您掌握核心技能。
本文详解Python2中Unicode与Str类型的转换机制,以及Python3中Str与Bytes的区别。重点解析Python2默认ASCII编码对中文的限制,Python3默认UTF-8编码下的字符串处理。通过具体代码示例说明decode与encode的正确用法,以及Python2中Unicode转字符串的特殊技巧,帮助开发者理解不同版本间字符串处理的差异。