Ruby 部署到云服务
这篇文章把 Ruby 应用上云的三条常见路径拆开说明:AWS 适合需要更多控制权的场景,Heroku 更适合快速上线,GCP App Engine 则偏向托管与全球覆盖。文中保留关键命令与步骤,并补齐平台选择、部署顺序和适用判断,方便按项目规模与运维能力做取舍。
2026-08-25
205

这篇文章把 Ruby 应用上云的三条常见路径拆开说明:AWS 适合需要更多控制权的场景,Heroku 更适合快速上线,GCP App Engine 则偏向托管与全球覆盖。文中保留关键命令与步骤,并补齐平台选择、部署顺序和适用判断,方便按项目规模与运维能力做取舍。
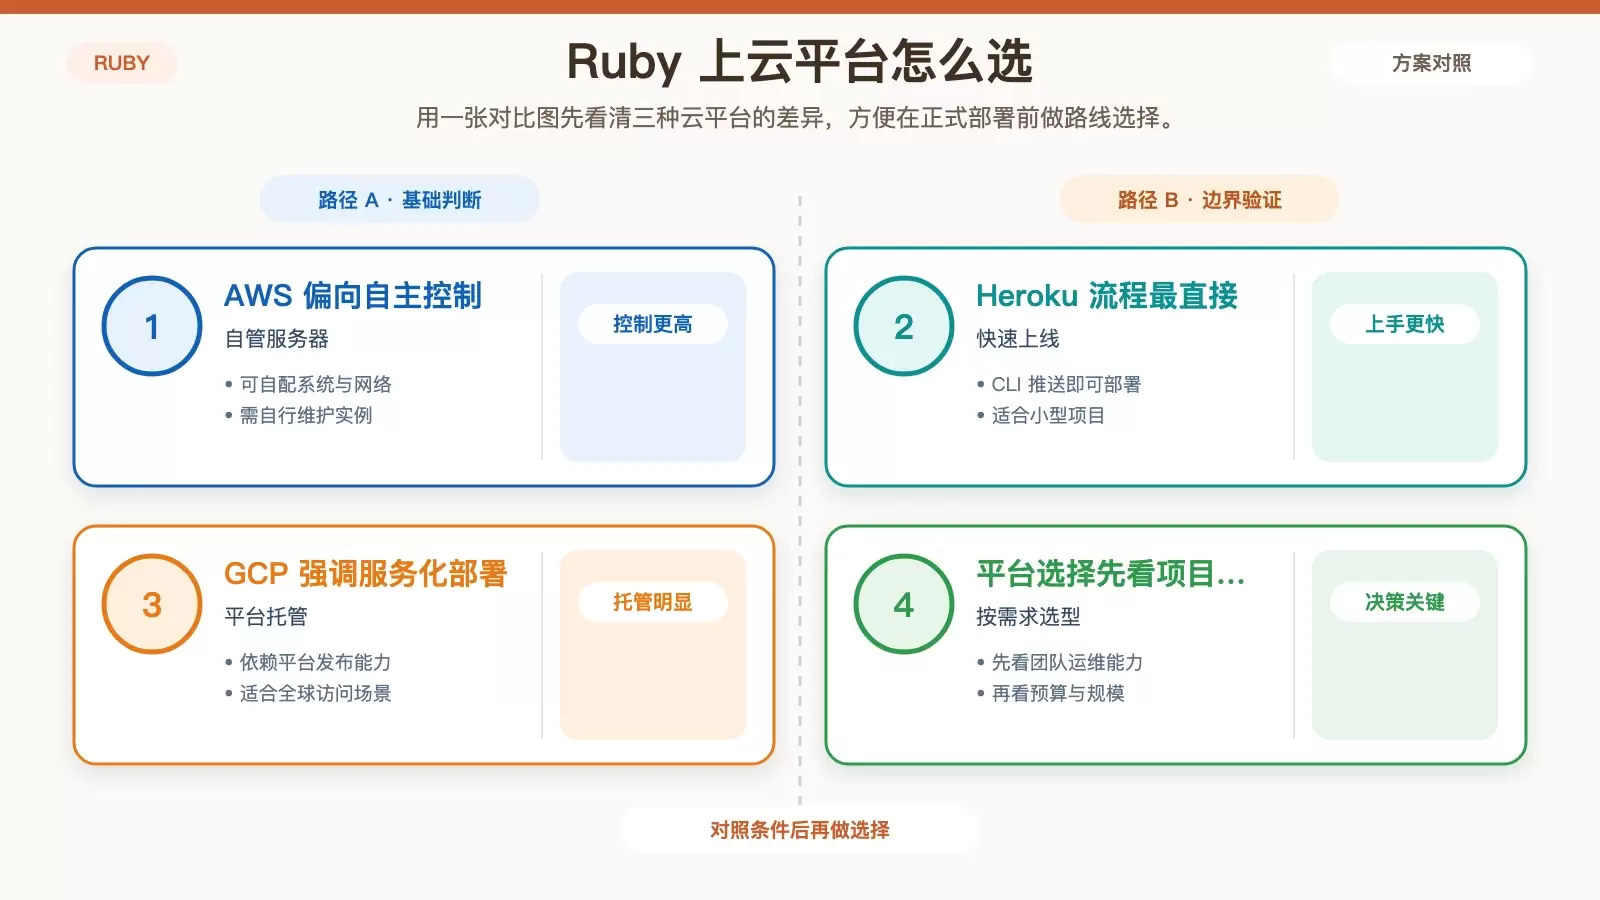
在 Debian 上调试 ThinkPHP,核心不是堆工具,而是按问题层次选择手段:先开调试模式看报错,再用内置工具定位变量和性能,复杂逻辑交给 Xdebug,环境异常则回到日志与命令行。本文把常用方法、关键命令和上线前注意点整理成一套可直接照着排查的流程。
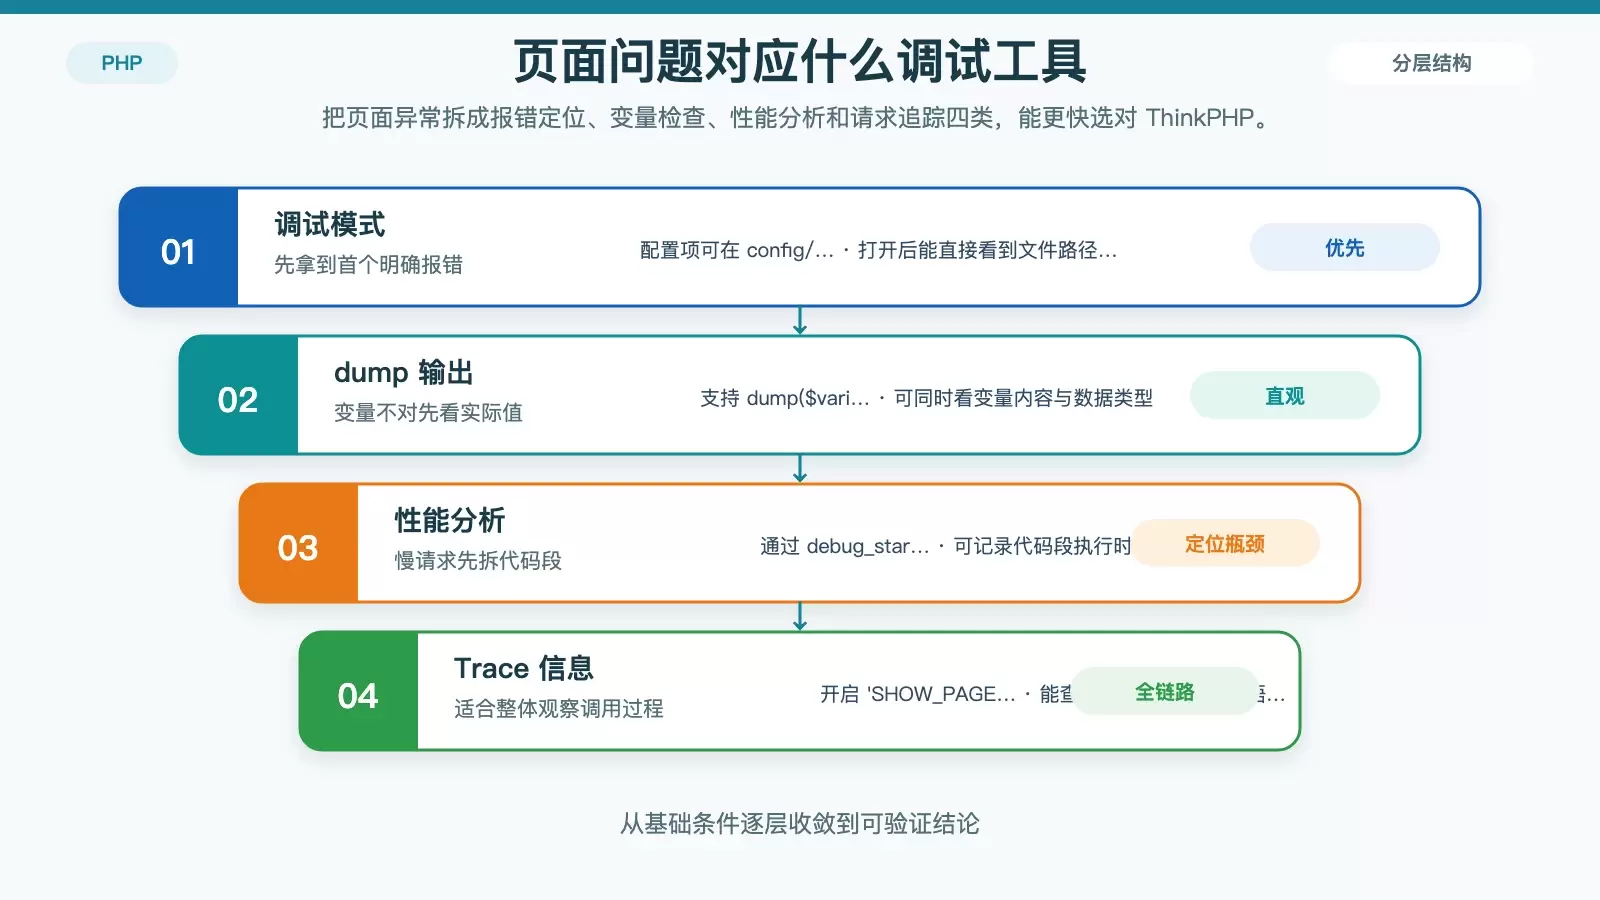
排查 JavaScript 服务超时问题时,Linux 日志里最常见的线索就是 `timeout` 和 `ETIMEDOUT`。本文用最直接的 `grep` 检索方式,说明该搜哪些关键词、该看哪些日志文件,以及如何结合结果快速缩小问题范围。 JavaScript 服务出现超时后,最容易被忽略的其实不是报错本身,而是 Linux 日志里已经给出的明确信号。
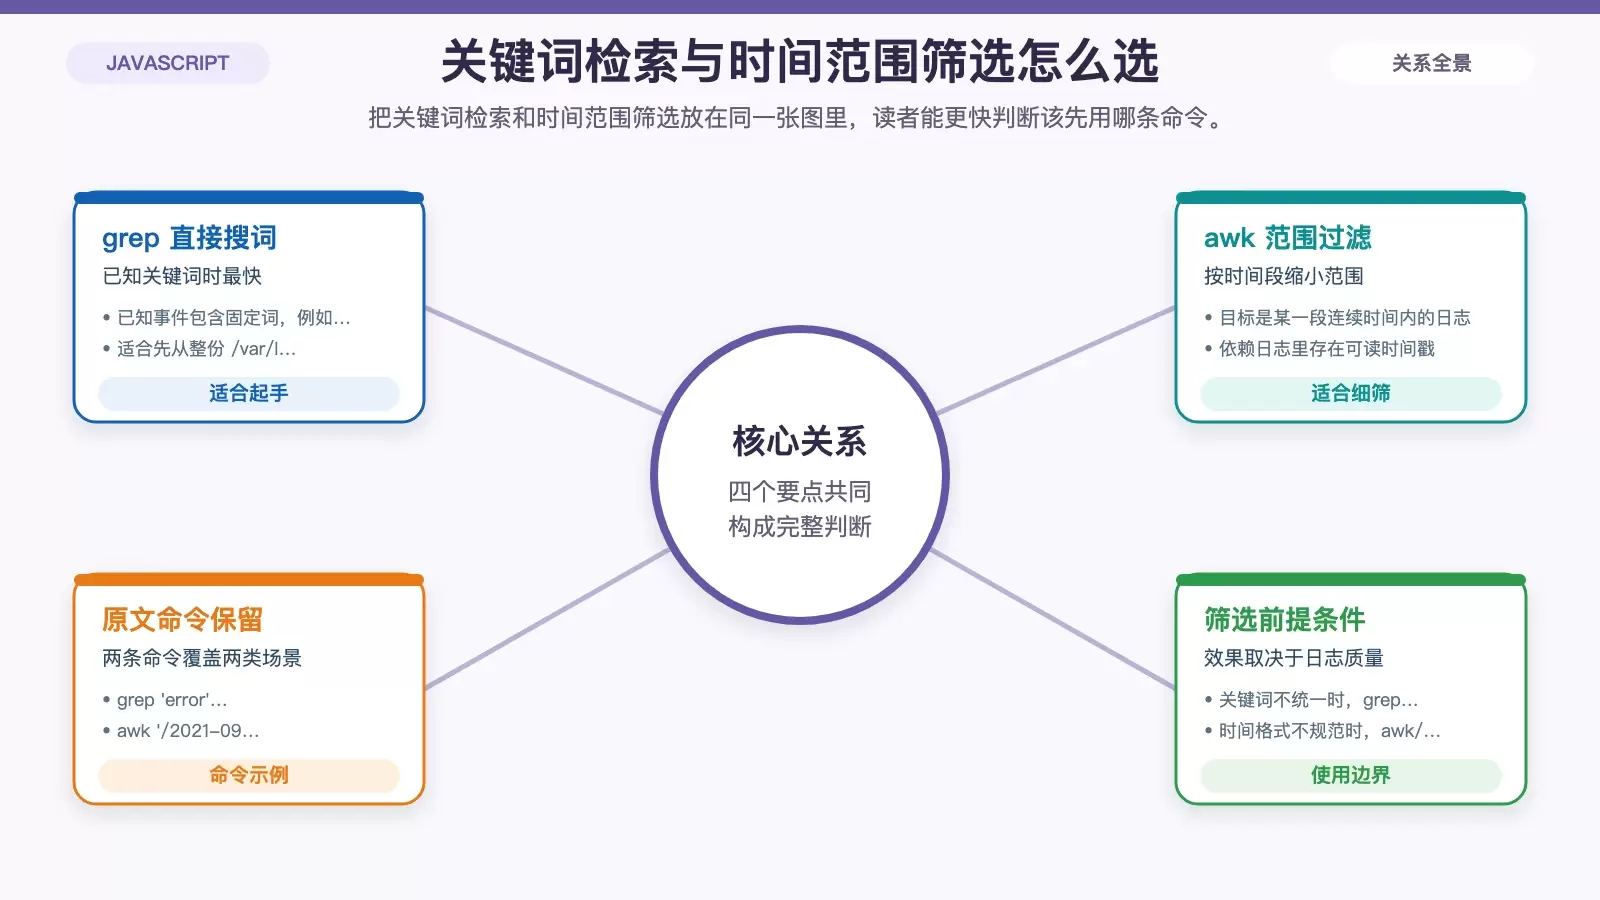
在 Debian 环境排查 JavaScript 或 Node.js 应用日志时,筛选特定事件通常有三条路:直接用 `grep` 查关键词、用 `awk`/`sed` 做范围过滤,或在日志规模变大后引入 rsyslog、fluentd、logstash 等工具。若能改应用代码,再配合 `winston`、`bunyan` 规范日志输出,后续检索会更高效。
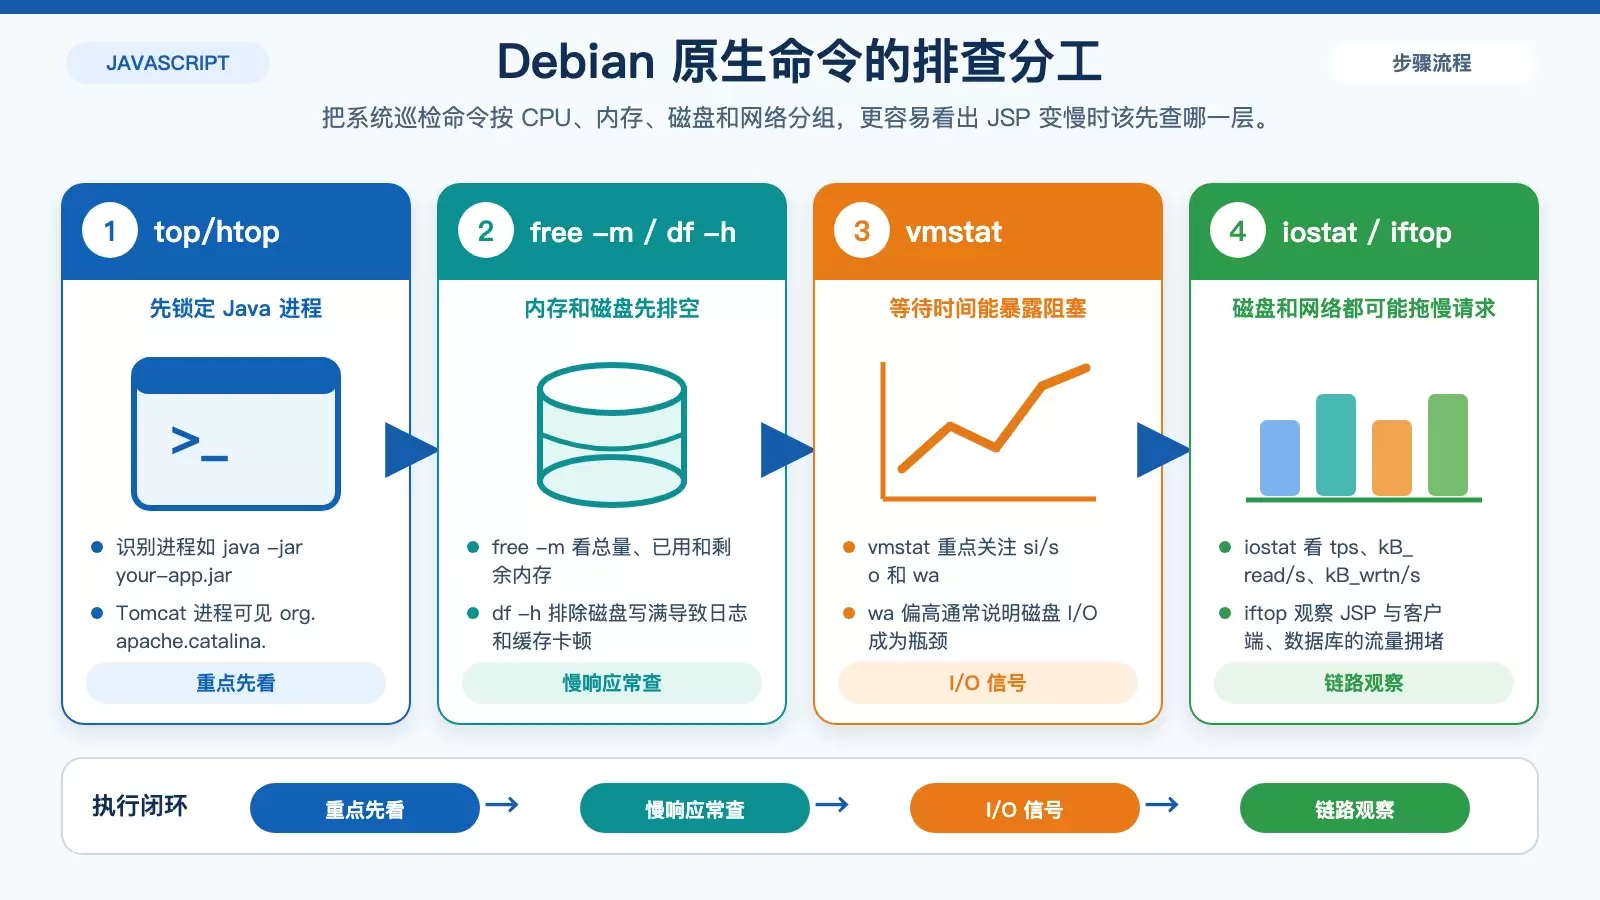
在 Debian 上监控 JSP 应用,不能只盯着 Java 进程本身,还要同时观察系统资源、日志、JVM 指标和服务状态。本文按排查深度梳理原生命令、Java 工具、第三方平台与 Spring Boot 内置监控,帮助你根据场景选出合适方案。
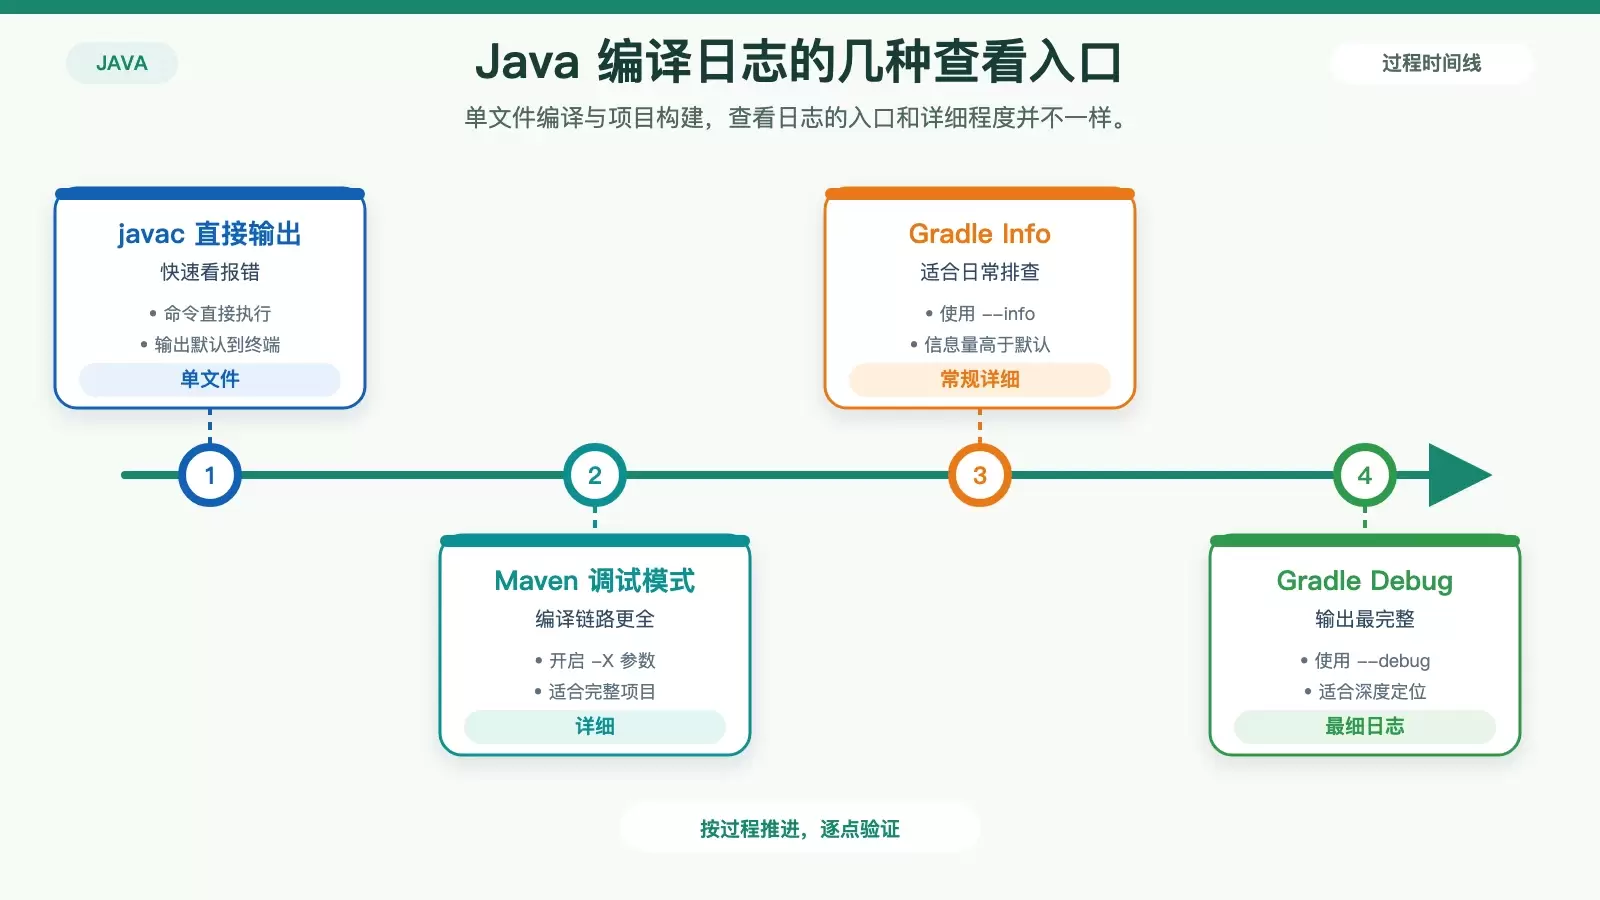
在 CentOS 上编译 Java 时,日志默认直接输出到终端,很多排错问题其实卡在“没留痕”或“看不全”。这篇文章按手工编译、Maven/Gradle 构建、日志文件查看与实时跟踪几个场景,整理出一套常用命令和判断方法。
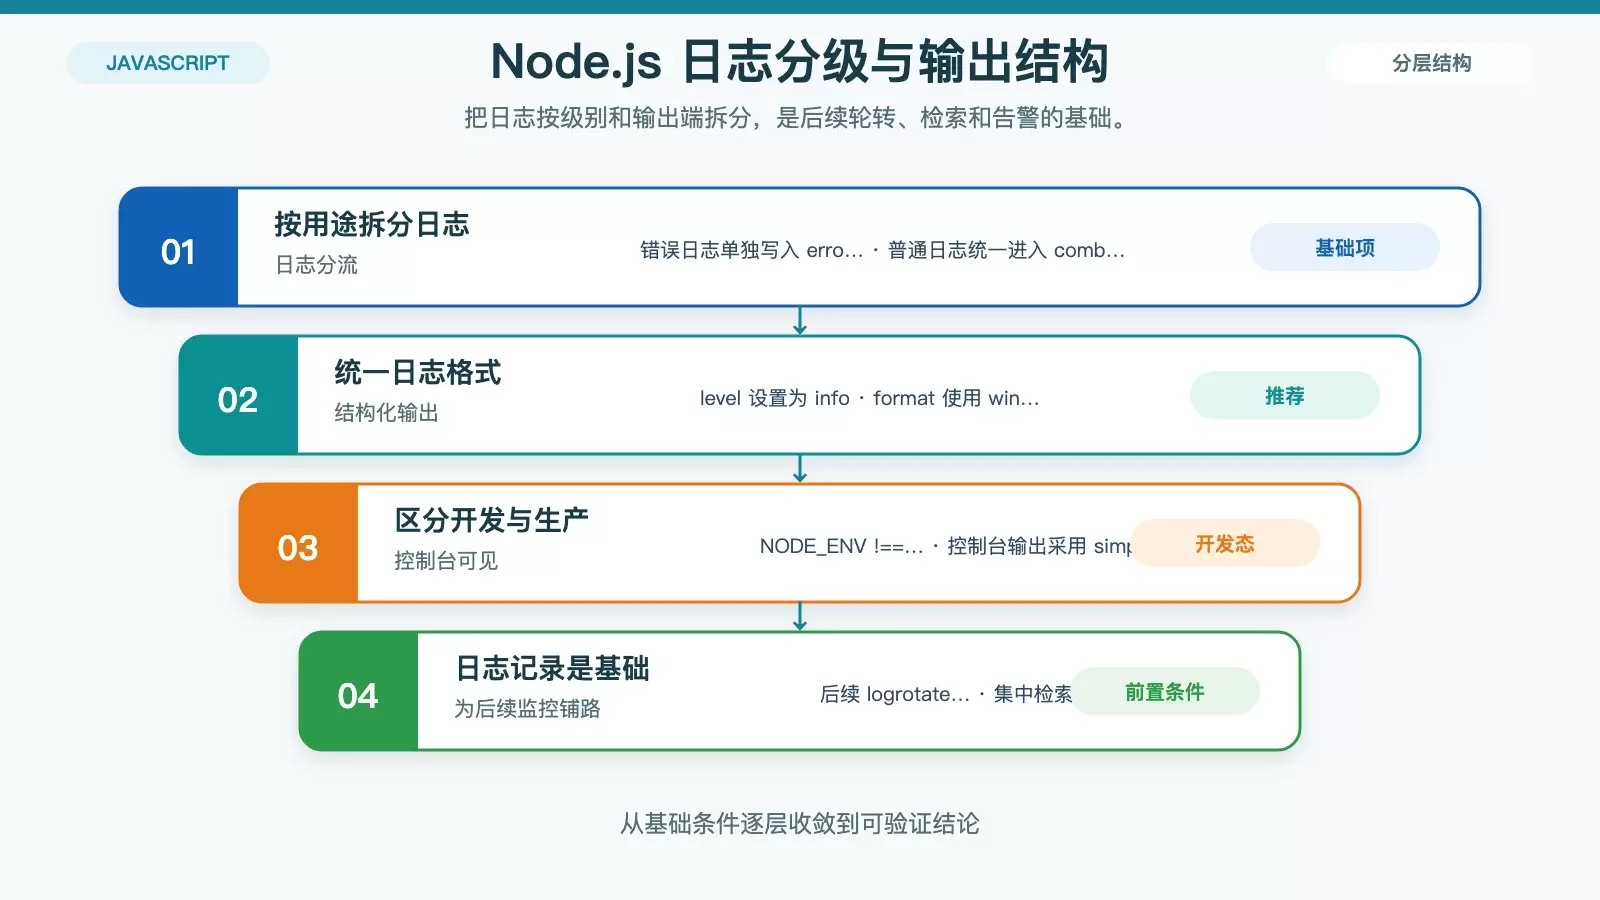
在 Ubuntu 部署 Node.js 时,日志常常只在出故障后才被想起。本文按“记录、轮转、汇聚、监控、审查、告警”六个环节梳理一套可落地做法,保留原始命令和配置示例,帮助你判断哪些步骤最值得优先投入。
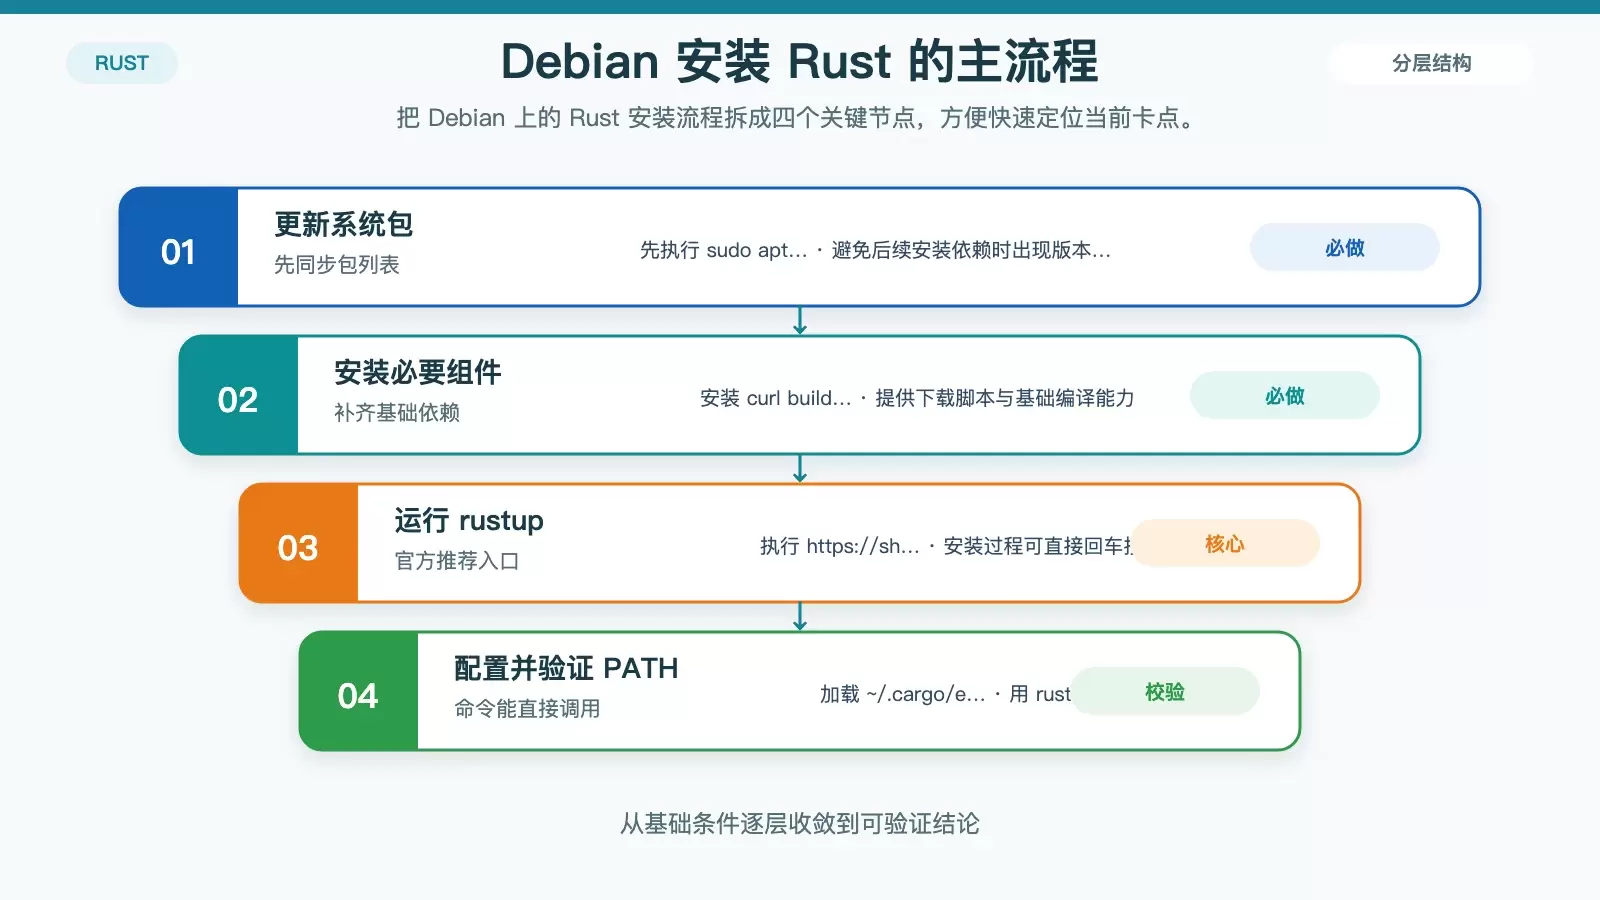
这篇文章把 Debian 上搭建 Rust 开发环境的流程拆成几个可执行步骤,包括安装依赖、用 rustup 部署工具链、配置 PATH、验证版本,以及按需启用镜像源和辅助组件。照着做,基本可以在一遍操作内完成可用环境。
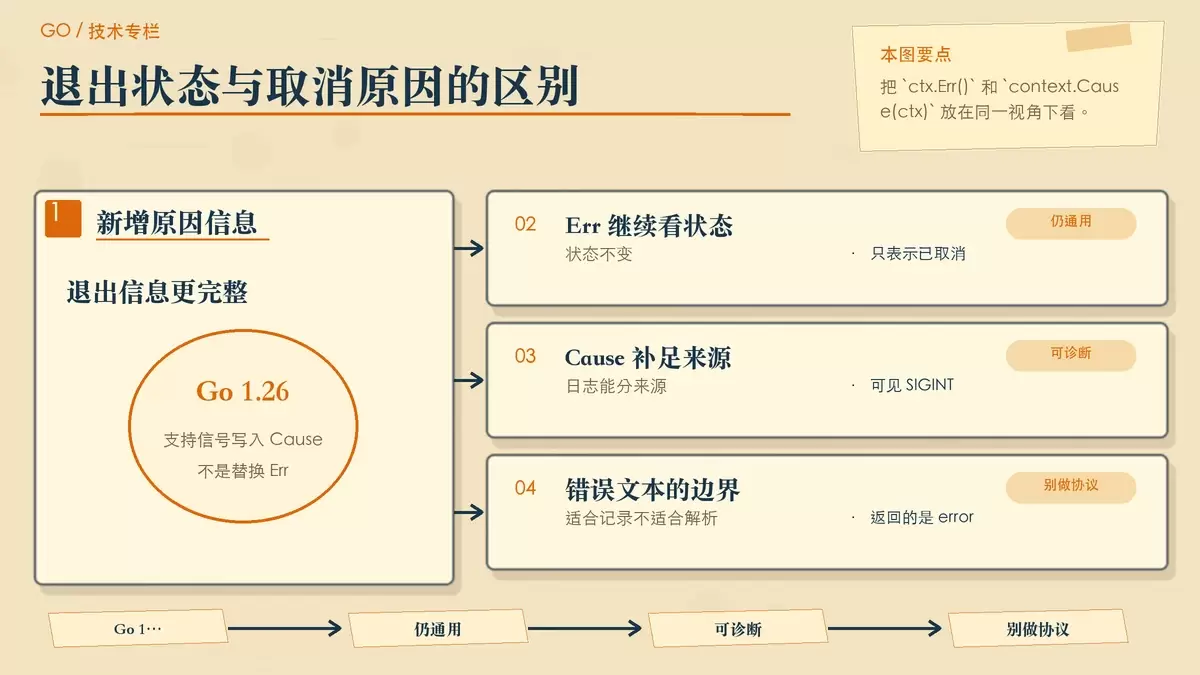
Go 1.26 补上了 `signal.NotifyContext` 在退出诊断上的关键短板:程序因系统信号取消时,开发者终于能通过 `context.Cause` 看见具体原因,而不再只有模糊的 `context canceled`。这让服务优雅退出、日志排障和信号处理边界都更容易说清。
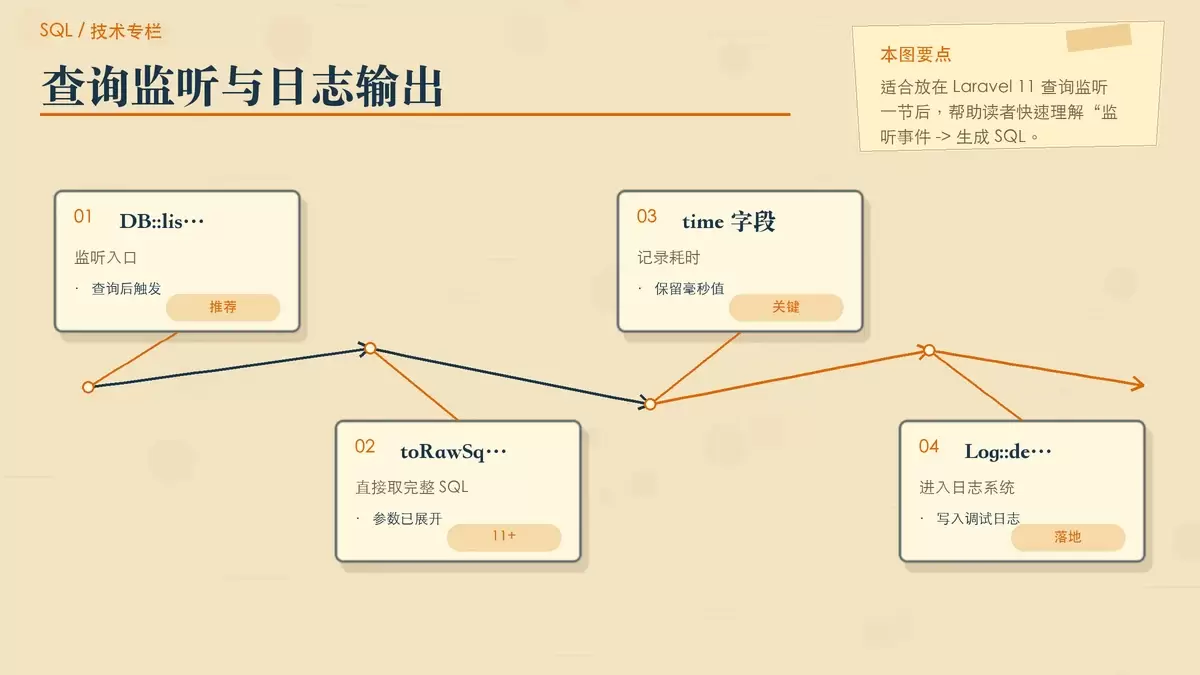
在 Laravel 排查数据库问题时,把 SQL 与耗时写入日志是最直接的办法。本文基于 Laravel 11 与 Laravel 10 的差异,整理了查询监听、完整 SQL 拼接输出,以及慢查询耗时监视的具体写法,便于你快速接入并判断该用哪种方案。
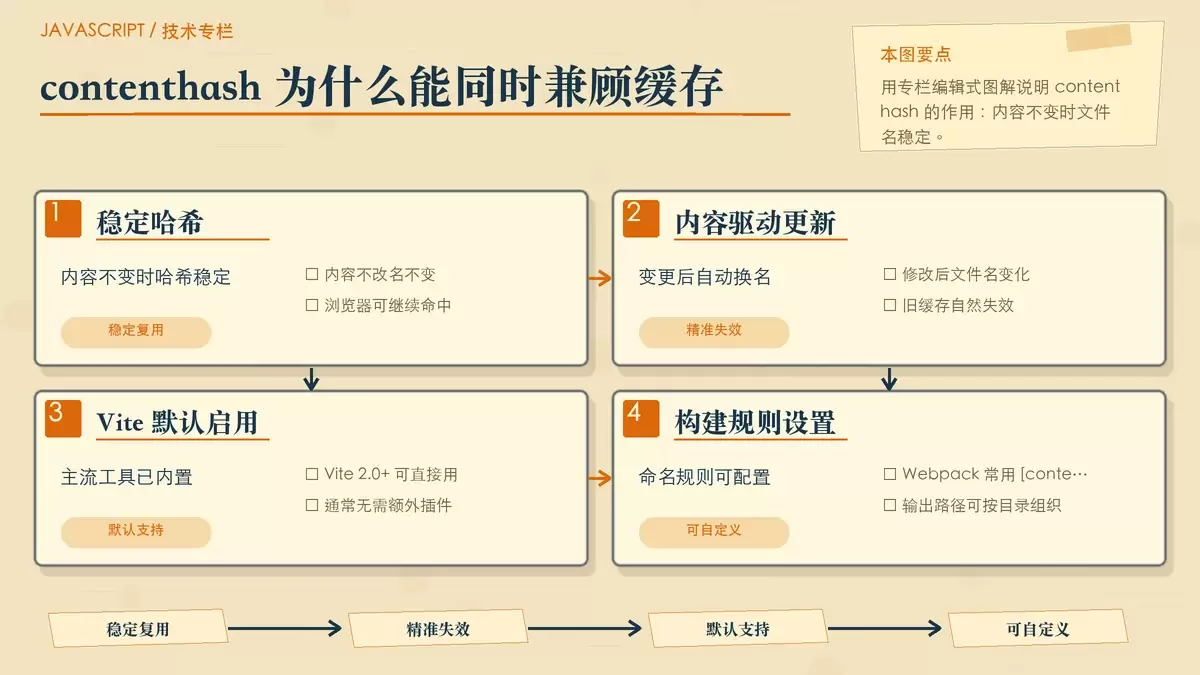
前端项目要想既吃到浏览器长期缓存的性能红利,又避免用户拿到旧资源,关键不在“清缓存”,而在于让构建产物自带内容哈希,并让 HTML、CI 校验和服务端缓存头一起配合。本文按构建、引用、校验、部署四步梳理可直接落地的做法。
ThinkPHP 默认日志并不包含 URL、IP、状态码和耗时,直接拿来统计请求频次往往会得出错误结论。本文把可落地的方案拆开说明:先在 `app_end` 钩子安全写入结构化请求日志,再用 PHP 逐行解析聚合,并说明何时该看 TP 日志、何时该切到 Nginx `access.log`。