


很多项目一开始都想“直接从 ThinkPHP 日志里数访问量”,但默认日志格式根本不够用:没有完整 URL、没有来源 IP,也很难稳定拿到状态码和耗时。要把请求统计做成能复核、能落库、能给后台展示的数据,关键不在于多复杂的分析脚本,而在于先把日志写对,再明确统计边界。
下面按实际落地顺序来讲:先说明为什么默认日志不能直接统计,再给出更稳妥的结构化写入方式,接着用 PHP 原生代码做聚合,最后解释数据库落地和 TP 日志、Nginx 日志各自适合解决什么问题。读完后,你能判断自己统计的是“框架内请求”还是“全量 HTTP 请求”,避免后续图表和告警从一开始就偏掉。
ThinkPHP 默认日志为什么不适合直接做请求统计
ThinkPHP 默认的 thinklogdriverFile,重点是记录框架运行信息,不是面向请求分析设计的。直接去读这类日志文件,你通常看不到“谁在什么时候访问了哪个接口”,因为默认内容并不稳定包含请求 URL、IP 或耗时。
这意味着,真正开始统计之前,第一步不是写分析脚本,而是先确认日志格式里有没有统计所需的关键字段。如果没有,就不要勉强从现成日志里硬抠数据,应该改配置或直接换成自定义日志写入。
更稳妥的做法,是关闭默认日志驱动中不适合请求统计的部分,在每次请求结束前手动追加一行结构化记录。例如在 appcommonbehaviorWriteRequestLog 行为里输出统一格式:
2024-06-15 14:23:08|192.168.1.100|POST /api/user/info|200|142ms这一类单行日志的好处很直接:字段固定,后续无论你是按小时统计、按 URI 聚合,还是要查某个接口的异常波动,都能用同一套解析逻辑处理。
- 确保该行为注册在全局
apptag.php的app_end钩子下 - 避免在中间件或控制器里写日志,防止异常未触发导致漏记
- 不要用
file_put_contents(..., FILE_APPEND)直接写,高并发下可能错行;改用fopen + flock + fwrite + fclose保证原子性
在 app_end 阶段写入结构化请求日志
把日志写在 app_end 钩子,有一个很现实的好处:请求无论经过了哪些控制器或逻辑分支,只要顺利走到应用结束阶段,这条记录就有更大概率被完整写下来。相比把写日志逻辑散落在控制器或中间件里,这种方式更容易保持口径统一。
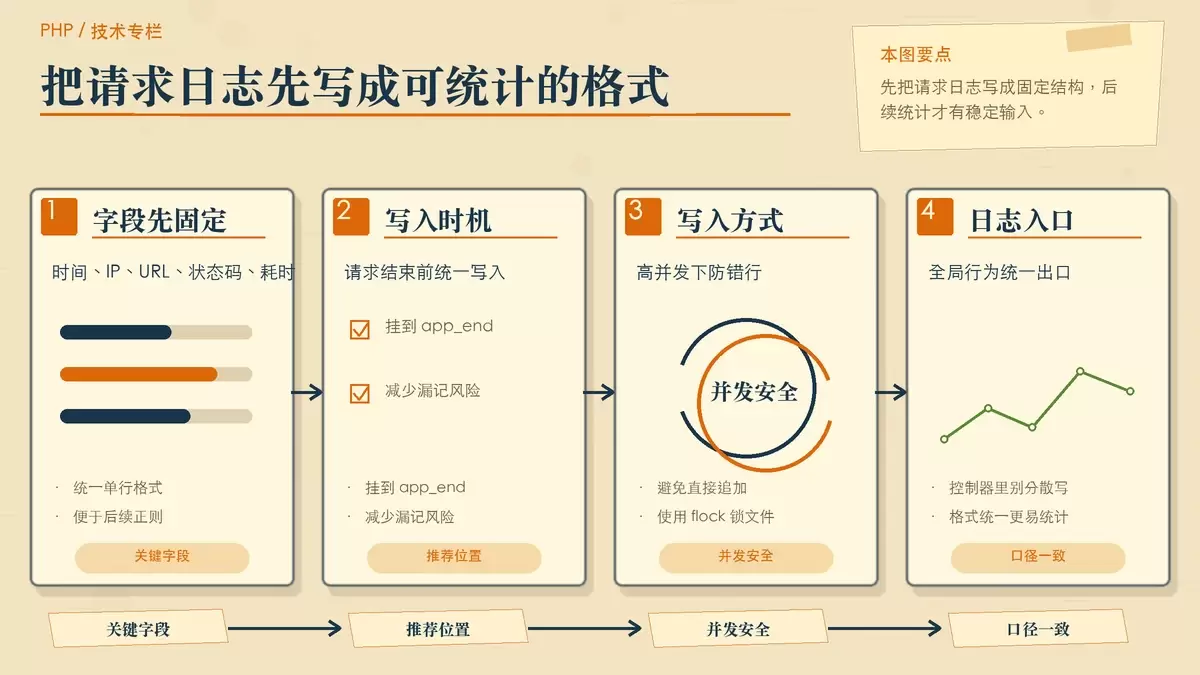
结构化日志至少建议包含这几项:时间、IP、请求方法与 URL、状态码、耗时。因为后面的统计需求,几乎都围绕这几个字段展开:
- 时间决定你能不能做小时级、天级趋势
- URL 决定你能不能统计接口热度和访问分布
- 状态码能帮你区分正常请求和失败请求
- 耗时则决定这份日志能不能进一步拿来做性能观察
这里最容易被忽略的是并发写文件的安全性。很多教程会直接用 file_put_contents(..., FILE_APPEND),单次测试看上去没问题,但一旦并发上来,日志错行、内容拼接、部分写入都可能出现。对请求统计这种依赖日志完整性的场景,使用 fopen + flock + fwrite + fclose 更稳妥。
换句话说,结构化日志不是“多记一点信息”这么简单,而是先把后续所有统计工作的输入数据固定下来。输入不稳定,正则再精巧、图表再漂亮,最后也只是把误差加工成了结果。
用 PHP 解析日志并做请求聚合
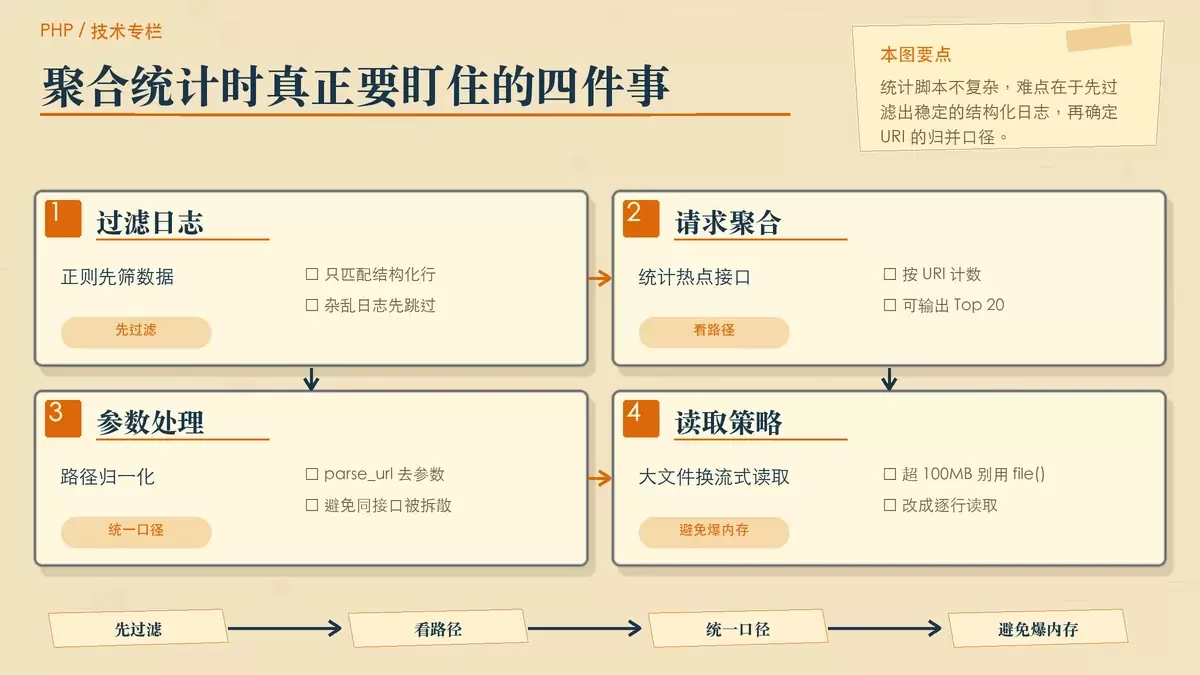
当日志格式固定之后,请求统计反而不复杂。小时级或天级的接口访问聚合,用 PHP 原生函数就足够完成,没必要为了这一步额外引入第三方日志分析库。核心思路只有两步:先筛出结构化日志行,再按 URI 计数。
下面这段代码可以放到 public/stat.php 临时运行,用来读取日志并做基础聚合:
$lines = file('/path/to/runtime/log/request.log', FILE_IGNORE_NEW_LINES | FILE_SKIP_EMPTY_LINES);
$stats = [];

foreach ($lines as $line) {
if (!preg_match('/^(d{4}-d{2}-d{2} d{2}:d{2}:d{2})|([d.]+)|(w+ )?(/[^|]+)|(d{3})|(d+ms)$/', $line, $m)) {
continue;
}
$uri = $m[3];
$stats[$uri] = ($stats[$uri] ?? 0) + 1;
}

arsort($stats);
print_r(array_slice($stats, 0, 20));
这段代码的重点不在“能跑起来”,而在于它假定你前面已经把日志写成了固定结构。ThinkPHP 原生日志内容往往比较杂,直接对混杂日志做正则匹配,失败率和维护成本都会更高,所以先过滤出你自己写入的那类结构化行,是整个解析过程能否稳定运行的前提。
聚合时还可以做几处实用处理:
$m[3]是路径部分,可进一步用parse_url($uri, PHP_URL_PATH)归一化带参数的 URL,例如/api/user?id=123归并为/api/user- 如果日志量超过 100MB,
file()一次性读入内容容易内存溢出,应该改用stream_get_line()逐行读取 - 如果日志时间戳是 UTC,而报表按本地日期展示,需要先用
date_default_timezone_set()对齐时区
这里还有一个统计口径问题值得提前处理:你到底要按“完整请求 URI”统计,还是按“去掉查询参数后的路径”统计。前者适合分析某些参数化请求的细分访问,后者更适合看接口总体热度。这个口径最好在脚本里固定,不要今天按 /api/user?id=123 算、明天又把它归到 /api/user,否则历史数据就不连续了。
统计结果如何落库,供后台展示和告警使用
把 $stats 数组写入 MySQL,并不只是为了查一句“今天 /api/login 被调用了多少次”。更常见的用途,是给后台画趋势图、做接口榜单,或者为后续告警阈值准备稳定的数据源。
表结构可以围绕聚合结果设计,字段至少包括:date(DATE)、uri(VARCHAR(255))、count(INT)、method(VARCHAR(10))。其中 method 单独存储很有必要,因为同一路径下,GET 和 POST 往往代表不同的业务语义。
落库方式上,建议由定时任务按小时执行一次聚合,而不是每条请求都实时 INSERT。原因很简单:逐请求入库会把分析链路反过来变成业务链路负担,还会放大数据库写入压力。按小时汇总再写入,通常更符合这类统计场景。
- 不要每条请求都 INSERT,改为每小时 cron 脚本跑一次聚合,插入前先
DELETE FROM request_stat WHERE date = CURDATE()清旧数据 - URI 字段建联合索引
(date, uri),否则按日期加路径查询会变慢 - 避免用
INSERT ... ON DUPLICATE KEY UPDATE,除非你已经对(date, uri)设了唯一索引,否则容易因重复插入报错
如果后面还要接图表或告警,最好顺手把“统计周期”这个维度也想清楚。按天存适合总览,按小时存更适合波动监控;但无论选择哪一种,都要保证统计脚本和后台展示用的是同一口径。
别把 TP 日志和 Nginx 日志混为一谈
很多统计误差,不是代码写错,而是日志层级选错。最典型的误解就是:“TP 日志里有 492 行,所以系统今天被访问了 492 次。”这个判断并不成立,因为 ThinkPHP 日志只覆盖成功进入框架处理流程的请求。
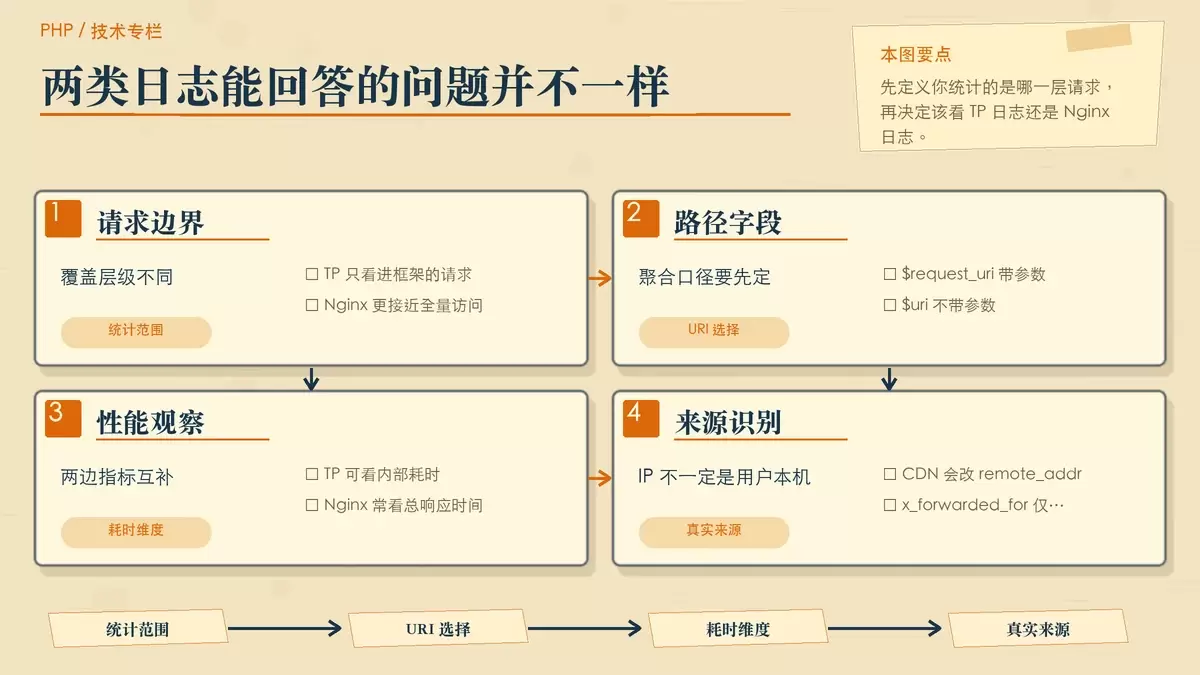
像静态资源请求(JS、CSS)、404、500,以及在 Nginx 层就被拦截掉的请求,例如防盗链、IP 黑名单等,都不会完整体现在 TP 日志里。所以,TP 日志更接近“框架内请求统计”,不是全量 HTTP 请求统计。
如果你的目标是看更真实的整体访问量,优先应该看 Nginx 的 access.log。但即便如此,也仍然要先定义清楚统计口径:
- Nginx 日志里的
$request_uri包含查询参数,$uri不包含;聚合时选哪个,取决于你要按完整请求还是按接口路径统计 - TP 日志能拿到框架内部耗时,例如
Debug::getRangeTime('query')这一类更偏应用内部的指标;Nginx 日志通常只有总响应时间,二者是互补关系 - 如果接入了 CDN,Nginx 日志中的
$remote_addr往往是 CDN 节点 IP,真实用户 IP 需要结合$http_x_forwarded_for判断,但这个头本身可以被伪造,只能作为参考
真正难的部分,从来不是写出几行统计代码,而是先定义“请求”到底指哪一层:是用户发起的 HTTP 请求,是到达 PHP-FPM 的请求,还是已经成功执行到控制器方法的请求。这个边界一旦没定清楚,后面的访问排行、趋势图、错误率甚至告警阈值,都会建立在不同口径的数据上,最后看起来精确,实际上不可比。
因此更稳妥的做法通常是分层看数据:要看框架内部接口热度和耗时,用 ThinkPHP 自定义结构化日志;要看站点整体流量和入口分布,用 Nginx access.log。两者配合使用,才更接近真实情况。









