


JSP 跑在 Debian 上时,性能问题往往不是单点故障:可能是 CPU、内存、磁盘 I/O,也可能是 JVM 堆积、日志报错,甚至只是服务管理没配好。比起一次性堆很多工具,更实用的做法是按“先看系统、再看日志、再进 JVM、最后接入平台”的顺序排查。
下面按使用场景把常见方法拆开说明:哪些适合日常巡检,哪些适合定位慢请求,哪些适合做长期可视化监控,以及 Spring Boot 项目能直接用上的内置能力。读完后,你可以更快判断自己该先上命令行、日志工具,还是直接接入 APM 平台。
先用 Debian 原生命令判断是不是系统层瓶颈
如果 JSP 页面突然变慢,第一步通常不是马上打开分析器,而是先确认服务器底层资源是否已经吃紧。Debian 自带的一组命令足够完成大多数初筛工作,适合日常巡检和应急排查。
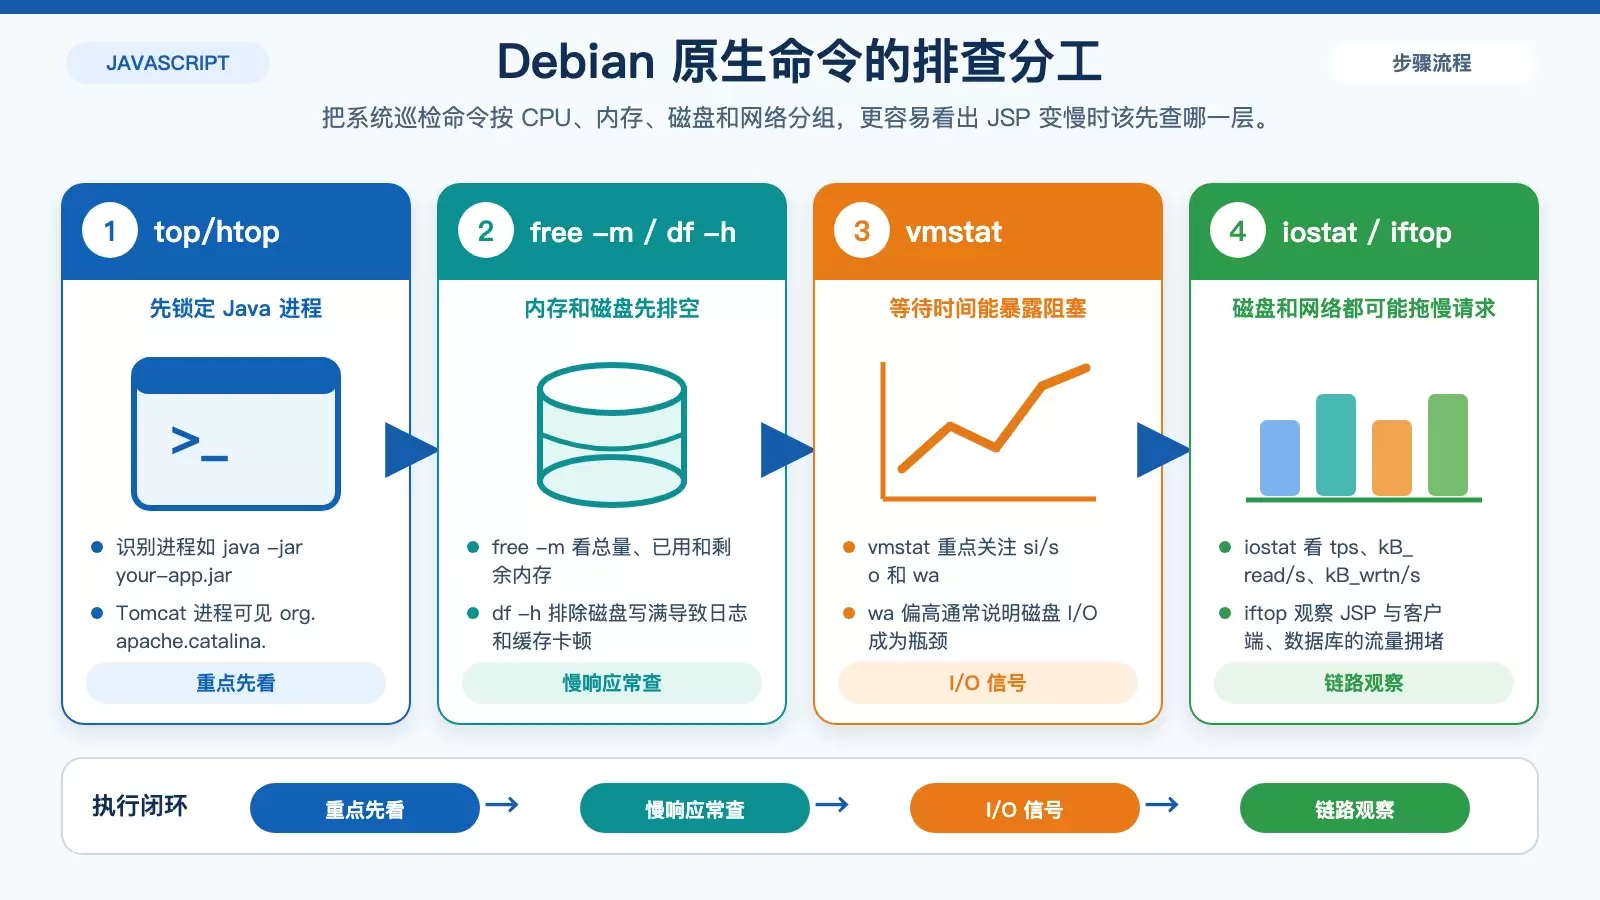
用 top/htop 看 Java 进程的 CPU 和内存占用
top 和 htop 可以实时查看 CPU、内存和进程列表。对于 JSP 应用,重点看对应的 Java 进程,例如 java -jar your-app.jar,或者 Tomcat 的 org.apache.catalina.startup.Bootstrap。如果某个进程 CPU 持续打满,或者内存持续上涨,就说明问题已经不只是“感觉变慢”。
用 free -m 和 df -h 快速排除内存、磁盘问题
free -m 用来查看内存总量、已用、剩余以及缓冲区情况。JSP 响应变慢时,先确认机器是不是已经接近内存上限,避免把交换区压力误判成业务问题。
df -h 则用来检查磁盘空间。磁盘一旦写满,日志写入、缓存落盘、临时文件处理都会被拖慢,JSP 应用也会连带卡住。
用 vmstat、iostat、iftop 继续查 I/O 和网络
vmstat 适合看虚拟内存和 CPU 等待情况,尤其要关注 si/so 和 wa。如果 wa 偏高,通常意味着磁盘 I/O 正在拖慢应用。
iostat 可以直接观察磁盘读写速率,例如 tps、kB_read/s、kB_wrtn/s。当 JSP 应用频繁读写日志、缓存或本地文件时,这类指标很容易暴露瓶颈。
iftop 则适合查看网络接口流量,确认 JSP 与客户端、数据库之间是否存在网络拥堵。带宽一旦被打满,请求延迟也会跟着上升。
日志为什么仍然是定位问题的第一现场
系统资源只能告诉你“哪里紧张”,但要确认到底是 JSP 渲染报错、Servlet 异常,还是数据库连接失败,最终还是得回到日志。
Tomcat 日志先看哪几个文件
如果 JSP 运行在 Tomcat 上,优先检查 logs/catalina.out 和 logs/localhost.date.log。前者通常记录主运行日志,后者更适合按天回溯 JSP 页面渲染错误、Servlet 异常等问题。很多性能下降的根因,比如频繁报错、线程阻塞、模板渲染失败,都会先出现在这里。
systemd 场景下怎么用 journalctl 快速过滤错误
如果服务由 systemd 管理,可以直接使用 journalctl -u tomcat.service 检索日志,再配合 grep -i "error|exception" 过滤错误信息。这个组合很适合在故障发生后快速缩小范围,尤其是在日志量比较大的机器上。
单独的错误日志不要忽视
如果应用额外配置了 logs/error.log,这里往往更集中地记录数据库连接失败、空指针异常等关键信息。排查慢请求时,别只盯着访问日志,错误日志里经常能直接看到根因。
需要深入 JVM 时,该用哪些 Java 专用工具
当系统层和日志层都只能说明“有问题”,但还看不清是 GC、线程、热点方法还是内存泄漏时,就该进入 JVM 级别分析了。
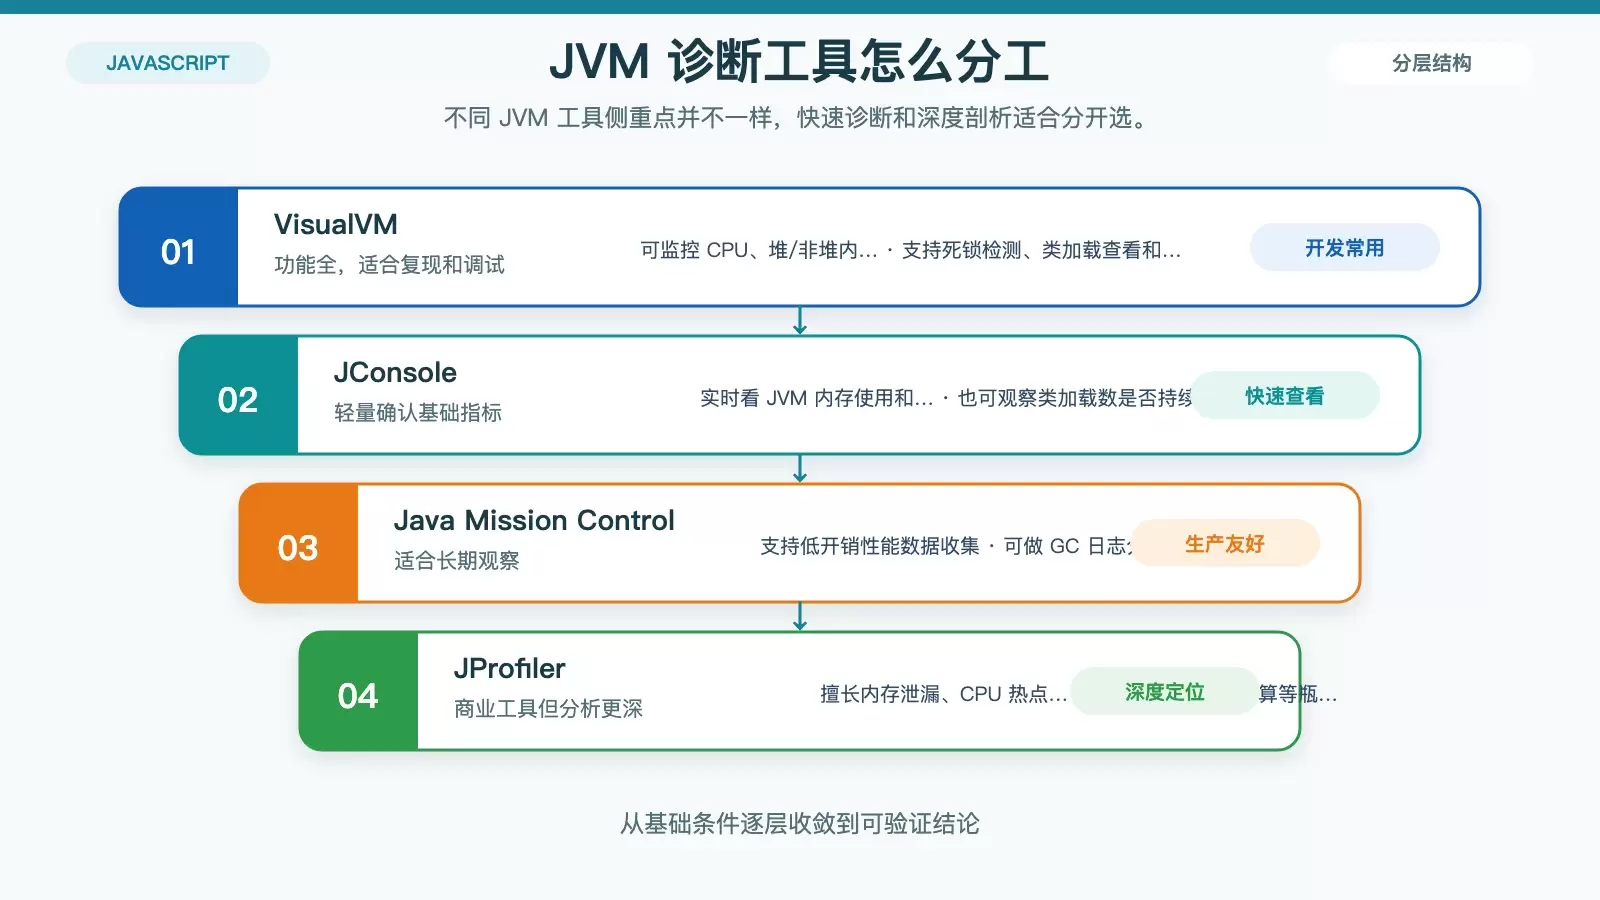
VisualVM 和 JConsole 适合快速诊断
VisualVM 是 JDK 自带的图形化工具,可以观察 CPU、内存(堆/非堆)、线程状态,还能做死锁检测、查看类加载情况,并帮助识别可疑的内存泄漏对象,适合开发环境和问题复现时使用。
JConsole 也随 JDK 提供,功能比 VisualVM 更轻量,适合快速查看 JVM 内存使用、线程数、类加载数等基础指标。如果只是想确认内存是不是一直在涨、线程数是不是异常增加,它足够直接。
JMC 和 JProfiler 更适合深度剖析
Java Mission Control (JMC) 是 Oracle 提供的专业诊断工具,支持较低开销的数据采集,可用于 GC 日志分析和方法热点分析。它更适合生产环境持续观察,不会给应用增加太大负担。
JProfiler 属于商业工具,但在内存泄漏检测、CPU 热点方法分析、线程同步分析方面更强。如果你面对的是慢 SQL、重复计算或锁竞争这类复杂瓶颈,它通常比基础工具更快给出线索。
从单机走向集群后,第三方监控平台怎么选
当监控需求不再是“临时排查一台机”,而是要覆盖多实例、统一展示、自动告警时,单靠命令行和本地工具就不够了。
Prometheus + Grafana:开源组合,适合可视化与告警
Prometheus 可以通过 JMX Exporter 暴露 JVM 指标并采集 JSP 应用性能数据,Grafana 负责展示仪表板。常见面板包括响应时间、错误率、资源利用率等,还可以配置告警规则,比如 CPU 使用率超过 80% 时自动发邮件。
Zabbix:适合统一纳管的企业场景
Zabbix 可以通过 Java 监控模板采集 JSP 应用的 CPU、内存、线程数等指标,适合已经有统一监控体系的团队。它也支持阈值报警,例如内存使用率超过 90% 时触发自动处理策略。
New Relic / Datadog:更适合看请求链路和数据库性能
New Relic 和 Datadog 这类云端 APM 工具更偏向全链路观测。除了请求延迟,它们还可以关联数据库查询性能、外部服务调用情况,甚至提供从浏览器请求到数据库返回的端到端追踪。对于多服务、多依赖的生产系统,这类工具的定位效率通常更高。
只会监控还不够,服务管理要能兜底
监控能帮助你发现问题,但要让 JSP 应用在异常退出后尽快恢复,还需要把服务托管和自动重启机制配好。
Supervisor:适合直接托管 Java 进程
Supervisor 可以在应用异常退出后自动拉起进程,并支持日志轮转,避免日志文件过大。常见配置文件路径是 /etc/supervisor/conf.d/your-app.conf,核心命令一般写成:
command=/usr/bin/java -jar /path/to/your-app.jar对于直接以 java -jar 方式运行的 JSP 相关服务,这种方式部署和维护都比较直观。
systemd:适合管理 Tomcat 或标准服务
如果使用 systemd 管理 Tomcat 或 JSP 应用,可以先用下面的命令查看状态和日志:
systemctl status tomcat.service
journalctl -u tomcat.service
要设置开机自启,则使用:
systemctl enable tomcat.service对 Debian 环境来说,systemd 往往是更标准的服务管理方式,和日志检索、重启策略也更容易联动。
如果项目基于 Spring Boot,还能直接用内置监控
有些 JSP 项目虽然保留了页面层,但底层已经迁移到 Spring Boot。这种情况下,很多监控能力其实不用额外部署,框架本身就已经提供了入口。
PerformanceMonitorInterceptor:看方法执行耗时
PerformanceMonitorInterceptor 可以记录方法执行耗时。通过 @EnableAspectJAutoProxy 开启 AOP,在需要监控的方法上添加 @Monitored 注解后,就能更细地看到调用耗时,适合定位某个 Service 或业务方法是否拖慢了 JSP 请求。
SimpleTraceInterceptor / CustomizableTraceInterceptor:看调用链路
SimpleTraceInterceptor 和 CustomizableTraceInterceptor 适合跟踪方法调用流程,例如记录调用前后日志。这样可以把 JSP 请求从控制器到 Service 再到 DAO 的执行链路串起来,帮助判断时间究竟耗在哪一层。
Actuator:最适合接入统一监控
Actuator 是 Spring Boot 最常用的监控组件。像 /actuator/metrics 可以直接暴露 JVM 内存、线程数等指标,/actuator/health 用来检查应用健康状态。把这些端点再接入 Prometheus 之类的平台后,就能比较顺畅地完成可视化和告警。
实际落地时,建议按这条顺序组合使用
如果你的目标是“先把问题找出来”,建议先从 top/htop、free -m、df -h、vmstat 这类原生命令开始,快速判断是不是资源瓶颈;然后回到 logs/catalina.out、journalctl -u tomcat.service 这类日志入口确认异常。
如果系统已经进入持续优化阶段,再逐步补上 VisualVM、JMC、Prometheus + Grafana 或 APM 工具。至于 Spring Boot 项目,则可以优先启用 Actuator 和拦截器,把最基础的指标和方法耗时先暴露出来,再决定是否引入更重的监控平台。









