


浏览器缓存带来的问题,往往不是“有没有缓存”,而是静态资源更新后,用户为什么还在加载旧文件。要把这个问题在持续集成流程里一次性处理干净,核心思路是让构建工具输出带 contenthash 的文件名,再由 HTML 自动引用、CI 自动校验、服务端正确下发缓存头。这样可以同时判断三件事:文件名会不会随内容变化、页面引用会不会跟着更新、线上缓存策略是否真正闭环。
构建阶段:让静态资源默认带上内容哈希
现代前端构建工具已经把这件事做成了标准能力。无论是 JavaScript、CSS,还是图片等静态资源,生产构建时都可以生成基于内容的哈希文件名,例如 app.a1b2c3d4.js、style.e5f6g7h8.css。
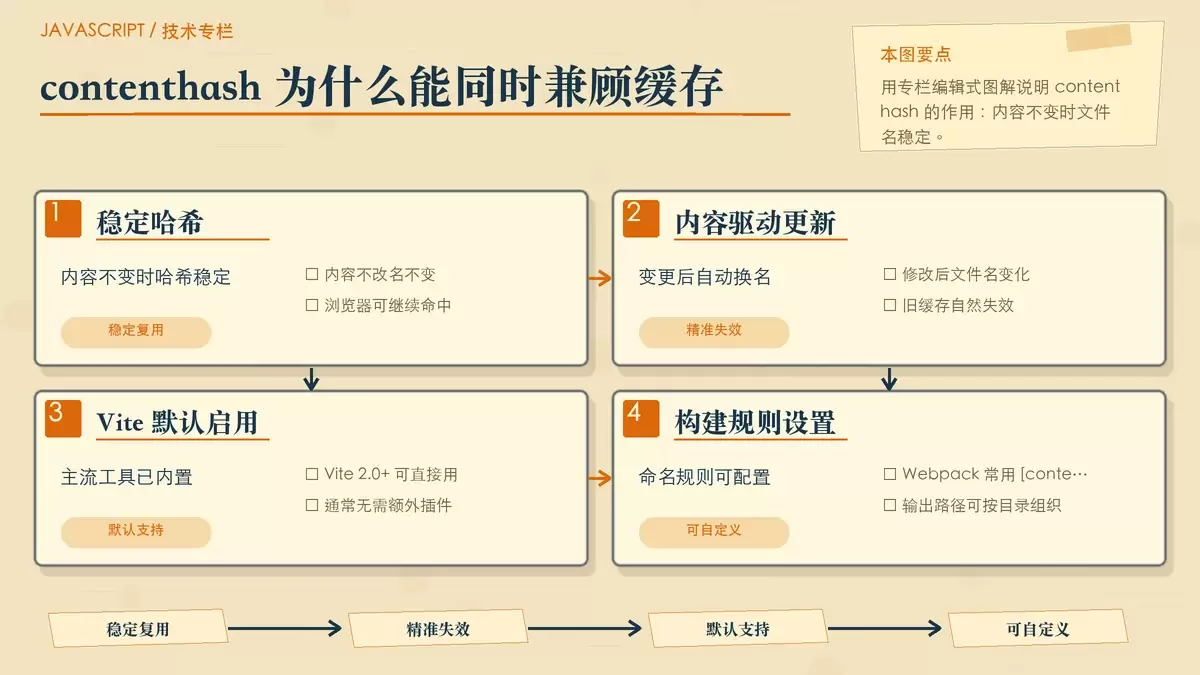
这里最关键的不是“带哈希”,而是使用 [contenthash]。它和随机字符串不同,只有文件内容变化时才会更新;如果内容没变,文件名也会保持稳定。这样浏览器才能持续复用已有缓存,而不是每次发版都全量失效。
常见工具里的做法如下:
- Vite:
2.0+版本在生产构建中默认启用 contentHash,一般不需要额外插件;如果要改输出目录或命名规则,可以调整build.rollupOptions.output.entryFileNames等选项。 - Webpack:在
output.filename和output.chunkFilename中使用[contenthash:8],例如js/[name].[contenthash:8].js。 - Vue CLI:可以在
vue.config.js的configureWebpack.output中设置,同时确保html-webpack-plugin会同步更新index.html里的资源引用。
这一层解决的是“文件本身能不能精确失效”的问题。只要产物命名正确,浏览器就能把新旧版本当成两个不同文件处理。
HTML 引用必须自动更新,不能手写死路径
仅仅产出带哈希的文件还不够,真正容易出错的是 HTML 引用。如果 index.html 里还写着旧路径,用户最终拿到的依然会是过期资源。
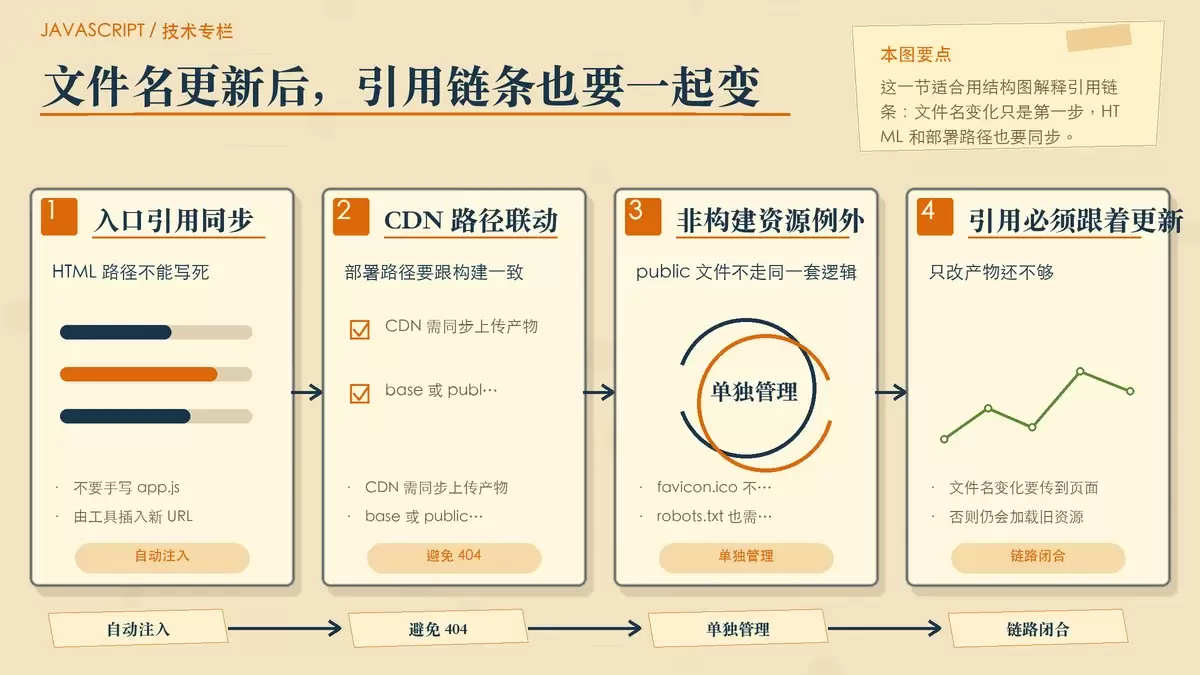
因此,CI 构建里必须保证 HTML 中的 script 和 link 标签由构建工具自动注入,而不是手动维护固定文件名。
- 不要在
index.html中写死<script src="app.js">这类路径,应交给HtmlWebpackPlugin或 Vite 内置 HTML 处理逻辑去插入带哈希的 URL。 - 如果静态资源走 CDN,CI 脚本还要同步上传这些带哈希的产物,并更新 HTML 所依赖的
publicPath或base配置,否则很容易出现路径正确但部署后404的问题。 public目录下的文件,例如favicon.ico、robots.txt,通常不参与构建哈希,需要单独制定缓存策略,不能默认按构建产物处理。
可以把这一步理解为“文件名变了,页面也必须跟着变”。只有引用链条全自动,带哈希命名才真正有意义。
CI 里加自动校验,避免上线后才发现缓存失效
不少项目的问题并不出在构建能力,而是出在流程没有验证。最稳妥的做法,是在 CI 流程末尾加入一层轻量检查,直接确认哈希命名和 HTML 引用是否已经生效。
可以重点检查这几项:
- 解析构建输出的
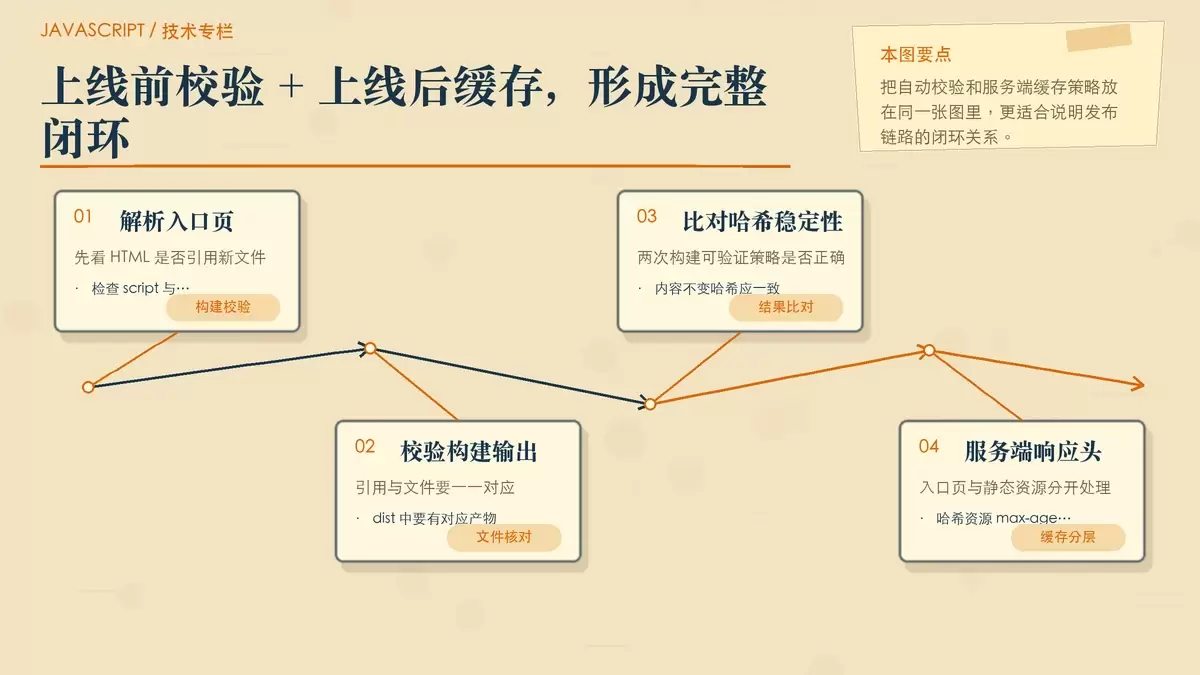
dist/index.html,提取所有<script>和<link rel="stylesheet">的src、href,确认其中包含8位及以上字母数字组合,例如.a1b2c3d4.。 - 检查
dist目录中是否存在这些带哈希命名的实际文件,数量也应与 HTML 中的引用对应一致。 - 对两次构建结果做简单比对:同一个逻辑文件例如
main.js,如果内容没有变化,哈希应保持一致;如果内容改了,哈希必须发生变化。
这类检查的价值在于,它能把“部署后用户发现资源没更新”的问题,提前压到 CI 失败阶段。对于多人协作或频繁发版的项目,这一步很值得保留。
最后一环:服务端缓存头要和哈希文件配套
带哈希的文件名只是基础设施,想真正发挥长期缓存价值,还需要托管平台返回正确的响应头。否则即便文件名设计得再合理,浏览器也未必会按预期缓存。
一套常见而稳定的原则是:
- 对带哈希路径的资源,例如
/js/app.a1b2c3d4.js,返回Cache-Control: public, max-age=31536000, immutable。这类文件名一旦变化就代表内容变化,因此可以放心长期缓存。 - 对
index.html,设置为Cache-Control: no-cache, must-revalidate,并启用ETag或Last-Modified,让浏览器每次优先确认入口页是否有新版本。 - 如果使用托管平台,可以按平台方式配置:Netlify 使用
_headers,Vercel 使用vercel.json,Nginx 则在location块里通过add_header统一管理。
这一步的逻辑很明确:哈希资源要“尽量久地缓存”,入口 HTML 要“始终能检查到更新”。两者配合起来,才是浏览器缓存策略的完整闭环。
一套可落地的判断标准
如果你想快速判断项目里的静态资源缓存方案是否靠谱,可以直接看四个问题:构建产物是否使用 [contenthash],HTML 是否自动注入新文件名,CI 是否校验哈希与引用关系,服务端是否区分对待哈希资源和 index.html。
这四项都到位后,浏览器长期缓存和精准失效基本就能同时成立。对 CI 场景来说,这比依赖人工清缓存、手动改版本号,稳定得多,也更适合持续发布。









