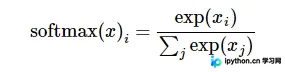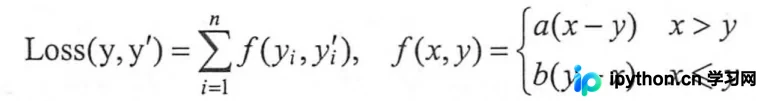TensorFlow tf.nn.softmax_cross_entropy_with_logits 函数原理与使用详解

本文深入解析 TensorFlow 中 tf.nn.softmax_cross_entropy_with_logits 函数的内部机制。该函数将 softmax 归一化与交叉熵计算合并,直接接收 logits 和真实标签。文章详细说明了参数含义、数学公式推导,并通过 Python 代码对比手动计算与函数调用的结果,帮助开发者理解其返回值特性及 reduce_sum/mean 的必要性。

TensorFlow tf.nn.softmax_cross_entropy_with_logits 函数原理与使用详解

Python使用xml.dom.minidom解析XML标注数据并导出为TXT格式

本文介绍如何使用Python的xml.dom.minidom模块读取XML格式的深度学习标注数据,并提取图片文件名及目标对象的边界框坐标,最终写入TXT文件。通过具体代码示例,展示了从解析XML树结构到格式化输出坐标信息的完整流程,适用于统一不同格式标注数据的场景。

TensorFlow卷积梯度反向传播详解:Valid与Same模式

本文详细解析TensorFlow中卷积操作的梯度反向传播机制,涵盖Valid和Same两种填充模式。通过具体示例展示如何对未知输入张量和未知卷积核分别求导,并介绍tf.nn.conv2d_backprop_input与tf.nn.conv2d_backprop_filter函数的使用方法及代码实现,帮助开发者深入理解卷积层训练过程中的梯度计算逻辑。

TensorFlow 自定义神经网络层实现指南

本文详细介绍如何在 TensorFlow 中自定义神经网络层。通过继承 tf.keras.Layer 类实现 __init__、build 和 call 方法,可灵活创建特定业务逻辑的层。同时,利用 tf.keras.Model 组合现有层构建复杂网络结构,如 ResNet 残差块,帮助开发者掌握模型架构设计的核心技巧。

TensorFlow自定义损失函数优化商品销量预测

本文介绍如何在TensorFlow中通过自定义损失函数来优化商品销量预测模型。传统均方误差可能忽略成本与利润差异,本文通过设定不同预测偏差的惩罚系数,使模型更贴合实际商业利益。结合具体代码示例,展示如何利用tf.greater和tf.where构建非对称损失函数,并验证其对预测结果的影响。

TensorFlow自定义损失函数优化商品销量预测

TensorFlow实现指数衰减学习率的方法

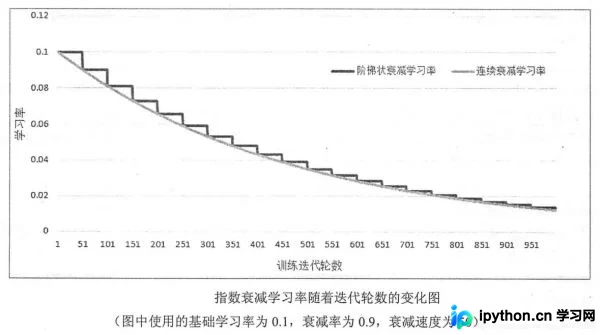
本文介绍TensorFlow中tf.train.exponential_decay函数的用法。该函数通过设置初始学习率、衰减系数和衰减步数,实现学习率的指数级下降。文章详细解析了staircase参数对连续衰减与阶梯状衰减的影响,并展示了global_step作为变量自动更新和作为占位符手动feed的两种典型应用形态,帮助开发者优化模型训练过程。

TensorFlow实现指数衰减学习率的方法

TensorFlow自定义损失函数实战:解决回归预测偏差问题

本文通过商品销量预测实例,详解如何在TensorFlow中自定义损失函数。针对均方误差无法反映预测偏差成本差异的问题,通过设定预测偏高与偏低的惩罚权重,构建分段损失函数。代码展示如何利用tf.where实现非对称惩罚,并对比不同权重设置对模型最终参数的影响,帮助开发者优化特定业务场景下的模型表现。

TensorFlow自定义梯度实现:重写机制与Stop Gradient详解

本文介绍TensorFlow中两种自定义反向传播梯度的方法。第一种通过tf.RegisterGradient注册新梯度并使用gradient_override_map覆盖原操作,适用于不可导节点如符号函数的平滑近似。第二种利用tf.stop_gradient阻断前向梯度传播,实现前向与反向函数的解耦,常用于梯度反转场景。文章提供具体代码示例及注意事项,帮助开发者灵活控制梯度流。

TensorFlow自定义梯度实现:重写机制与Stop Gradient详解

TensorFlow梯度下降法中var_list参数对权重W与偏置b更新的影响分析

本文通过TensorFlow代码示例,深入解析梯度下降法中var_list参数的作用。默认情况下,优化器会同时更新权重矩阵W([784,10])和偏置b。实验对比显示,若仅更新权重W,模型准确率约为0.9187,影响有限;而若仅更新偏置b,准确率骤降至0.1135,效果显著变差。这证明了在Softmax回归中,合理分配W和b的更新策略对模型性能至关重要。