

Python各发展方向的核心技术栈:从Django到PyTorch需要学什么
深入剖析Python主要发展方向的核心技术栈,系统梳理从Django工程开发跨越到PyTorch深度学习所需掌握的数学基础、科学计算工具链、思维模型转变与可落地的阶段化学习路径。
一、Python主流发展方向与技术栈版图
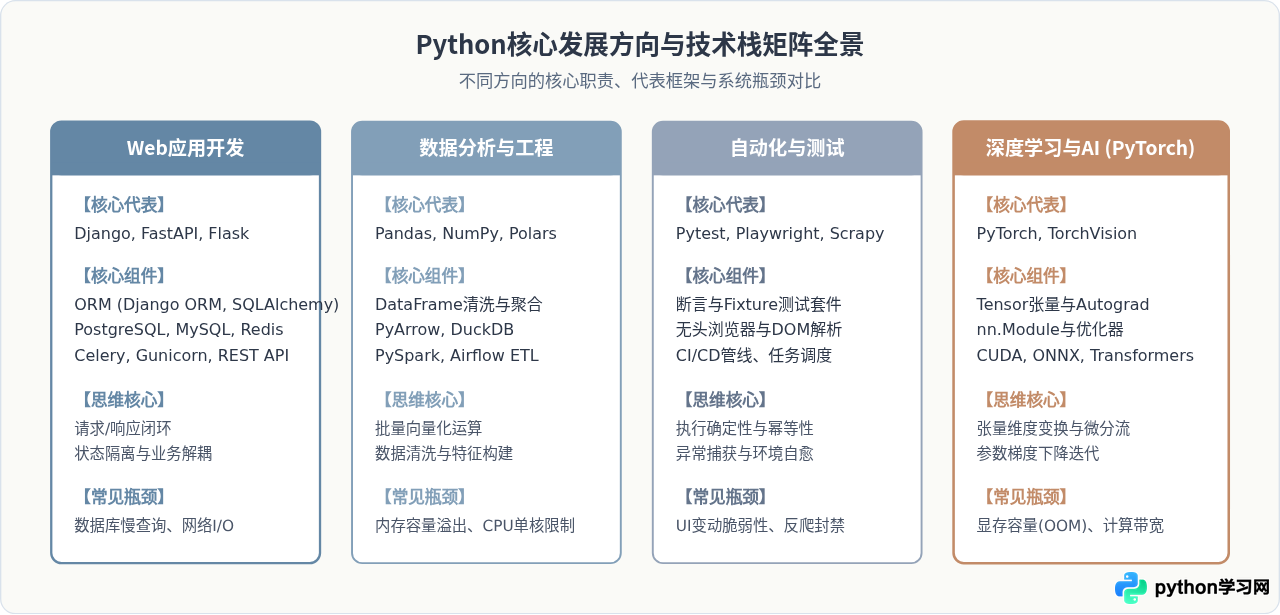
Python凭借其清晰的语法与庞大的生态,在软件工业中分化出了数个定位鲜明的专业领域。虽然所有方向都共享Python的基础语法(如面向对象、闭包、生成器与上下文管理器),但各领域的工具链深度与核心解决目标存在本质差异:
- Web全栈与后端服务:以Django、FastAPI、Flask为代表,核心任务是处理HTTP请求、协调数据库事务(ORM)、管理会话鉴权与异步并发任务队列。其瓶颈通常集中在网络I/O、SQL查询优化与Redis缓存设计。
- 数据分析与数据工程:以Pandas、NumPy、Polars、PySpark为主导,聚焦结构化/半结构化数据的批量抽取、转换与加载(ETL),重点在于高效统计聚合与分布式流水线构建。
- 自动化测试与运维脚本:依托Pytest、Playwright、Paramiko等工具,解决持续集成、系统巡检与流程自动化问题。
- 机器学习与深度学习:以PyTorch、TensorFlow、Scikit-learn、Hugging Face为基石,核心围绕高维张量变换、可微分计算图、反向自动求导与GPU并行算力展开,解决复杂的模式识别与概率预测问题。
二、从Django到PyTorch的思维模型转变
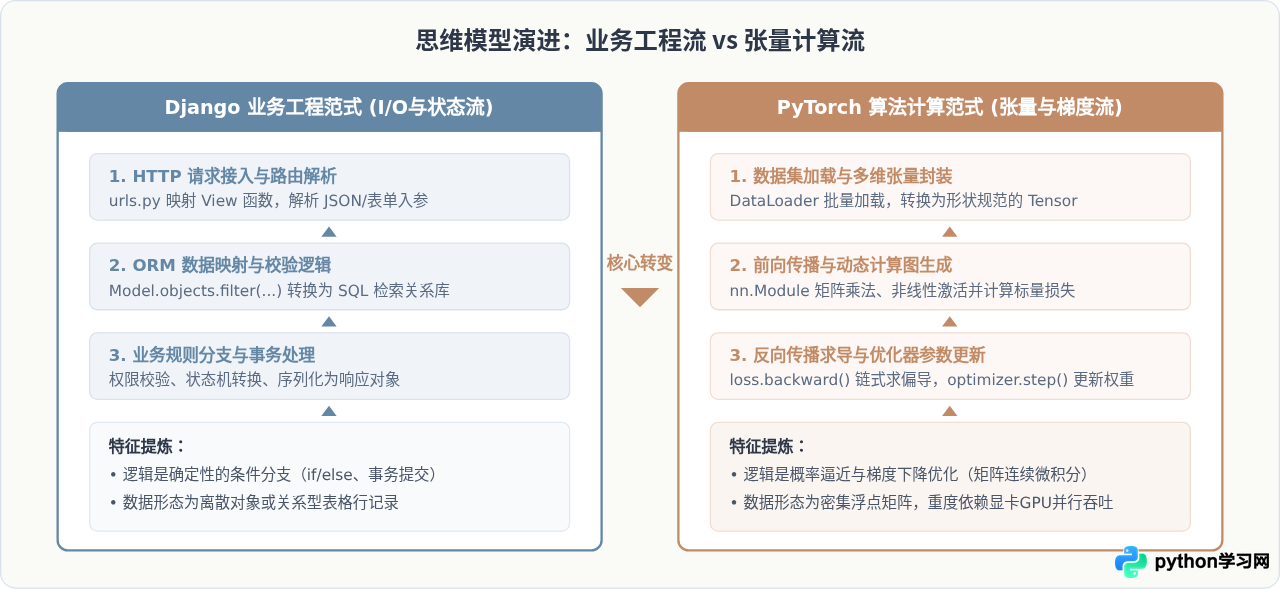
很多掌握Django的工程师在初学PyTorch时会感到挫败,原因在于试图用“面向对象业务开发”的直觉去套用“数值图计算”。理解两者的底层运转机制,是打破学习壁垒的第一步。
三个维度的关键差异剖析
- 数据形态:从对象实例到高维密集张量。在Django中,数据通常被组织为
User、Order等ORM模型对象,属性包含字符串、整数、时间戳。而在PyTorch中,现实世界的所有信息(图像、音频、文本Token、表格)必须被转化为高维浮点数张量(Tensor),如[batch_size, channels, height, width]。开发者必须随时在脑海中建立对张量“Shape(形状)”的感知能力。 - 逻辑构建:从业务条件分支到前向反向拓扑图。Django中通过编写
if request.method == 'POST':来控制流程;PyTorch则定义前向数学变换y = Wx + b,并隐式记录计算图,在调用backward()时自动沿计算图反向追溯导数并更新权重矩阵。 - 算力依赖:从多进程I/O调度到硬件加速器通信。Django部署主要靠多Worker(如Gunicorn、Uwsgi)承载并发请求,瓶颈在I/O等待;PyTorch运算大量由CUDA驱动,重点在于如何最大化利用GPU的核心流水线,并避免CPU到GPU之间的数据拷贝延迟。
三、进入PyTorch前必须补齐的核心技术储备
很多开发者直接阅读PyTorch源码或Transformer论文时感到如看天书,根本原因在于跳过了基础支撑层。要顺利学习PyTorch,必须按序补足以下三层知识:
1. 数值计算核心工具:NumPy的底层操作
NumPy是Python科学计算的基石,PyTorch张量的大多数API(如切片、轴变换、拼接)在设计上直接继承了NumPy标准。必须熟练掌握以下操作:
- 数组切片与维度索引:灵活使用多维索引
arr[:, 0:10, ...]。 - 广播机制(Broadcasting):理解形状不同的两个矩阵在何时能够直接相加。广播规则要求两个数组在某个维度上的长度要么相等,要么其中一个为1。
- 轴聚合(Axis / Dimension):明确
sum(axis=0)与sum(axis=1)对形状的改变,这是理解神经网络池化层与注意力机制计算的前提。
2. 必要的数学基础(聚焦几何直觉而非繁琐计算)
工程背景的开发者不需要从头背诵高等数学公式,但必须建立清晰的几何直觉:
- 矩阵乘法与维度匹配:若矩阵A的形状为
(M, K),矩阵B的形状为(K, N),则乘积为(M, N)。神经网络的每一层本质上就是矩阵乘法变换。 - 导数与偏导数:理解导数表示“输入微调时输出的变化方向和幅度”。损失函数的负梯度方向,就是让预测误差缩小的最快参数调整方向。
- 学习率的作用:若步长过小,模型收敛缓慢;若步长过大,参数震荡发散。
3. PyTorch四大核心API与模块机制
torch.Tensor:类似于NumPy的ndarray,但具备两个关键特性——能够驻留在GPU显存中、能够附加梯度记录(requires_grad=True)。torch.autograd:动态自动求导引擎。每次前向计算动态搭建图,反向时自动链式法则求导。torch.nn.Module:所有神经网络层的基类。必须重写__init__声明子层,以及重写forward定义前向计算逻辑。torch.utils.data.DataLoader:负责批量组织、乱序打乱(Shuffle)与多进程预加载数据,是连接磁盘数据与GPU显存的桥梁。
四、实操演练:编写标准的PyTorch训练流水线
为了让Django背景的开发者建立对PyTorch的直观认识,下面给出一个完整的回归预测训练示例。它对应了标准PyTorch开发的标准生命周期:定义数据集 → 搭建模型 → 设置损失与优化器 → 周期迭代(Epoch):
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import TensorDataset, DataLoader

# 1. 准备合成数据:模拟房价或数值预测特征 (100个样本,每个样本3个特征)
# 注意:PyTorch中浮点数据必须是 float32 格式
torch.manual_seed(42)
X_data = torch.randn(100, 3)
# 真实规律:y = 1.5*x0 - 2.0*x1 + 0.5*x2 + 噪声
y_data = 1.5 * X_data[:, 0:1] - 2.0 * X_data[:, 1:2] + 0.5 * X_data[:, 2:3] + 0.1 * torch.randn(100, 1)

dataset = TensorDataset(X_data, y_data)
loader = DataLoader(dataset, batch_size=16, shuffle=True)

# 2. 定义模型结构:继承 nn.Module
class LinearRegressionModel(nn.Module):
    def __init__(self, input_dim):
        super(LinearRegressionModel, self).__init__()
        # 定义一个全连接线性层:y = x * W^T + b
        self.linear = nn.Linear(input_dim, 1)

    def forward(self, x):
        # 定义前向传播路径
        return self.linear(x)

# 3. 实例化模型、损失函数与优化器
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = LinearRegressionModel(input_dim=3).to(device)

criterion = nn.MSELoss()  # 均方误差损失函数
optimizer = optim.SGD(model.parameters(), lr=0.05)  # 随机梯度下降优化器

# 4. 标准训练循环 (50个 Epoch)
for epoch in range(1, 51):
    model.train()
    total_loss = 0.0

    for batch_x, batch_y in loader:
        batch_x, batch_y = batch_x.to(device), batch_y.to(device)

        # 核心关键步骤 A:清除上一步累加的梯度 (必须牢记!)
        optimizer.zero_grad()

        # 核心关键步骤 B:前向预测
        predictions = model(batch_x)

        # 核心关键步骤 C:计算损失标量
        loss = criterion(predictions, batch_y)

        # 核心关键步骤 D:反向传播计算各权重梯度
        loss.backward()

        # 核心关键步骤 E:依据梯度更新模型权重
        optimizer.step()

        total_loss += loss.item() * batch_x.size(0)

    avg_loss = total_loss / len(dataset)
    if epoch % 10 == 0:
print(f"Epoch [{epoch:02d}/50], 均方损失: {avg_loss:.4f}")optimizer.zero_grad()。因为PyTorch的设计中梯度是默认累加的(以便支持超大Batch切分),如果遗漏此行,旧批次的梯度会不断叠加,导致模型权重更新失控发散。
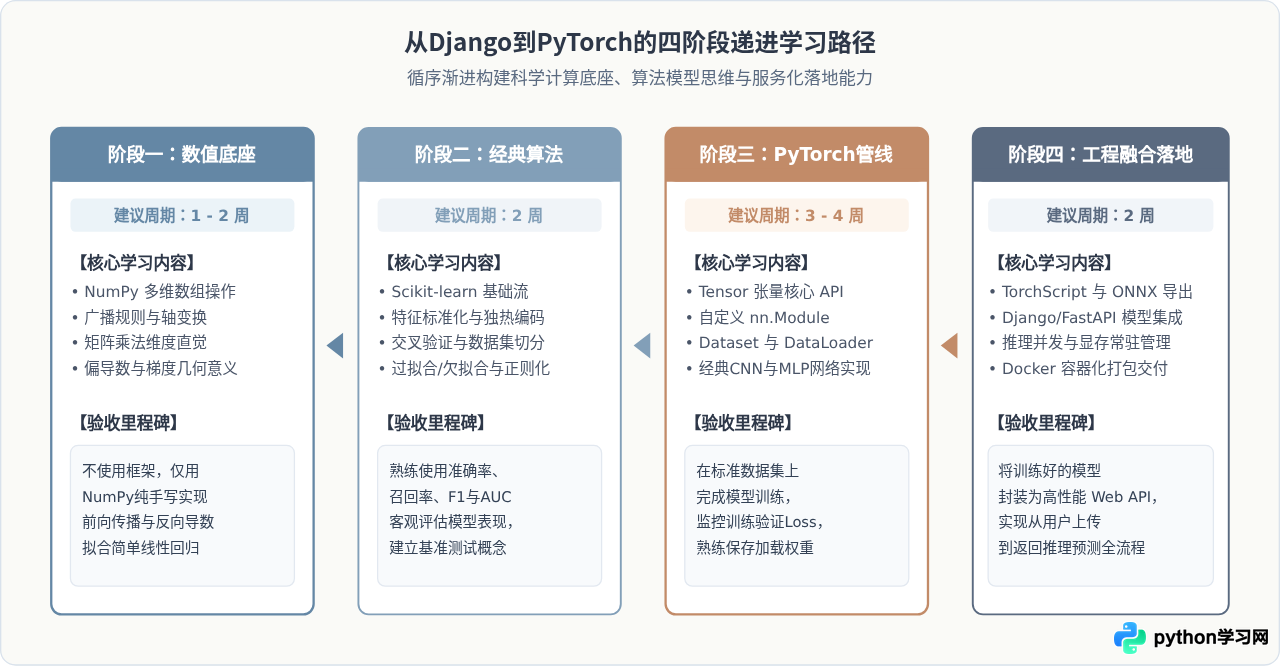
五、从Django跨越到PyTorch的四阶段学习路径
从纯Web开发过渡到深度学习工程,盲目扎入论文容易半途而废。按照渐进递进的四阶段规划,能够帮助开发者在每个阶段都有可验证的交付成果:
六、优势转化:Web工程师在AI工程化中的独特价值
很多纯算法研究人员往往专注于优化损失函数指标,但在模型部署上线、高可用吞吐、接口鉴权与前后端集成时缺乏工程经验。而拥有Django背景的开发者在进入PyTorch领域后,具有天然的“全链路工程化”优势:
- 端到端服务化交付能力:不仅能读懂模型,还能迅速通过FastAPI或Django REST framework封装推理API,设计异步队列与长连接协议。
- 生产级健壮性把控:熟悉日志追踪、限流熔断、数据库连接池、分布式任务调度等机制,能将脆弱的研究脚本改造成工业级可用微服务。
- 模型生命周期管理(MLOps):将模型版本管理、训练数据归档、监控报警与Web后台系统深度结合,形成持续迭代闭环。
七、核心技术栈迁移总结
为了帮助读者在知识迁移过程中快速建立对照索引,下表总结了从Django到PyTorch在各个工程维度的核心对照点:
| 工程维度 | Django Web工程 | PyTorch 深度学习 | 融合落地场景 |
|---|---|---|---|
| 核心数据载体 | ORM模型对象 / 关系型数据库行记录 | N维浮点张量 (Tensor) | 用户请求JSON → 序列化为Tensor → 推理结果转JSON |
| 代码组织中心 | View视图函数 / Model模型类 | 继承自 nn.Module 的网络类 |
在 Django View 初始化时加载模型单例进行推理 |
| 执行计算单元 | 多核 CPU (网络I/O等待为主) | GPU / TPU (大规模矩阵乘法) | CPU处理业务逻辑与权限,GPU专职执行批量预测 |
| 状态存储机制 | PostgreSQL / MySQL / Redis缓存 | 权重字典 (state_dict / .pth 文件) | 对象存储S3存放模型权重,数据库记录模型版本元信息 |
| 高频排错重点 | N+1查询、死锁、HTTP 500、跨域CORS | 张量Shape不匹配、梯度消失/爆炸、CUDA OOM | 并发请求下的显存争抢溢出、模型热更新锁竞争 |
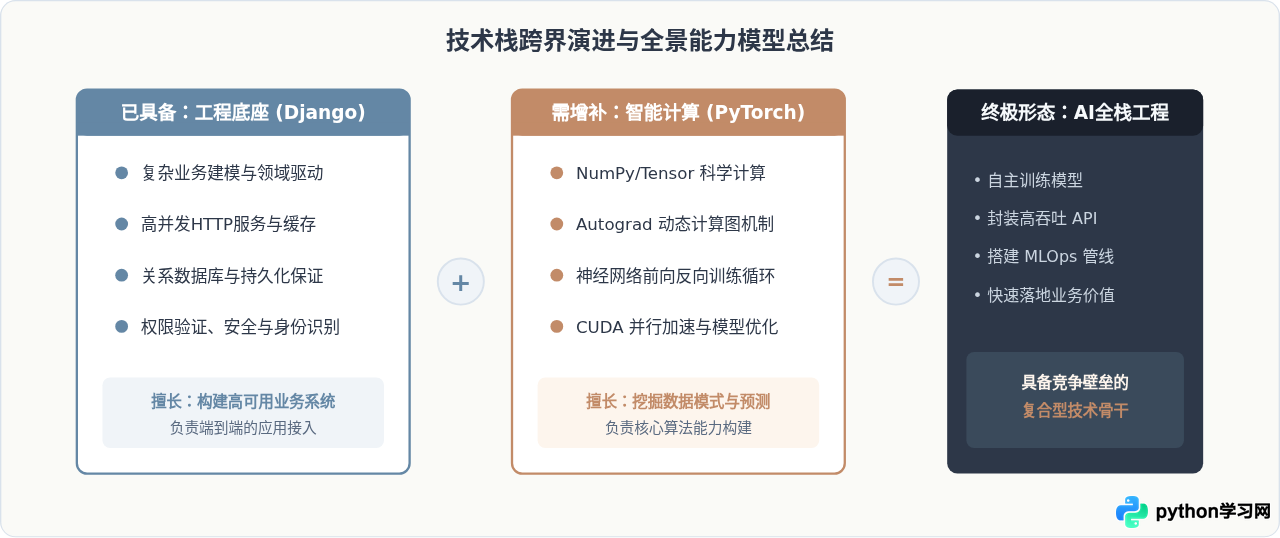
总而言之,从Django走向PyTorch并非彻底抛弃过去的工程积累,而是将已有的系统设计、接口构建与高并发服务能力,嫁接到以高维张量计算与深度模型为核心的AI底座之上。按照“科学计算底座 → 经典模型直觉 → PyTorch标准训练流 → 模型服务化部署”的路线稳步推进,每一位Python工程师都能平滑完成技术跃迁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









