

MySQL实现中文排序的正确方法
MySQL默认字符集不支持中文正确排序,导致查询结果混乱。本文介绍三种解决方法:为字段添加binary属性进行二进制比较;重新编译MySQL并指定--with-charset=gbk参数;或在SQL查询中使用CONVERT函数及COLLATE gbk_chinese_ci强制按拼音排序。
2026-10-15
6

MySQL默认字符集不支持中文正确排序,导致查询结果混乱。本文介绍三种解决方法:为字段添加binary属性进行二进制比较;重新编译MySQL并指定--with-charset=gbk参数;或在SQL查询中使用CONVERT函数及COLLATE gbk_chinese_ci强制按拼音排序。
Oracle基于代价的优化器(CBO)通常能选择最优执行计划,但在统计信息缺失或数据分布极端时可能失效。DBA可通过添加HINTS提示强制指定表的访问路径(如全表扫描、索引扫描)、连接类型及顺序。本文解析Hints语法规范、常见类型及使用注意事项,帮助解决特定SQL执行缓慢的问题。
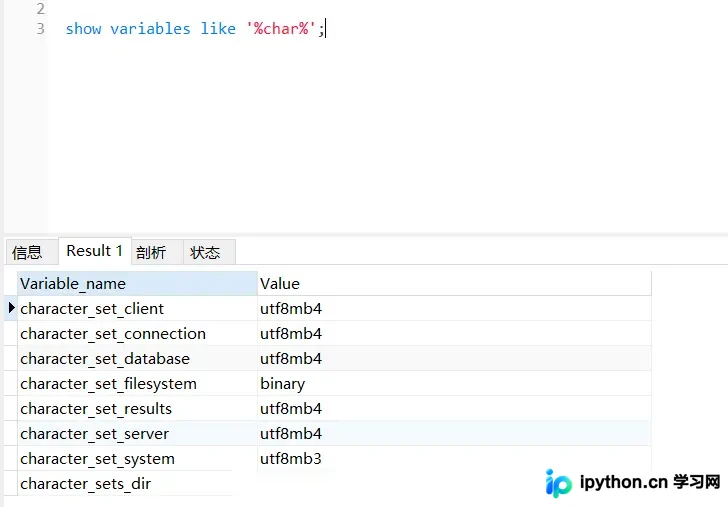
本文详解MySQL字符集与排序规则的应用,涵盖版本差异(latin1与utf8mb4)、常用SQL查询命令、配置文件修改方法以及各类后缀的含义。通过具体操作指导如何设置正确的字符集以彻底解决中文乱码问题,确保数据准确存储与比较。
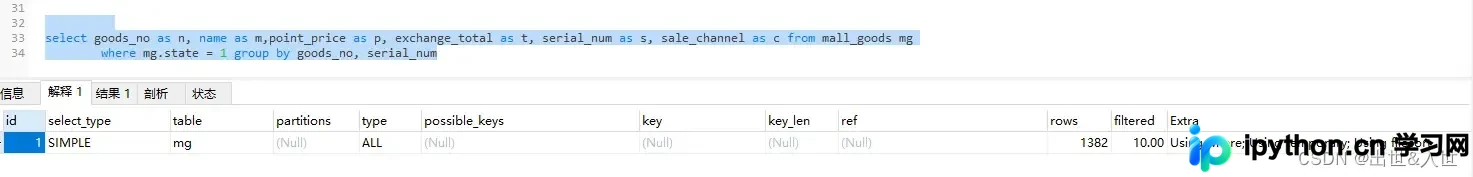
本文系统梳理了 MySQL 慢 SQL 优化的核心思路与开发规范,涵盖索引设计的六大原则(如最左前缀、避免冗余)、查询语句的十七项规范(如禁止 SELECT *、大分页处理)。通过 EXPLAIN 分析和代码示例,帮助开发者识别 Using temporary/filesort 等性能瓶颈,提供从建表到 SQL 编写的完整优化方案。
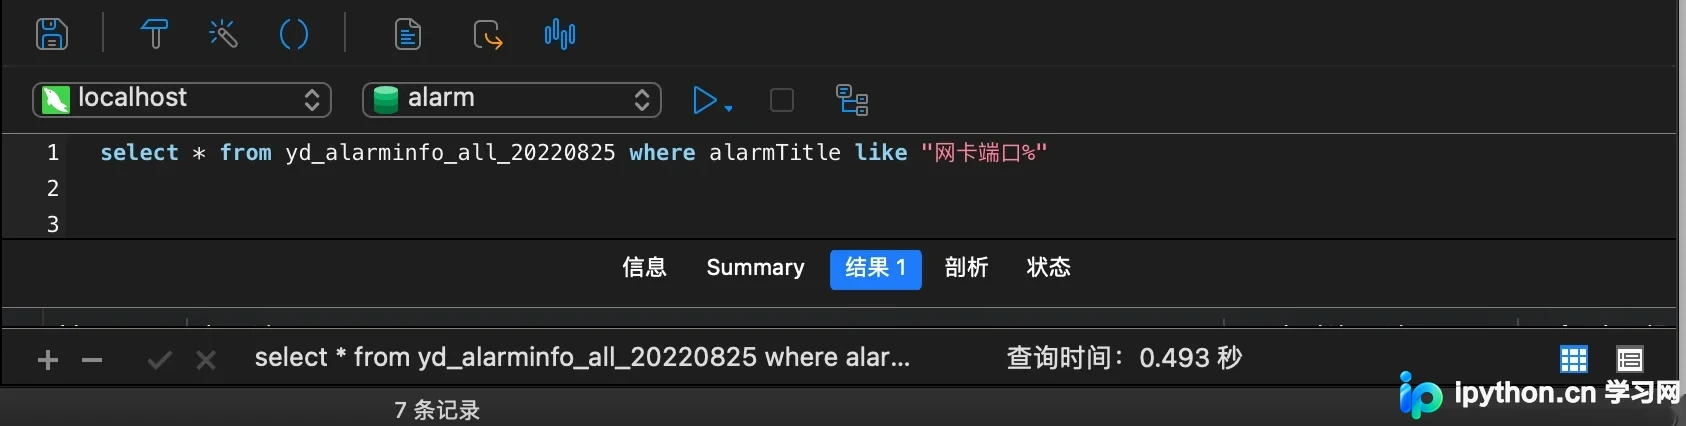
本文深入探讨 MySQL 中模糊查询(LIKE)的优化方案。通过实测对比,展示了普通索引、左前缀索引对查询效率的巨大提升(最高达数百倍)。同时验证了 LOCATE、POSITION 等函数无法替代索引加速,澄清了常见的 SQL 优化误区,为处理大数据量下的字符串搜索提供可靠参考。
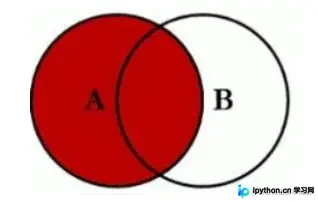
本文深入解析 MySQL JOIN 的七种连接类型及其底层执行原理,重点对比 Simple、Index 和 Block Nested-Loop Join 三种算法的性能差异。通过 Explain 工具分析驱动表选择、索引使用及 Join Buffer 机制,提供建立索引、调整 buffer size、避免隐式转换等核心优化策略,助您写出高效 SQL。
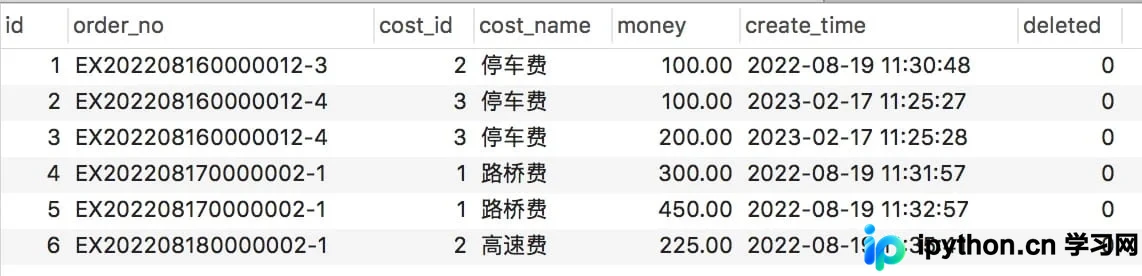
本文针对 MySQL 数据库中因业务 Bug 产生的重复脏数据,提供一种在保留“deleted”逻辑删除标记前提下,清理冗余记录并仅保留最新一条数据的方法。通过构建中间表规避 “You can't specify target table for update in FROM clause” 错误,实现高效的数据清洗。
深入解析 SQL Server 内存管理机制,涵盖虚拟内存体系结构、动态内存分配策略及缓冲区管理器工作原理。重点介绍 AWE 内存使用注意事项、从 2012 版本开始的任何大小页面分配器变化,以及针对长 I/O 请求的故障排查方法,帮助 DBA 优化系统性能。
本文深入解析MySQL索引的数据结构演变。从基础的全表扫描问题出发,探讨二叉搜索树、红黑树及B-Tree的局限性,重点阐述InnoDB引擎为何最终采用B+Tree作为索引结构,包括其叶子节点双向链表、磁盘IO优化及范围查询优势,帮助开发者理解索引底层逻辑以优化SQL性能。
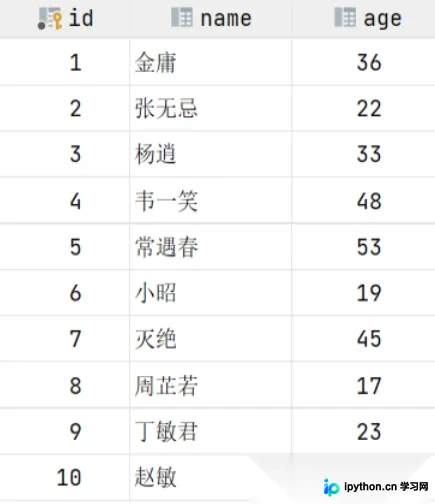
在处理MySQL数据库时,如何高效剔除重复数据是常见的SQL优化问题。本文详细解析并演示三种主流去重方案:适用于基础场景的DISTINCT语句、利用聚合逻辑的GROUP BY方法,以及针对复杂需求的窗口函数ROW_NUMBER()(含MySQL 8.0+与5.7及以下版本的差异写法)。通过真实代码示例帮助开发者选择最佳策略。
本文深入解析 MySQL 索引的分类(普通、唯一、主键、全文等)及底层存储原理,详细讲解 B-Tree 与 Hash 索引的区别。重点阐述多列索引的最左前缀匹配规则,并提供基于查询条件选择索引列、利用短索引和优化 SQL 语句的具体实践方法,帮助开发者提升数据库查询效率并降低写操作开销。
针对MySQL大表执行ALTER TABLE导致服务中断和耗时过长的问题,本文介绍了两种常见运维策略及底层原理。重点阐述了如何利用.frm文件特性快速修改列默认值和枚举常量,通过创建影子表和交换定义文件实现无重建表操作,从而显著缩短变更时间并降低业务影响。