

MySQL模糊查询优化:索引对比与常见误区实测

在 MySQL 大数据量场景下,模糊查询往往是性能瓶颈。本文通过实测数据对比分析了无优化查询、普通索引、左前缀索引以及非索引类函数优化的效果。结果表明,合理建立索引(包括普通索引和左前缀索引)是解决模糊查询性能问题的核心手段,而单纯改变 SQL 写法(如使用 locate)若无索引支持,效果微乎其微。
基准测试:无优化的全表扫描
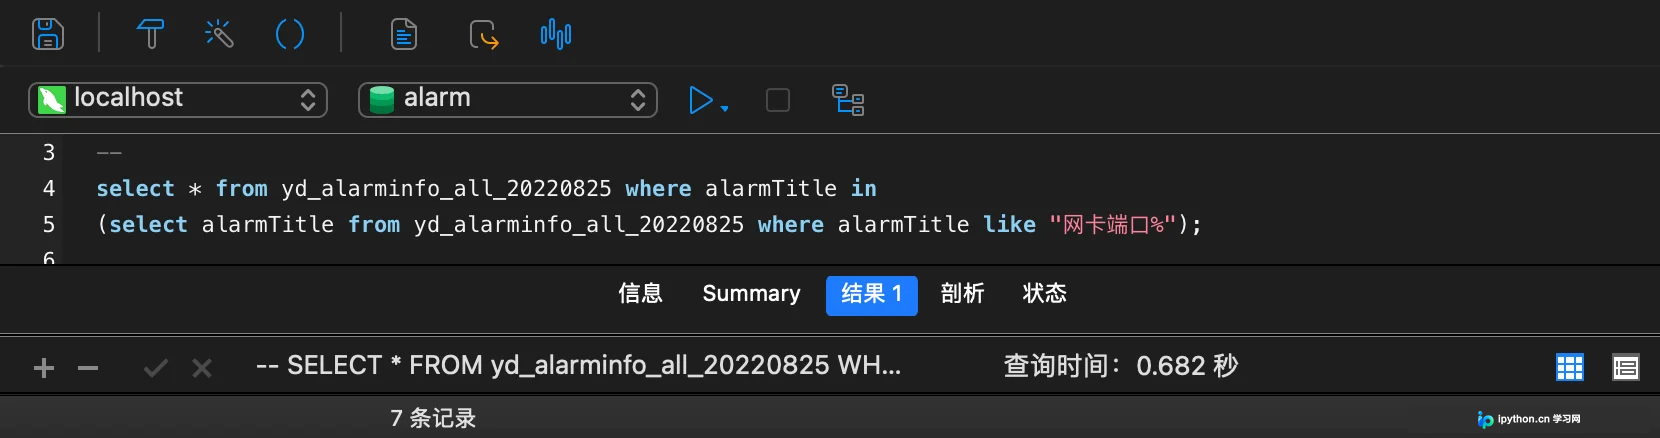
首先测试在最基础情况下的查询耗时。当字段未建立任何索引,且使用 LIKE 'xxx%'(以指定字符开头) 进行查询时,MySQL 只能进行全表扫描。
select * from yd_alarminfo_all_20220825 where alarmTitle like "网卡端口%";
-- 测试结果:耗时约 0.493 秒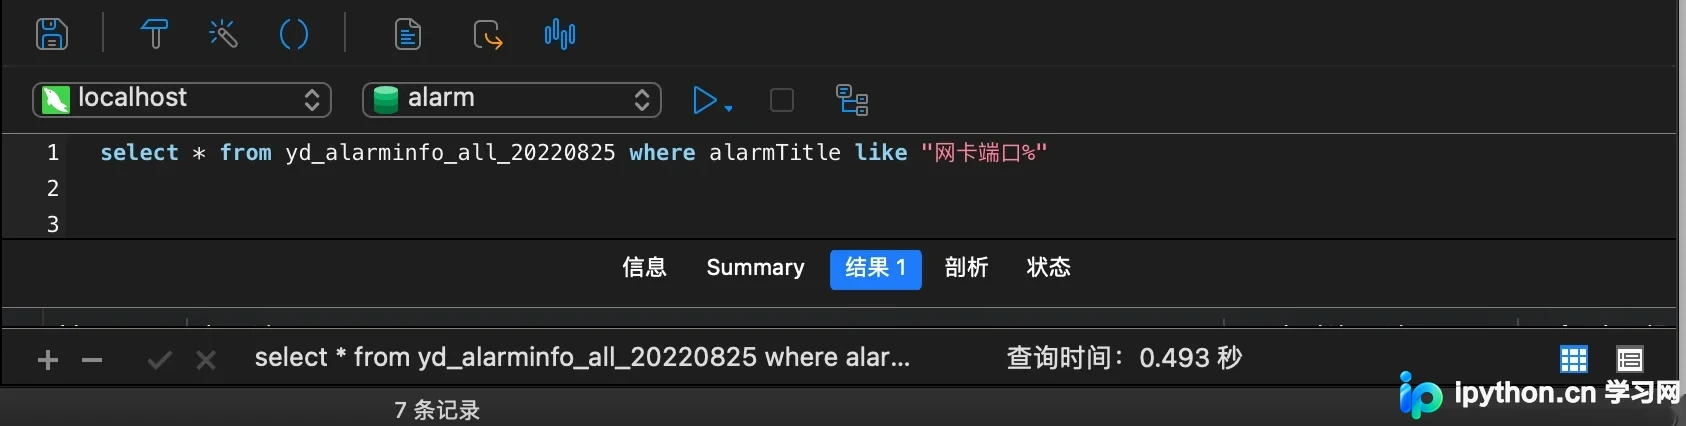
方案一:创建普通索引
由于查询条件是以固定字符串开头的模式匹配,可以在该字段上建立普通 B-Tree 索引。B-Tree 索引天然支持前缀匹配查询,能大幅减少扫描的行数。
第 1 步:创建索引并测试查询速度
- 操作入口:数据库管理工具或命令行
- 执行动作:执行
ALTER TABLE语句添加索引,随后重新执行上述查询
-- 创建普通索引
ALTER TABLE yd_alarminfo_all_20220825 ADD INDEX idx_title(alarmTitle);
-- 查询耗时:0.003 秒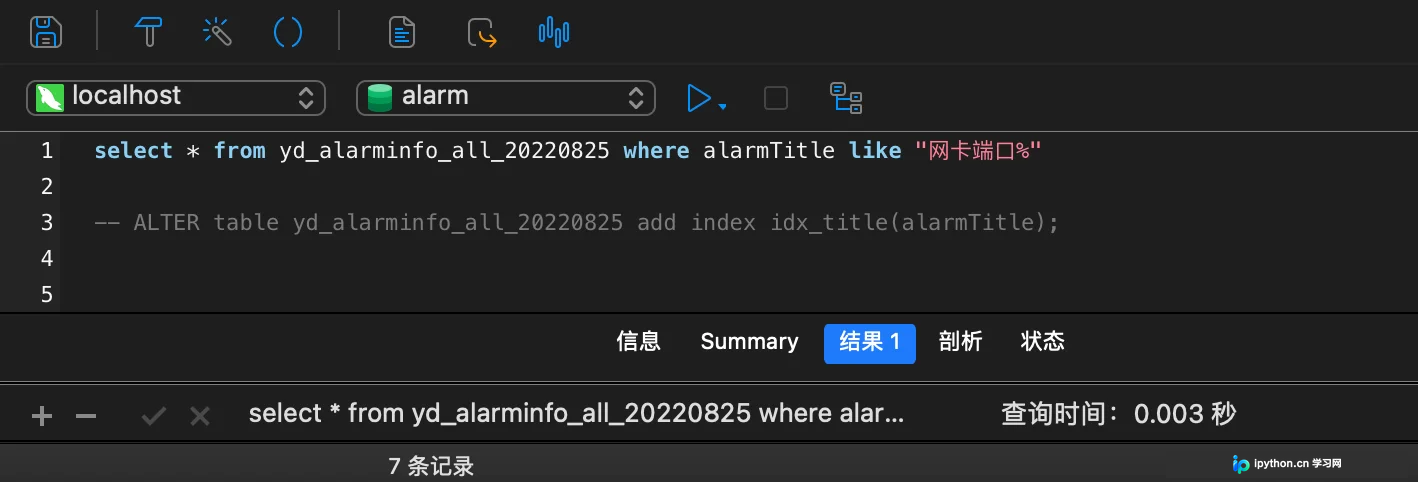
效果评估:相比未建索引时的 0.493 秒,耗时降至 0.003 秒,效率提升了约 164 倍。这证明在长文本字段进行前缀匹配时,普通索引是非常有效的。
方案二:利用左前缀索引节省空间
如果业务场景对存储空间敏感,或者字段极长,可以考虑使用“左前缀索引”。这种索引只截取字符串左侧的一部分字符建立索引树,从而缩小索引体积。
第 1 步:分析左前缀选择性以确定最佳长度
- 目的:找到索引长度与区分度(Selectivity)之间的平衡点。
- 方法:通过统计不同截取长度的去重比例,选择区分度高且长度较短的前缀。
SELECT COUNT(DISTINCT LEFT(alarmTitle, 3))/COUNT(*) AS sel3,
	COUNT(DISTINCT LEFT(alarmTitle, 5))/COUNT(*) AS sel5,
	COUNT(DISTINCT LEFT(alarmTitle, 7))/COUNT(*) AS sel7,
	COUNT(DISTINCT LEFT(alarmTitle, 9))/COUNT(*) AS sel9,
	COUNT(DISTINCT LEFT(alarmTitle, 11))/COUNT(*) AS sel11,
	COUNT(DISTINCT LEFT(alarmTitle, 13))/COUNT(*) AS sel13,
	COUNT(DISTINCT LEFT(alarmTitle, 15))/COUNT(*) AS sel15,
	COUNT(DISTINCT LEFT(alarmTitle, 17))/COUNT(*) AS sel17,
	COUNT(DISTINCT LEFT(alarmTitle, 19))/COUNT(*) AS sel19,
	COUNT(DISTINCT LEFT(alarmTitle, 21))/COUNT(*) AS sel21
FROM yd_alarminfo_all_20220825;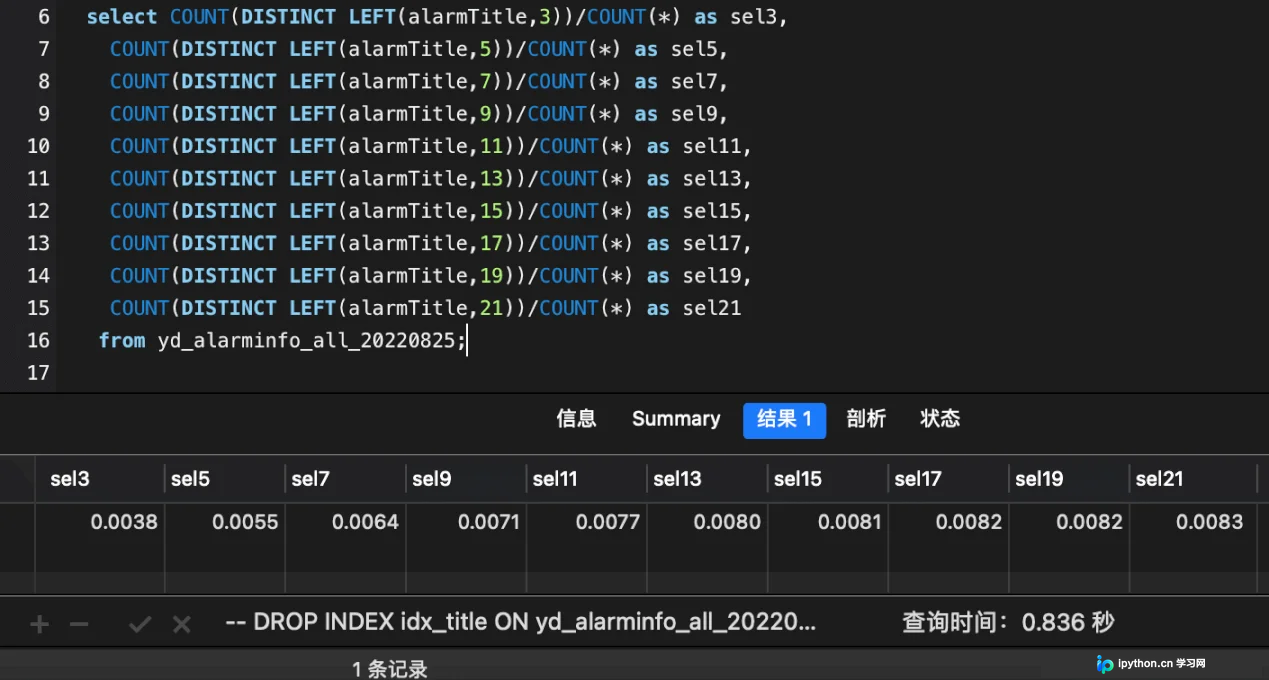
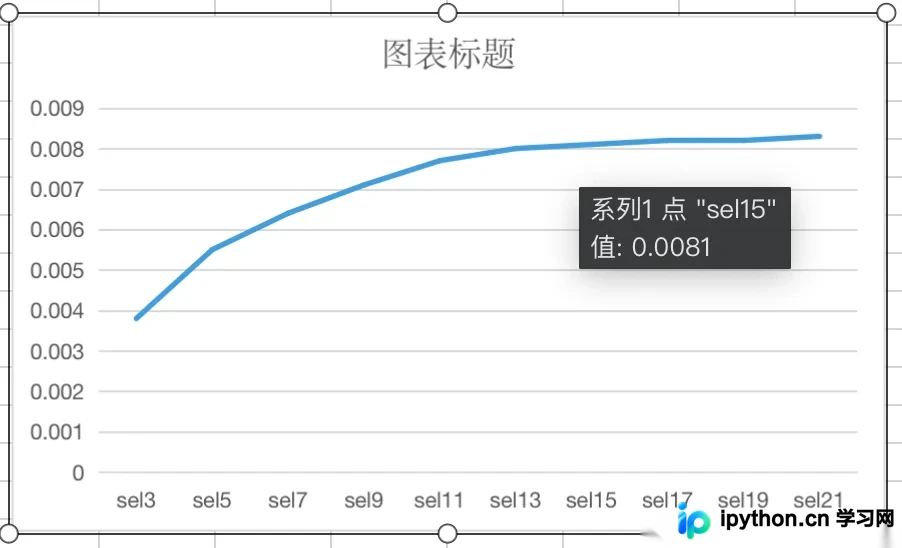
结果分析:如图表所示,当截取长度为某个阈值(如对应图中选择性达到 0.080 左右)之后,随着字符增加,选择性增幅开始趋缓。此时选取性价比最高的长度即可。
第 2 步:删除旧索引并创建左前缀索引
- 重要参数:
(15)代表截取的字符数量 - 注意:若实际查询词长度小于前缀长度,可能无法完全利用索引;若大于前缀长度,则部分范围需回表筛选,但通常仍能提速。
-- 删除之前的普通索引
DROP INDEX idx_title ON yd_alarminfo_all_20220825;
-- 创建长度为 15 的左前缀索引
ALTER TABLE yd_alarminfo_all_20220825 ADD INDEX idx_title_prefix(alarmTitle(15));
-- 查询耗时:约 0.01 秒(视具体缓存情况而定)
select * from yd_alarminfo_all_20220825 where alarmTitle like "网卡端口%";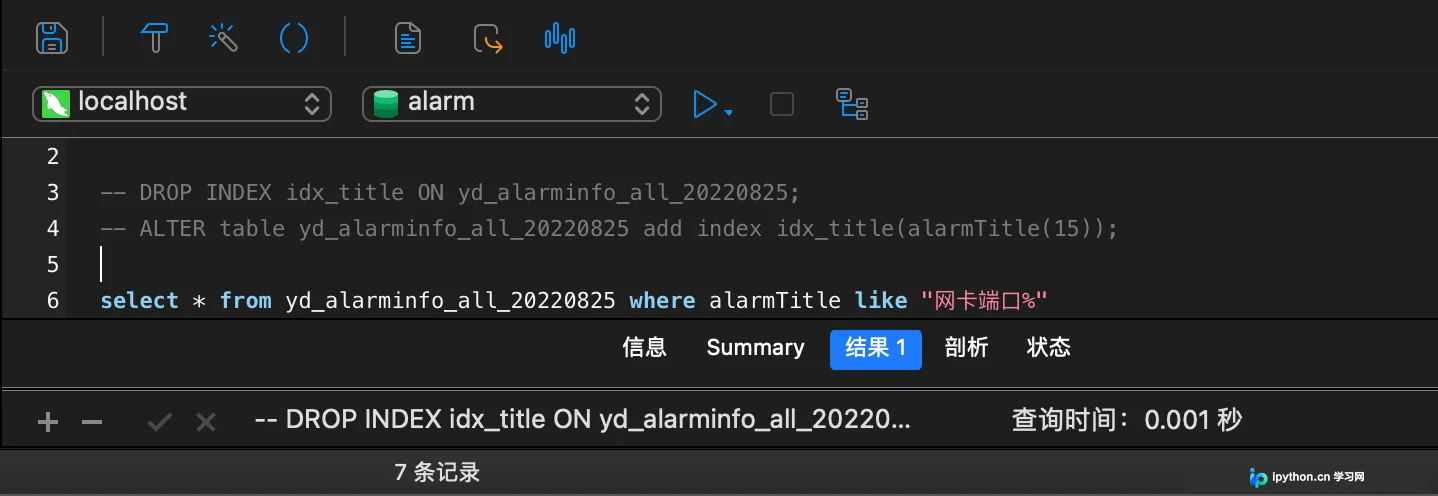
效果评估:相比于最初始的全表扫描(0.493秒),耗时依然有几十到上百倍的优化,显著高于无索引状态。
方案三:右后缀索引(不推荐用于常规优化)
如果需要优化的是尾部模糊查询(例如 LIKE '%xx'),可以通过触发器或生成列将字段内容反转,然后在反转后的字段上建立左前缀索引。但由于引入了额外字段存储,增加了空间开销和维护成本,其综合性价比往往不如直接优化表结构或使用全文索引。
方案四:非索引类 SQL 函数优化测试
网络上流传着一些不使用索引,而是通过特殊函数来加快搜索的说法。为了严谨起见,我们进行了以下实测。注意以下测试均在删除了索引后的环境下运行。
测试 1:使用 LOCATE()
LOCATE 用于返回子串第一次出现的位置。但它本质上仍是逐行遍历匹配。
SELECT * FROM yd_alarminfo_all_20220825 WHERE LOCATE('网卡端口', alarmTitle) > 0;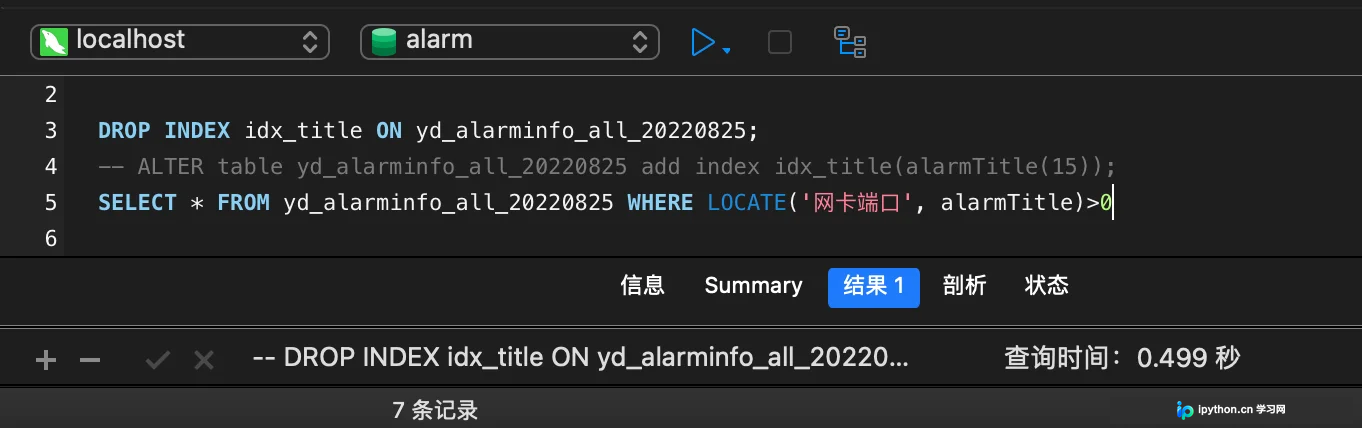
耗时:约 0.499 秒。结论:无效,几乎等同于全表扫描。
测试 2:使用 POSITION()
POSITION 是 LOCATE 的标准 SQL 别名,原理一致。
SELECT * FROM yd_alarminfo_all_20220825 WHERE POSITION('网卡端口' IN alarmTitle);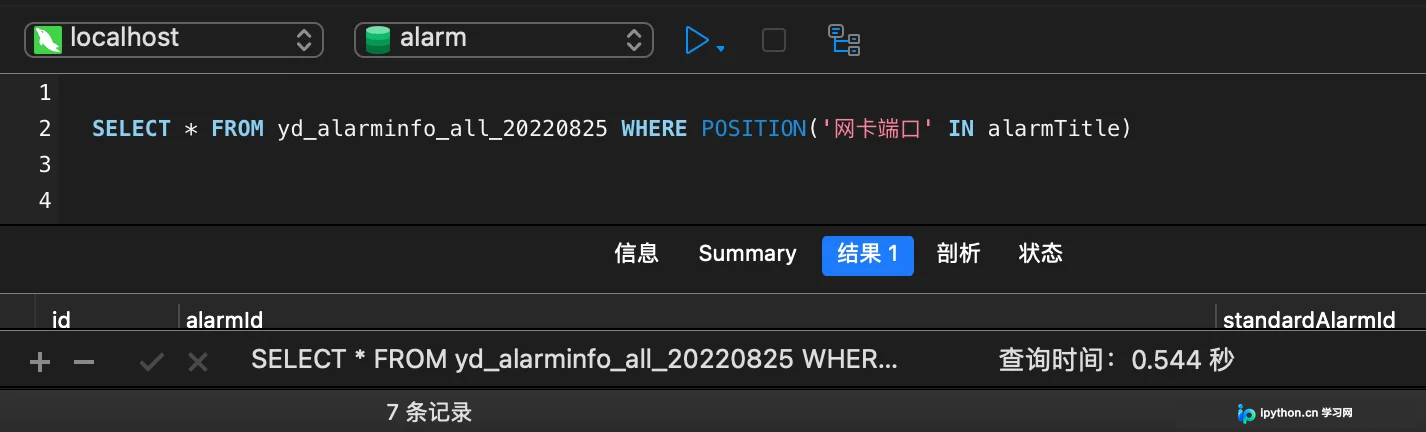
耗时:约 0.544 秒。结论:无效。
测试 3:使用 INSTR()
同样基于字符串查找函数。
SELECT * FROM yd_alarminfo_all_20220825 WHERE INSTR(alarmTitle, '网卡端口') > 0;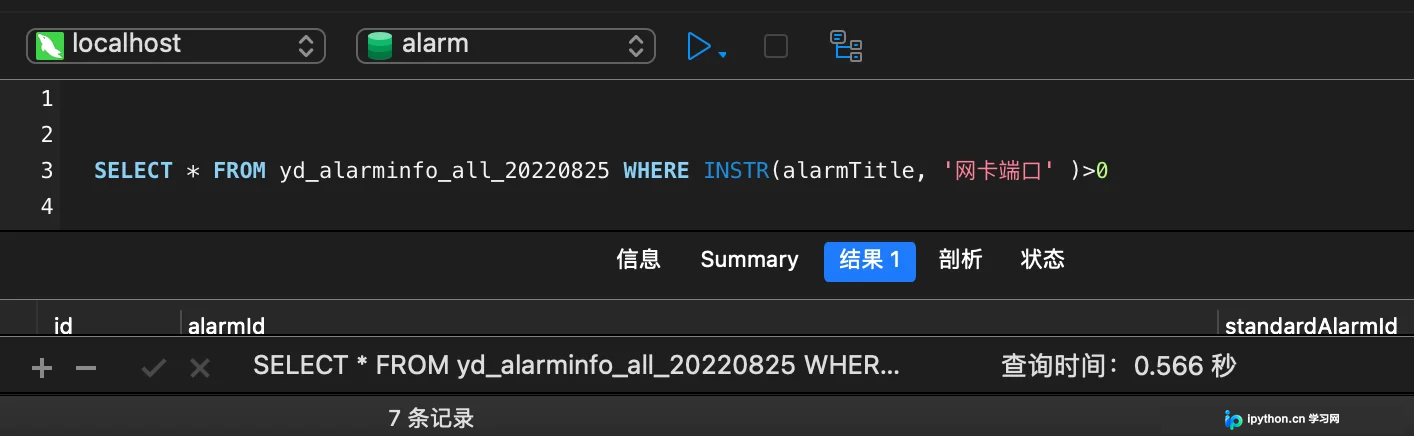
耗时:约 0.566 秒。结论:无效。
总结
经过多组对比测试可以明确:
- 索引为王:无论是普通索引还是左前缀索引,都能使 MySQL 的模糊查询效率实现指数级提升。
- 避免误区:诸如
LOCATE、INSTR等函数在没有底层索引配合的情况下,无法突破 B+ 树的限制,不能用来优化性能。 - 技术取舍:面对超大规模数据的复杂中文模糊搜索,如果索引无法满足需求,应优先考虑升级至 Elasticsearch 等专业搜索引擎;若在 MySQL 内解决,务必确保查询条件符合最左前缀原则。
以上就是 MySQL 模糊查询优化方法及测试详细讲解的内容,更多关于 MySQL 性能调优的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









