

SQL Server 参数化 SQL 的 Parameter Sniff 问题与优化方案
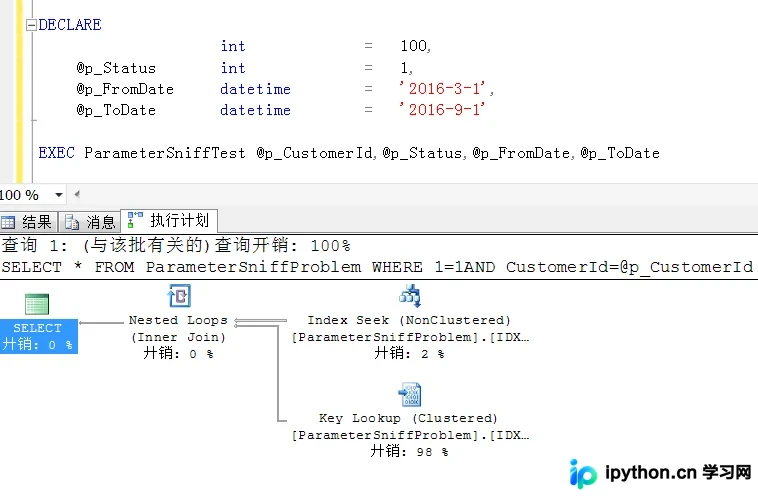
在 SQL Server 中,数据分布不均常导致参数化存储过程产生 Parameter Sniff(参数嗅探)现象,即错误的执行计划被重用。本文通过模拟测试展示了该问题的成因及表现,并提供了一种针对高风险参数的“混合参数化”解决方案:对易引发数据倾斜的参数直接使用字符串拼接以触发按需重编译,其余条件保持参数化以复用执行计划,从而在避免极端性能下降的同时平衡缓存效率。
2026-10-13
6

在 SQL Server 中,数据分布不均常导致参数化存储过程产生 Parameter Sniff(参数嗅探)现象,即错误的执行计划被重用。本文通过模拟测试展示了该问题的成因及表现,并提供了一种针对高风险参数的“混合参数化”解决方案:对易引发数据倾斜的参数直接使用字符串拼接以触发按需重编译,其余条件保持参数化以复用执行计划,从而在避免极端性能下降的同时平衡缓存效率。
本文详解Yii2中ActiveRecord实现多表一对一关联的方法,重点解决GridView展示关联字段导致的N+1查询性能问题。通过调整search模型中的JOIN策略,将多次单表查询优化为单次LEFT JOIN,同时演示如何在search模型中添加自定义属性以实现对关联字段的安全搜索。
解决MySQL插入中文出现乱码问题,通常涉及客户端、连接层和服务器端的字符集统一。本文介绍了五种常用方法,包括通过命令行参数、SQL脚本指令以及修改my.cnf配置文件实现永久生效。推荐采用UTF8字符集并在配置文件中指定默认字符集,以确保数据存储的一致性。
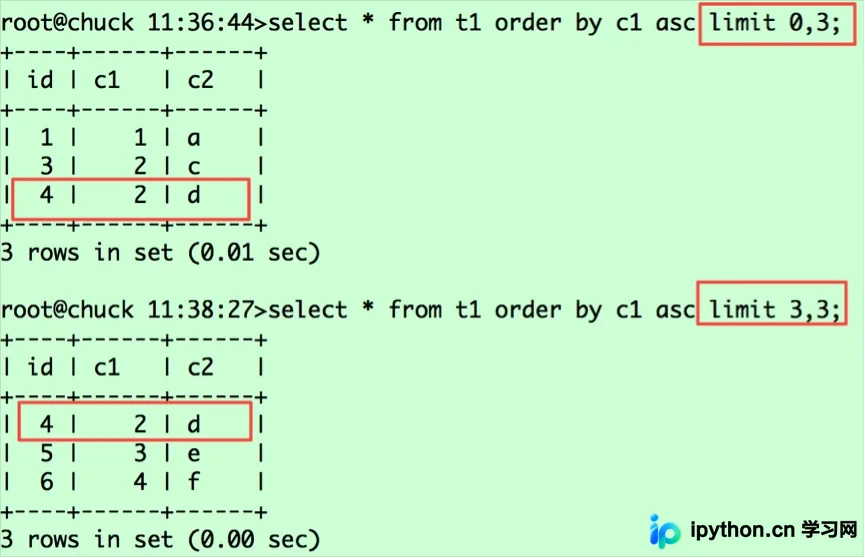
针对 MySQL 数据量达到百万级时,深页查询 LIMIT offset, length 导致扫描行数过多、性能骤降的问题。本文总结子查询优化法、反向查找法及限制偏移量等策略,通过减少回表扫描和降低偏移量,显著提升大表分页查询速度。
本文深入解析 MySQL 的排序机制,探讨如何利用有序索引避免昂贵的 Filesort。详细对比常规排序、优化排序与优先队列排序(堆排序)的执行流程与资源消耗。针对 MySQL 5.6+ 版本常见的分页数据重复问题,分析非稳定排序导致的根因并提供解决方案,同时通过实际案例说明因元组长度差异引发的排序结果不一致现象及自定义字段排序技巧。
本文系统梳理了MySQL中索引管理的核心操作。详细解析了如何创建普通、唯一、全文及空间索引,包括使用字段前缀优化存储的技巧;演示了通过ALTER TABLE删除或重建索引来实现修改的方法;并提供了SHOW INDEX命令查看表索引结构的完整语法。涵盖不同存储引擎下的索引类型限制及TEXT/BLOB字段的处理规范,帮助开发者高效维护数据库性能。
本文详细对比MySQL中常用的MyISAM、InnoDB和NDBCluster三种存储引擎的特性。重点分析它们在事务支持、锁定机制、缓存能力及适用场景上的差异,并提供针对各引擎的最佳实践配置建议,帮助开发者根据业务需求(如高并发读取、事务一致性或分布式部署)做出正确选型。
通过结合 CHARINDEX 函数与 CASE WHEN 语句,在 SQL Server 中构建单条查询逻辑,解决多参数模糊搜索问题。该方法避免了程序端拼接字符串或生成动态SQL带来的注入风险与逻辑冗余。同时涵盖数据透视(交叉表)及按范围分组统计等常见高级用法。
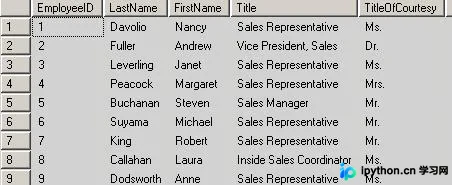
本文详解MySQL中处理重复数据的两个核心关键字:DISTINCT和GROUP BY。通过具体SQL示例,对比两者在单字段去多字段展示、返回记录规则及聚合函数配合上的差异,帮助开发者根据需求选择最合适的去重方案。
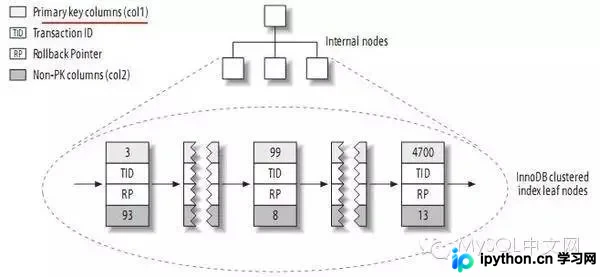
本文详解MySQL主键索引(PRIMARY KEY)与辅助索引(SECONDARY KEY)的核心区别。重点阐述InnoDB引擎下主键作为聚集索引的性能优势,以及MyISAM与InnoDB在索引存储结构上的差异。提供基于自增列、唯一性的主键设计三原则,并对比不同索引类型在百万级数据检索中的性能损耗数据。
本文详解 MySQL InnoDB 存储引擎中的聚集索引(聚簇索引)概念。阐述其通过主键逻辑顺序决定数据物理存储顺序的特性,对比索引组织表(IOT)与堆组织表(HOT)的性能差异。梳理 InnoDB 自动选择聚集索引的三条核心规则,分析其对范围查询、更新碎片及回表开销的影响。
本文详解MySQL中UPDATE语句的基础语法,包括单字段、多字段及空值更新。针对百万级数据更新导致的执行缓慢问题,通过对比测试验证使用INSERT...SELECT结合JOIN的方式可大幅缩短执行时间(从数十分钟降至十几秒),为高并发或大数据量场景下的表结构重构与数据填充提供高效解决方案。