MySQL 索引原理与实战指南:从创建到 EXPLAIN 优化
本文深入解析 MySQL 索引的底层原理,详细介绍 B-Tree、哈希等算法及四种索引类型。通过 EXPLAIN 命令详解执行计划各字段含义,指导开发者识别全表扫描并优化查询。重点阐述组合索引的最左前缀匹配原则、前缀索引技巧,以及函数运算、模糊查询和 OR 条件等导致失效的场景,帮助提升数据库检索性能。
2026-10-13
6

本文深入解析 MySQL 索引的底层原理,详细介绍 B-Tree、哈希等算法及四种索引类型。通过 EXPLAIN 命令详解执行计划各字段含义,指导开发者识别全表扫描并优化查询。重点阐述组合索引的最左前缀匹配原则、前缀索引技巧,以及函数运算、模糊查询和 OR 条件等导致失效的场景,帮助提升数据库检索性能。
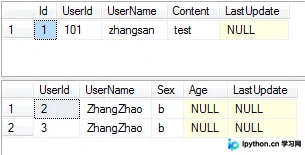
本文详细解析SQL Server中MERGE函数的使用方法。MERGE关键字用于根据源表数据对目标表执行插入、更新或删除操作,是高效实现数据同步的利器。文中涵盖基本语法结构、匹配逻辑(WHEN MATCHED/NOT MATCHED)、注意事项及具体代码示例,帮助开发者掌握这一DML命令以提升ETL处理效率。
本文详解MySQL联合索引(复合索引)的核心机制,包括最左前缀匹配原则、对ORDER BY排序的优化条件,以及不同存储引擎下覆盖索引的差异。通过创建语法、查询案例和常见性能陷阱分析,帮助开发者掌握高效建索引起设计策略。
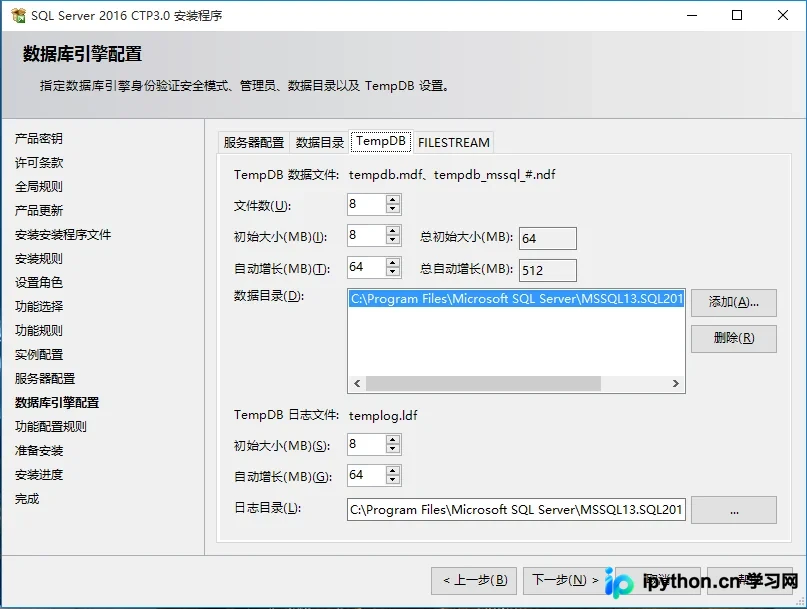
本文解析 SQL Server 2016 在 TempDB 方面的两项关键改进。首先,安装向导根据 CPU 核心数自动配置 TempDB 数据文件数量,有效缓解高并发下的闩锁竞争问题;其次,TempDB 默认采用统一区(Uniform Extent)分配模式,不再混合使用混合区,从而显著减少 SGAM 页的竞争并简化了之前需要开启的跟踪标记设置。
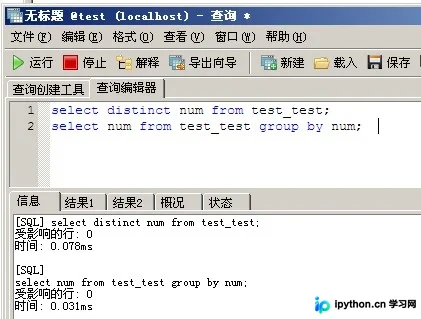
本文通过创建10万条数据的测试表,分别模拟无索引和有索引两种场景,使用Profiling工具精确测量MySQL中DISTINCT与GROUP BY的执行耗时。测试表明,在建立索引后两者执行极快,但综合来看GROUP BY始终略优于DISTINCT,推荐在实际开发中优先选用GROUP BY以提升查询效率。
本文系统梳理了 SQL Server 数据库优化的核心经验,重点涵盖聚簇索引的适用场景、避免 NULL 值导致的索引失效、IN 与 EXISTS 的效率差异、以及防止全表扫描的查询编写技巧。通过合理的索引设计与规范的 SQL 语法,可显著减少 I/O 次数并提升查询性能。
针对 MySQL 数据量庞大时传统 LIMIT 分页导致的性能下降问题,介绍使用窗口函数 ROW_NUMBER() 进行高效分页的原理。提供包含建表、插入测试数据及定义存储过程的完整 SQL 脚本,展示如何通过过滤行号范围快速获取指定页码数据,从而提升查询响应速度。
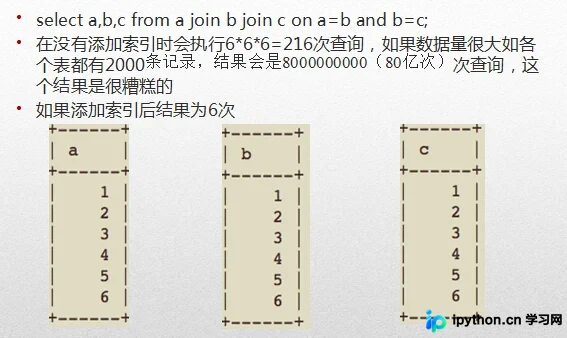
本文详解MySQL高效查询语句的设计方法。涵盖合理建立索引(连接键、排序字段)、避免低效的 LIKE 模糊匹配与非开头子串查询、使用 UNION 替代 OR 以利用索引、消除相关子查询、以及通过临时表和排序替代顺序存取等策略,旨在显著降低I/O开销并提升数据库响应速度。
本文介绍如何通过SQL Server的动态管理视图(DMV)实时监控数据库引擎的内存消耗。重点解析sys.dm_os_memory_clerks视图中保留、提交及Buffer Pool等关键指标的含义,并提供查询实例以协助DBA进行性能诊断和容量规划。
深入解析MySQL中常见的六种分页实现方式,涵盖基础LIMIT OFFSET、基于主键的范围查询、排序索引优化及预处理语句等。针对数据量大时出现的性能瓶颈与结果不稳定问题,提供具体的SQL语句示例与适用场景分析,帮助开发者根据业务需求选择最优的分页策略,提升查询效率。
本文通过具体案例解析MySQL优化器在查询执行计划中的决策逻辑。详细阐述Range Analysis阶段如何评估记录数,以及优化器如何通过穷举Left-Deep Tree来寻找最优JOIN顺序和访问方式。对比正常数据分布与极端倾斜情况下的执行差异,揭示基于统计信息预估可能导致的Bad Case,帮助DBA理解底层机制以优化SQL性能。
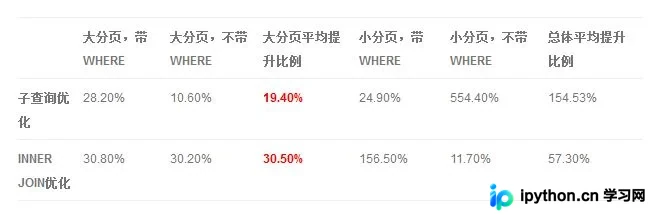
在MySQL中,随着LIMIT偏移量(offset)增大,传统分页查询速度急剧下降。本文详解如何通过覆盖索引结合子查询或INNER JOIN的方式,仅获取主键ID后再回表,从而大幅降低扫描记录数,提升深分页查询性能。