

SQL Server批量插入数据:Bulk与TVP性能对比及实现

在SQL Server中进行海量数据导入时,频繁使用单条 INSERT 语句会导致严重的性能瓶颈和网络开销。本文将深入解析两种高效的批量插入技术:Bulk(利用 SqlBulkCopy)与 TVP(表值参数),并通过C#代码展示其具体实现与性能表现。
准备条件:数据库环境搭建
为了进行准确的性能对比,首先需要创建一个测试数据库和对应的目标数据表。该表包含主键 Id、用户名 UserName 和密码 Pwd 三个字段。
-- 创建测试数据库
create database BulkTestDB;
go
use BulkTestDB;
go
-- 创建目标表
Create table BulkTestTable(
Id int primary key,
UserName nvarchar(32),
Pwd varchar(16));
go
第一种方式:传统的单条 INSERT 插入
这是最基础的插入方式,即在一个循环中逐条执行 SQL 命令。虽然逻辑简单,但在高数据量下,每次网络往返和执行计划缓存都会产生巨大开销,导致随着时间推移,总耗时显著增加。
// C# 模拟单条插入逻辑
static void simpleInsert()
{
    Console.WriteLine("开始单条插入测试...");
    Stopwatch sw = new Stopwatch();
    // 实际项目中请确保连接字符串安全
    string connString = "server=.;database=BulkTestDB;user=sa;password=123456;";

    using (SqlConnection sqlconn = new SqlConnection(connString))
    {
        SqlCommand sqlcmd = new SqlCommand();
        sqlcmd.CommandText = "insert into BulkTestTable(Id,UserName,Pwd)values(@p0,@p1,@p2)";
        sqlcmd.Parameters.Add("@p0", SqlDbType.Int);
        sqlcmd.Parameters.Add("@p1", SqlDbType.NVarChar);
        sqlcmd.Parameters.Add("@p2", SqlDbType.NVarChar);
        sqlcmd.CommandType = CommandType.Text;
        sqlcmd.Connection = sqlconn;
        sqlconn.Open();

        try
        {
            // 模拟插入多批次数据
            for (int multiply = 0; multiply < 10; multiply++)
            {
                for (int count = multiply * 100; count < (multiply + 1) * 100; count++)
                {
                    sqlcmd.Parameters["@p0"].Value = count;
                    sqlcmd.Parameters["@p1"].Value = $"User-{count * multiply}";
                    sqlcmd.Parameters["@p2"].Value = $"Pwd-{count * multiply}";

                    sw.Start();
                    sqlcmd.ExecuteNonQuery();
                    sw.Stop();
                }
                Console.WriteLine($"第 {multiply+1} 批次耗时: {sw.ElapsedMilliseconds} 毫秒");
            }
        }
        catch (Exception ex)
        {
            Console.WriteLine(ex.Message);
        }
    }
}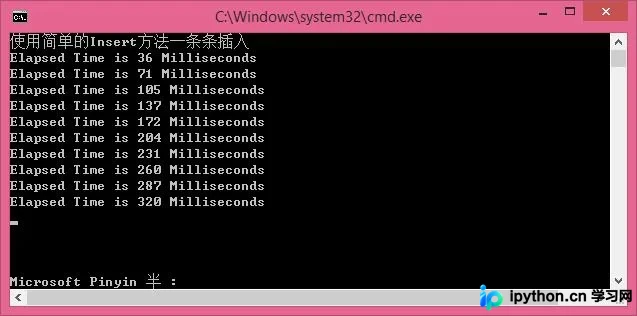
结果观察: 如上图所示,随着插入次数的累积,传统方式的累计耗时呈线性甚至超线性增长,无法满足大批量数据的高效写入需求。
第二种方式:使用 Bulk (SqlBulkCopy)
SqlBulkCopy 是 .NET Framework 提供的专用类,旨在以只进只读的方式向 SQL Server 表格提供大量数据的写入。它利用了 SQL Server 的大容量插入特性,极大地减少了日志记录和锁竞争,速度远超普通 INSERT。
操作步骤与代码实现
主要逻辑是将数据加载到 DataTable 或读取自 IDataReader,然后通过 WriteToServer 方法一次性提交。
// 构建测试用的 DataTable 结构
static DataTable GetTableSchema()
{
    DataTable dt = new DataTable();
    dt.Columns.AddRange(new DataColumn[] {
        new DataColumn("Id", typeof(int)),
        new DataColumn("UserName", typeof(string)),
        new DataColumn("Pwd", typeof(string))
    });
    return dt;
}

// Bulk 插入核心方法
static void BulkToDB(DataTable dt)
{
    string connString = "server=.;database=BulkTestDB;user=sa;password=123456;";

    using (SqlConnection sqlconn = new SqlConnection(connString))
    using (SqlBulkCopy bulkCopy = new SqlBulkCopy(sqlconn))
    {
        bulkCopy.DestinationTableName = "BulkTestTable";
        // BatchSize 设为数据行数,表示一次性全部提交,也可根据内存情况调整
        bulkCopy.BatchSize = dt.Rows.Count;

        sqlconn.Open();
        if (dt != null && dt.Rows.Count > 0)
        {
            bulkCopy.WriteToServer(dt);
        }
    }
}

// 测试入口
static void BulkInsert()
{
    Console.WriteLine("开始 Bulk 插入测试...");
    for (int multiply = 0; multiply < 10; multiply++)
    {
        DataTable dt = GetTableSchema();
        // 填充数据行
        for (int count = multiply * 100; count < (multiply + 1) * 100; count++)
        {
            DataRow r = dt.NewRow();
            r[0] = count;
            r[1] = $"User-{count * multiply}";
            r[2] = $"Pwd-{count * multiply}";
            dt.Rows.Add(r);
        }

        Stopwatch sw = Stopwatch.StartNew();
        BulkToDB(dt);
        sw.Stop();
        Console.WriteLine($"Bulk 第 {multiply+1} 批次耗时: {sw.ElapsedMilliseconds} 毫秒");
    }
}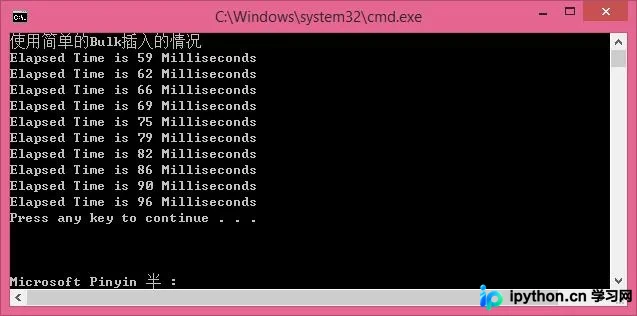
结果观察: Bulk 方式展现了极高的稳定性与吞吐量,单次插入耗时远低于传统方式,且随着批次增加,耗时保持平稳。
第三种方式:表值参数 (TVPs)
表值参数 (Table-Valued Parameters) 允许存储过程或批处理接收多个数据行作为参数。这种方式结合了 INSERT 的灵活性与 Bulk 的高性能,且不需要像 Bulk 那样严格依赖 DataTable 对象,更适合在复杂业务逻辑中集成。
第1步:在 SQL Server 中创建用户定义表类型
在执行 C# 代码前,必须在数据库中预定义一个与 DataTable 结构匹配的表类型。
-- 在 BulkTestDB 数据库中执行
CREATE TYPE BulkUdt AS TABLE
  (Id int,
   UserName nvarchar(32),
   Pwd varchar(16))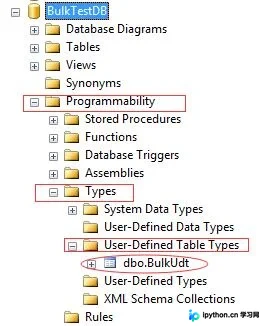
执行成功后,可在数据库对象的“用户定义表类型”节点中找到 BulkUdt。
第2步:C# 代码调用 TVP
通过设置 SqlParameter 的 SqlDbType 为 Structured 并指定 TypeName,将 DataTable 传递到 SQL 语句中。
static void TbaleValuedToDB(DataTable dt)
{
    string connString = "server=.;database=BulkTestDB;user=sa;password=123456;";
    const string TSqlStatement =
          "insert into BulkTestTable (Id,UserName,Pwd) SELECT nc.Id, nc.UserName, nc.Pwd FROM @NewBulkTestTvp AS nc";

    using (SqlConnection sqlconn = new SqlConnection(connString))
    using (SqlCommand cmd = new SqlCommand(TSqlStatement, sqlconn))
    {
        SqlParameter catParam = cmd.Parameters.AddWithValue("@NewBulkTestTvp", dt);
        catParam.SqlDbType = SqlDbType.Structured;
        catParam.TypeName = "dbo.BulkUdt"; // 必须与数据库定义的名称一致

        sqlconn.Open();
        if (dt != null && dt.Rows.Count > 0)
        {
            cmd.ExecuteNonQuery();
        }
    }
}

static void TVPsInsert()
{
    Console.WriteLine("开始 TVP 插入测试...");
    for (int multiply = 0; multiply < 10; multiply++)
    {
        DataTable dt = GetTableSchema();
        for (int count = multiply * 100; count < (multiply + 1) * 100; count++)
        {
            DataRow r = dt.NewRow();
            r[0] = count;
            r[1] = $"User-{count * multiply}";
            r[2] = $"Pwd-{count * multiply}";
            dt.Rows.Add(r);
        }

        Stopwatch sw = Stopwatch.StartNew();
        TbaleValuedToDB(dt);
        sw.Stop();
        Console.WriteLine($"TVP 第 {multiply+1} 批次耗时: {sw.ElapsedMilliseconds} 毫秒");
    }
}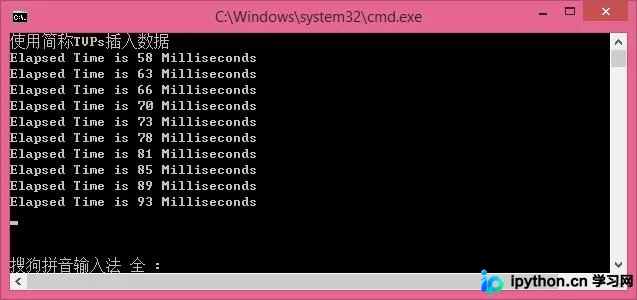
结果分析: TVP 的表现非常接近 Bulk,甚至在某些连接复用场景下更优。对于需要频繁小批量提交或数据源非标准 DataTable 的情况,TVP 提供了更好的代码可读性和维护性。
总结与排错建议
- 性能排序: Bulk ≈ TVP >> 传统 INSERT。
- 适用场景:
- Bulk: 追求极致吞吐量的纯数据迁移,数据源通常为 CSV、Excel 或直接映射为
DataTable/IDataReader。 - TVP: 需要将多条记录作为参数传递给存储过程,或在 LINQ 等 ORM 层以下做轻量级批量写入。
- Bulk: 追求极致吞吐量的纯数据迁移,数据源通常为 CSV、Excel 或直接映射为
- 常见错误: 使用 TVP 时,如果报错 “Invalid type specified”,通常是因为 C# 中定义的列顺序、数据类型或长度与 SQL Server 中定义的
UserDefinedTableType不一致,请仔细核对。
以上就是SQL Server批量插入数据案例详解的详细内容,更多关于SQL Server批量插入优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









