

MySQL快速生成百万级测试数据:内存表+存储过程实战

在开发和测试场景中,构建海量数据往往面临性能瓶颈。本文演示如何利用 MySQL 的 Memory 引擎(内存表)配合存储过程,高效批量生成百万级测试记录,并针对插入过程中可能出现的内存不足报错提供解决方案。同时,基于生成的数据表,解析深度分页的性能问题及通过覆盖索引优化的具体方法。
一、大规模数据插入策略
直接使用 INSERT 语句逐条或分批插入普通 InnoDB 表,由于频繁的事务日志写入和磁盘 I/O,效率极低。相比之下,MySQL 的 Memory(Memory engine)存储引擎将数据完全保留在内存中,读写速度极快且无需磁盘落盘开销。因此,最高效的策略是先在内存表中填充海量数据,随后一次性将其迁移至持久化的普通表中。
第1步:创建内存表
首先定义一个使用 Memory 引擎的临时表,其结构需与最终的目标表保持一致。假设目标表名为 vote_record_memory,示例代码如下:
DROP TABLE IF EXISTS vote_record_memory;
CREATE TABLE vote_record_memory (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id INT,
    vote_id INT,
    group_id INT
) ENGINE=MEMORY DEFAULT CHARSET=utf8;
第2步:创建对应的普通表
接着创建用于实际存储数据的永久表 vote_record。必须确保字段类型、长度和索引结构与内存表完全对应,否则在执行 INSERT INTO ... SELECT * 跨引擎迁移时会发生报错。
DROP TABLE IF EXISTS vote_record;
CREATE TABLE vote_record (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id INT,
    vote_id INT,
    group_id INT
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
第3步:定义产生伪随机数的函数
为了让测试数据看起来更真实(避免所有记录的 ID 都是固定序列),需要编写一个存储函数来生成随机整数,例如随机分配 user_id。
DELIMITER //
DROP FUNCTION IF EXISTS rand_num;//
CREATE FUNCTION rand_num(n INT)
RETURNS INT DETERMINISTIC
BEGIN
    DECLARE i INT DEFAULT 0;
    SET i = FLOOR(RAND() * n);
    RETURN i;
END;//
DELIMITER ;
第4步:编写批量插入的存储过程
创建一个存储过程,接收需要插入的行数作为参数,利用循环调用上述函数向内存表中插入数据。
DELIMITER //
DROP PROCEDURE IF EXISTS add_vote_memory;//
CREATE PROCEDURE add_vote_memory(IN n INT)
BEGIN
    DECLARE i INT DEFAULT 1;
    WHILE i <= n DO
        INSERT INTO vote_record_memory (user_id, vote_id, group_id)
        VALUES (rand_num(100), rand_num(100), rand_num(50));
        SET i = i + 1;
    END WHILE;
END;//
DELIMITER ;
第5步:调用存储过程执行插入
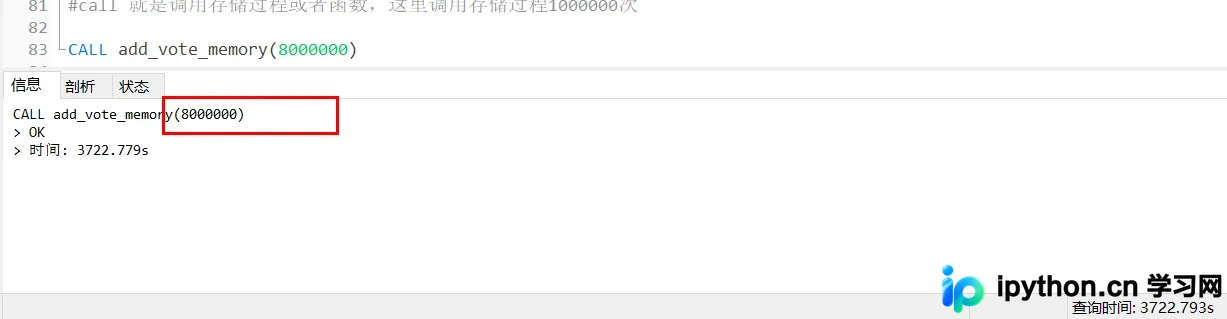
调用刚创建的存储过程,参数指定插入的数量。例如插入 100万 条数据:
CALL add_vote_memory(1000000);第6步:将数据导入普通表
数据在内存表中填充完毕后,执行标准的 INSERT SELECT 语句将全量数据同步到 vote_record 表中:
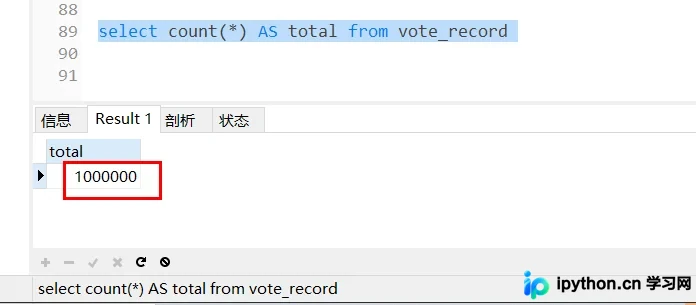
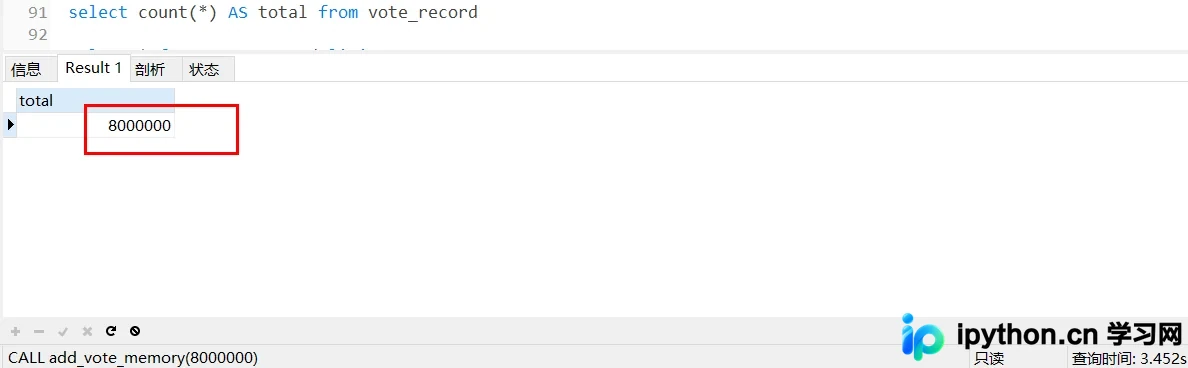
INSERT INTO vote_record SELECT * FROM vote_record_memory;此时可验证普通表中的数据数量是否符合预期:SELECT COUNT(*) AS total FROM vote_record;
二、内存受限时的参数调整
Memory 表受限于 tmp_table_size 和 max_heap_table_size 两个系统变量。如果尝试插入的数据量导致表体积超过默认限制(通常为 16MB 左右),执行存储过程时会抛出如下错误:
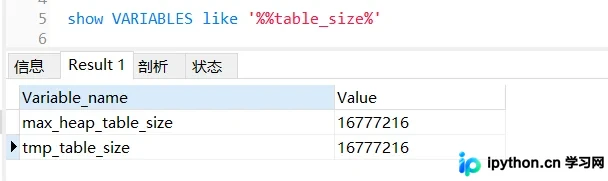
遇到该问题时,可在会话级别临时增大这两个参数的值。例如将上限调整为 1GB,然后重新执行第5步和第6步的操作:
SET SESSION tmp_table_size = 1024 * 1024 * 1024;
SET SESSION max_heap_table_size = 1024 * 1024 * 1024;
调整后再次调用 CALL add_vote_memory(N) 即可完成大批量数据的内存驻留。
三、基于大表的深度分页优化
随着测试数据量的激增(如本文模拟的 800万+ 行数据),传统 SQL 分页方式的性能缺陷会暴露无遗。
1. 传统的 Limit 痛点
常规的 MySQL 分页写法如下:
SELECT id, user_id, vote_id, group_id FROM vote_record LIMIT 7999900, 10;Mysql 的执行机制并非直接跳过 7999900 行,而是从结果集第一行开始扫描,直到找到第 7999900+10=8000000 条记录,然后将前 7999900 条舍弃,返回最后 10 条。当偏移量(Offset)极大时,大量的无效扫描会导致严重的性能损耗,查询耗时可能高达数秒甚至更长。
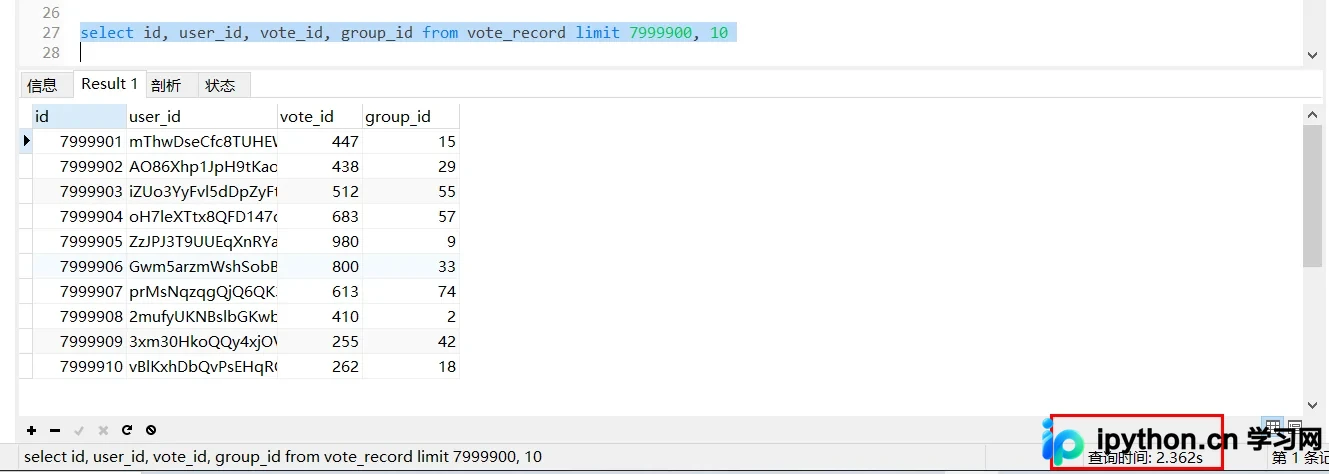
2. 基于主键索引的优化方案
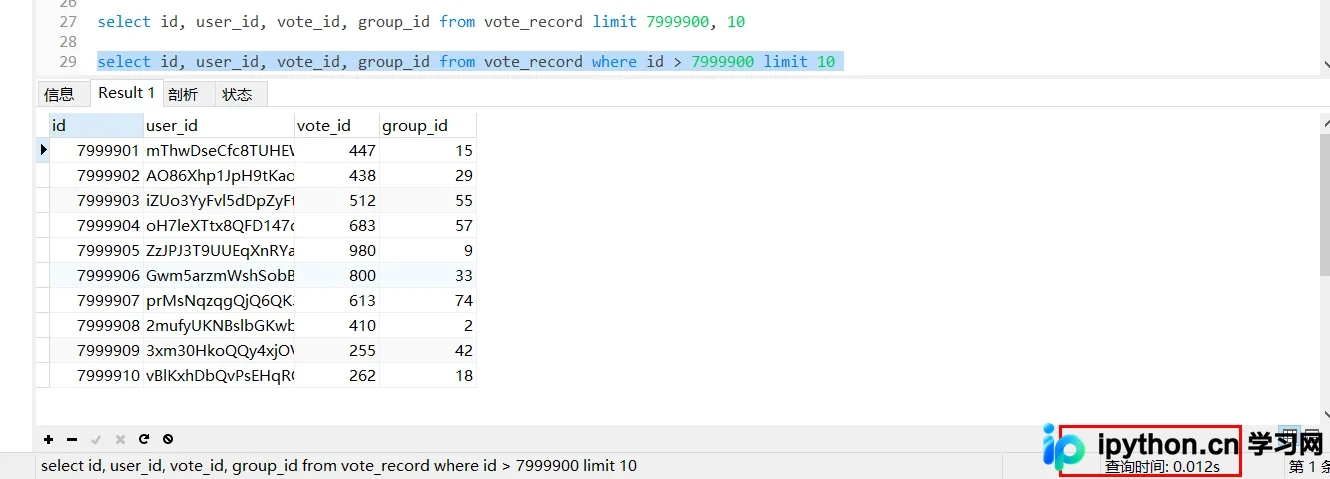
由于 id 字段通常为主键且具备唯一索引,可以利用范围查询替代偏移量查询。要求业务层记录下上一次查询到的最大主键值(last_id),下一次请求时从该 ID 之后开始检索:
SELECT id, user_id, vote_id, group_id
FROM vote_record
WHERE id > 7999900
LIMIT 10;这种写法利用了覆盖索引(Covering Index)的优势。MySQL 直接在 B+树索引中进行查找,无需回表查询整行数据,定位到起始位置后即可迅速截取所需数据。在同等数据规模下,优化后的查询速度可从秒级降至毫秒级。
四、总结
利用 Memory 表中转配合存储过程生成测试数据,是目前处理千万级以下数据量的高效手段,但需注意控制单会话下的内存上限。而在面对包含数百万数据的生产环境分页需求时,应当尽量避免使用深层 OFFSET,转而采用“基于上一页最后一条数据的 ID 进行游标分页”的方式,以换取指数级的性能提升。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









