SQL查询与删除重复记录:MySQL、Oracle等数据库实用方案
本文详细讲解如何在MySQL和Oracle中查询及删除数据库中的重复记录。针对单字段和多字段重复场景,提供了基于GROUP BY、ROWID临时表及子查询的高效SQL写法。重点对比了不同方法的优劣及适用环境,帮助用户快速清理冗余数据并预防重复发生。
2026-10-13
8

本文详细讲解如何在MySQL和Oracle中查询及删除数据库中的重复记录。针对单字段和多字段重复场景,提供了基于GROUP BY、ROWID临时表及子查询的高效SQL写法。重点对比了不同方法的优劣及适用环境,帮助用户快速清理冗余数据并预防重复发生。
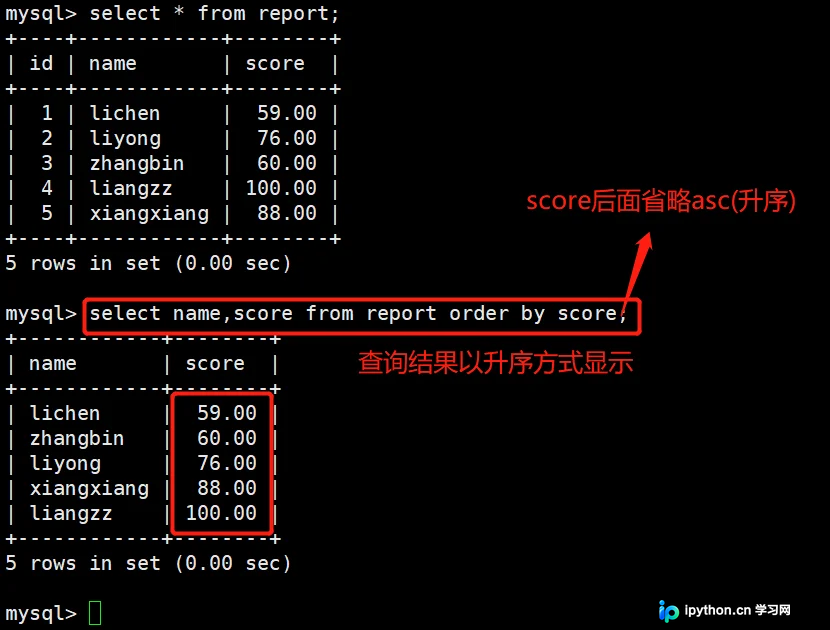
本文详细介绍MySQL中ORDER BY语句的使用,涵盖单列默认升序排序、多列组合排序、ASC/DESC升降序指定以及结合LIMIT获取极值的方法。通过实例演示如何避免中文乱序陷阱并掌握正确的SQL语法顺序。
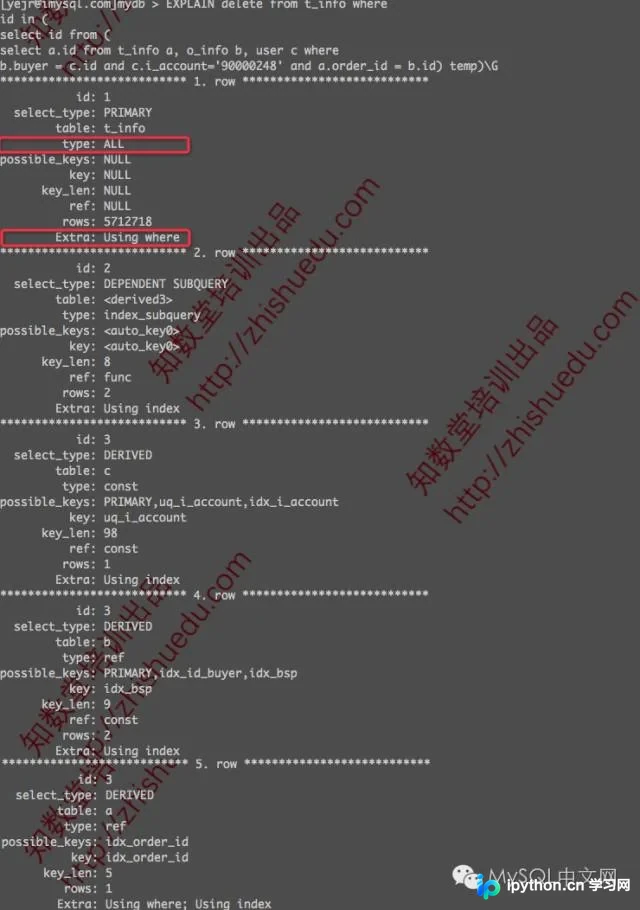
当MySQL的DELETE语句包含子查询导致执行极慢时,通常是因为查询优化器未能有效利用索引进行过滤。本文将通过具体案例对比分析,展示如何将低效的子查询改写为基于多表JOIN的DELETE语句。通过FROM子句关联临时结果集,可让优化器利用主键直接定位数据,避免全表扫描和回表,将耗时从30秒级降低至毫秒级。
本文详细演示了在 SQL Server 2005 中,如何将包含大量历史数据的现有表通过分区技术拆分到不同文件组。核心步骤包括创建多个文件组、定义基于数值边界的分区函数,最后修改聚集索引位置触发数据物理重分布。该方法可实现不锁定全表的情况下完成大规模数据归档与性能优化。
在MySQL中使用ORDER BY RAND()或WHERE中包含RAND()会导致全表或全索引扫描,性能极差。通过将随机数计算移至JOIN子查询中,利用MAX(id)生成随机偏移量并结合LIMIT,可将执行时间从秒级降低至毫秒级,同时保持查询结果的随机性。
在MySQL优化中,了解SQL执行频率有助于选择合适的存储引擎和定位性能瓶颈。通过show [session|global] status命令可查看Com_select、Com_insert等语句级执行次数,以及Innodb_rows_read等行级操作数据,结合Connections、Slow_queries等基础指标,全面掌握数据库负载情况。
本文深入分析MySQL InnoDB引擎中事务回滚的两个关键问题:一是自增ID(Auto_Increment)为何不回滚,因其计数器仅存于内存且重启时通过SELECT MAX重置;二是区分“物理执行”与“逻辑回滚”,指出Commit主要涉及Redo Log持久化,而Rollback基于Undo Log进行逻辑反操作,并非完全的数据删除或物理还原。
MySQL中较大的Offset值会导致全表扫描并丢弃大量数据,严重影响查询性能。本文介绍一种基于“覆盖索引”结合“延迟关联”的优化策略。通过在子查询中仅返回主键ID并使用覆盖索引快速定位,再与原表进行Inner Join获取完整数据,从而避免回表操作带来的巨大开销,显著提升深分页查询效率。
针对模糊查询性能问题,分析MySQL三种全文检索方案。无索引慢但零开销;B树索引无法匹配尾部通配符;默认FULLTEXT仅匹配完整词;n-gram支持子串搜索但存储成本高且受全局配置限制。本文通过100万数据测试对比各方案在读写性能、空间占用及维护上的优劣。
本文系统梳理MySQL数据库的核心操作:涵盖日期、字符串、数字及聚合函数的语法与应用;解析Union合并数据的原理与实践;详解虚拟表视图的创建逻辑与优缺点;介绍各类索引(主键、唯一、普通)的作用及增删改维护语句,并总结常见报错代码如1064和1075的快速排查方法。
本文详细介绍MySQL数据库中常用的高级SQL查询语句,包括如何使用ORDER BY进行单字段或多字段排序,利用AND/OR实现复杂条件过滤,通过DISTINCT去除重复记录,结合聚合函数使用GROUP BY进行数据分组统计,以及运用LIMIT限制返回结果数量。同时涵盖别名设置与LIKE通配符模糊匹配等实用技巧,帮助开发者高效处理数据集。
本文详细解析MySQL索引失效的九种常见场景,涵盖违反最佳左前缀法则、主键插入乱序、范围查询右侧列失效、函数计算导致失效、like左模糊匹配、is not null过滤以及字符集不统一等问题。通过SQL示例和执行计划对比,帮助开发者规避性能陷阱,确保查询高效利用B+树索引。