

MySQL DQL数据查询语言全解:从基础到高阶操作
本文详细解析MySQL数据查询语言(DQL),涵盖基本查询、别名与去重、运算符比较、排序、聚合函数(COUNT/SUM/AVG)、分组及Having筛选、分页Limit,以及正则表达式匹配。通过商品表与学生表的实例,深入讲解SQL执行顺序、WHERE与HAVING的区别及复杂逻辑处理,提供可复用的代码模板与分析思路。
2026-10-16
7

本文详细解析MySQL数据查询语言(DQL),涵盖基本查询、别名与去重、运算符比较、排序、聚合函数(COUNT/SUM/AVG)、分组及Having筛选、分页Limit,以及正则表达式匹配。通过商品表与学生表的实例,深入讲解SQL执行顺序、WHERE与HAVING的区别及复杂逻辑处理,提供可复用的代码模板与分析思路。
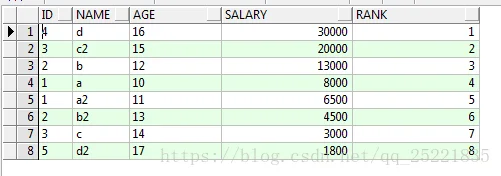
本文整理了 SQL Server 中高频使用的统计查询场景,涵盖单人总分计算与排名、单科最高分提取、平均成绩统计、课程分数段分布计数、行转列(透视表)处理以及复杂排名截取等需求。通过标准 SQL 语法提供可直接运行的示例,帮助开发者和数据库管理员快速解决常见的数据聚合与分析难题。
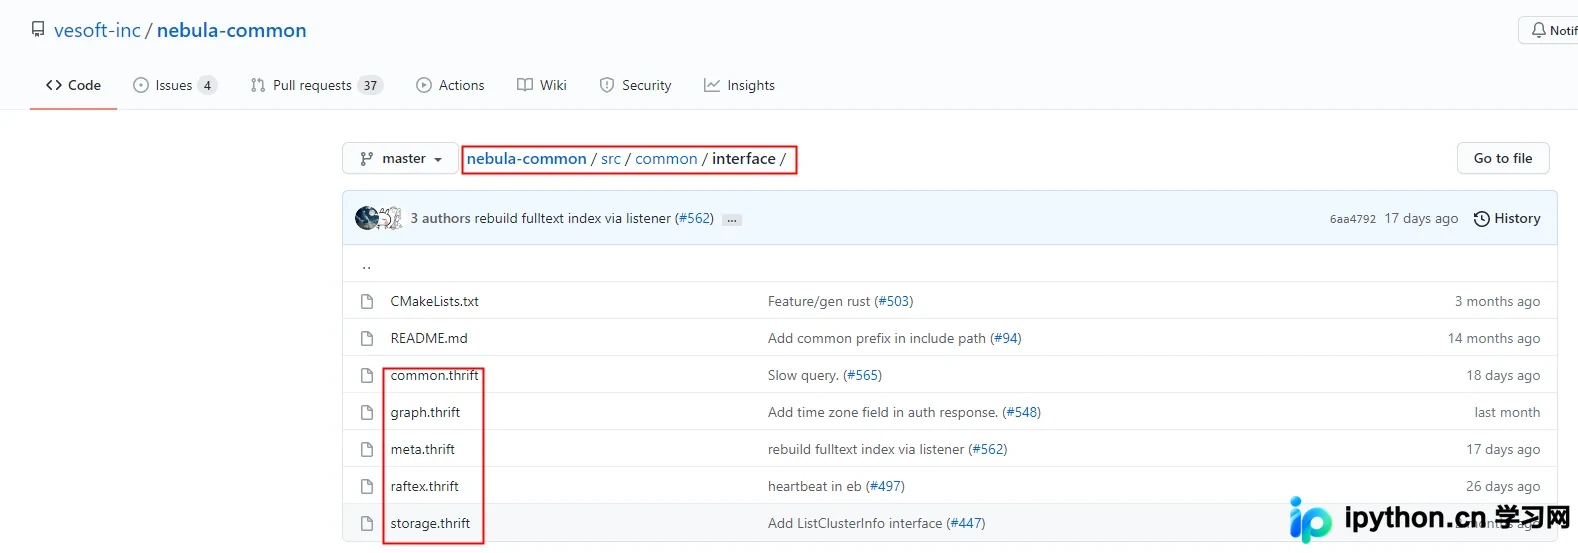
由于Nebula Graph官方未提供C#客户端,可通过源码中的Thrift模板自行生成。核心步骤包括准备Linux环境、安装特定版本的GCC与CMake、使用Fbthrift编译器对nebula-common进行编译,从而提取生成的C#接口定义文件。本文详述从零开始的环境搭建与编译流程。
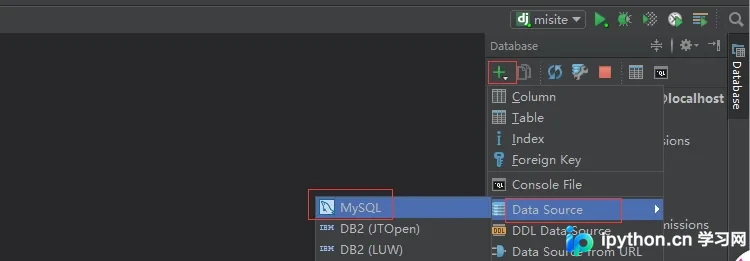
本文深入解析Django ORM机制,阐述对象关系映射原理及其优劣。详细演示如何在Django项目中配置MySQL连接,并通过Person模型实例,完整展示使用ORM进行数据表的创建、记录增加、删除、修改及查询的具体代码与操作步骤,帮助开发者高效掌握Django数据库交互核心技能。
本文介绍了在SQL Server和Oracle数据库中,如何编写SQL语句来实现数据的日报和月报功能。通过具体的代码示例,展示了如何利用日期转换和过滤条件来统计特定时间段内的数据汇总,适用于需要生成日常或月度报表的场景。
本文详细解析MySQL数据库中内连接(Inner Join)、左外连接(Left Join)和右外连接(Right Join)的核心区别。通过具体的表数据示例,展示各连接类型在匹配记录、保留未匹配行及处理NULL值时的实际表现与SQL写法,帮助开发者根据业务需求选择正确的多表查询策略。
本文将详解如何在 MySQL 中通过自定义函数实现树形结构的父子节点查询。提供测试用例与完整 SQL 脚本,演示如何通过 `GET_CHILD_NODE` 获取某节点下所有子节点,以及如何构建逻辑查询其所有父级节点路径。代码包含创建测试表和核心函数定义,可直接复制使用。
本文详细解析MySQL中ROW_NUMBER()与OVER()函数的语法及执行顺序。通过多个实战案例,演示如何利用该函数进行无分组排序、按ID分组排序、筛选特定序号数据以及复杂订单统计。重点强调OVER()内的分组与排序逻辑在WHERE、GROUP BY之后执行,并提供处理最小金额订单及首次下单记录的完整SQL解决方案。
本文介绍在 Python 3.7 中使用 pymssql 库向 SQL Server 插入数据时,必须同时配置连接参数的 autocommit=True 并在 SQL 语句末尾显式添加 COMMIT。缺少任一配置均可能导致插入操作无法成功提交。文章提供了完整的代码示例及常见失败问题的排查建议。
本文详解Python中如何使用MongoEngine对MongoDB进行ORM操作。内容涵盖安装配置、Model类定义、字段属性设置,以及保存、查询(含Q对象复杂查询)、修改等核心操作。通过对比PyMongo,说明MongoEngine在解耦代码、提升可维护性方面的优势,适合需要结构化操作文档数据库的开发者参考。
MySQL的RAND()函数仅返回0到1之间的浮点数,无法直接像其他语言那样传入参数限制范围。通过公式 ROUND(RAND() * (最大数 - 最小数) + 最小数),可将结果映射到任意区间。本文详细推导该公式来源,并说明如何获取指定范围内的随机整数及整数转换方法。
本文详细解析 MySQL 中常用的四类函数:字符串处理(连接、比较、截取)、数值计算(四舍五入、随机数)、日期时间获取与运算以及系统信息查询。通过具体的 SQL 示例,帮助开发者快速掌握数据清洗与格式化技巧,提升数据库操作效率。