

MySQL中ROW_NUMBER()与OVER()函数的实战用法解析

本文详细解析MySQL中ROW_NUMBER()与OVER()函数的语法及执行顺序。通过多个实战案例,演示如何利用该函数进行无分组排序、按ID分组排序、筛选特定序号数据以及复杂订单统计。重点强调OVER()内的分组与排序逻辑在WHERE、GROUP BY之后执行,并提供处理最小金额订单及首次下单记录的完整SQL解决方案。
语法格式为:row_number() over(partition by 分组列 order by 排序列 desc)。
ROW_NUMBER() OVER() 函数的核心功能是实现分组排序。
在使用 ROW_NUMBER() OVER() 函数时,需注意其执行顺序:OVER() 子句内部的分组(PARTITION BY)和排序(ORDER BY)操作,是在 WHERE、GROUP BY 以及最终的 ORDER BY 之后才执行的。
以下通过具体示例进行说明。
测试表数据结构如下:
create table TEST_ROW_NUMBER_OVER(
       id varchar(10) not null,
       name varchar(10) null,
       age varchar(10) null,
       salary int null
);
select * from TEST_ROW_NUMBER_OVER t;

insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(1,'a',10,8000);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(1,'a2',11,6500);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(2,'b',12,13000);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(2,'b2',13,4500);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(3,'c',14,3000);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(3,'c2',15,20000);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(4,'d',16,30000);
insert into TEST_ROW_NUMBER_OVER(id,name,age,salary) values(5,'d2',17,1800);
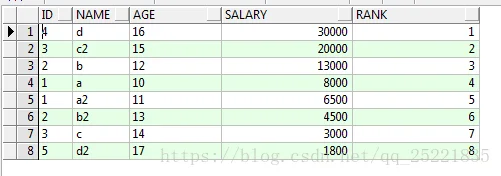
示例一:对查询结果进行整体排序(不分组)。
select id,name,age,salary,row_number()over(order by salary desc) rn
from TEST_ROW_NUMBER_OVER t
执行结果如下:
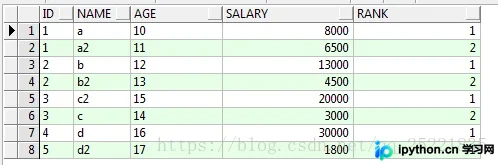
进阶排序:根据 ID 字段进行分组,并在组内按薪资排序。
select id,name,age,salary,row_number()over(partition by id order by salary desc) rank
from TEST_ROW_NUMBER_OVER t
执行结果如下:
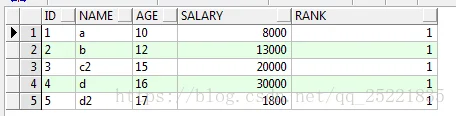
进一步操作:筛选出每一组中序号为 1 的数据记录。
select * from(select id,name,age,salary,row_number()over(partition by id order by salary desc) rank
from TEST_ROW_NUMBER_OVER t)
where rank <2
执行结果如下:
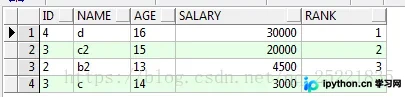
场景二:筛选年龄在 13 岁到 16 岁之间的数据,并按薪资降序排列。
select id,name,age,salary,row_number()over(order by salary desc)  rank
from TEST_ROW_NUMBER_OVER t where age between '13' and '16'
执行结果如下:从结果中 rank 序号的分布可以看出,OVER(order by salary desc) 的逻辑确实是在 WHERE age between '13' and '16' 条件过滤之后执行的。
示例二:涉及订单统计的复杂应用场景。
1. 使用 ROW_NUMBER() 函数为数据添加行号,例如:
select email,customerID, ROW_NUMBER() over(order by psd) as rows from QT_Customer
原理说明:系统先按 psd 字段进行排序,排序完成后,再为每条数据分配唯一的序号。
2. 在订单表中,按价格升序排列并为每条记录编号,代码如下:
select DID,customerID,totalPrice,ROW_NUMBER() over(order by totalPrice) as rows from OP_Order
3. 统计每个客户的所有订单,按订单金额升序排列,同时为每个客户的订单进行编号,从而明确每个客户的下单总数:
select ROW_NUMBER() over(partition by customerID  order by totalPrice)
 as rows,customerID,totalPrice, DID from OP_Order
4. 统计每个客户最近一次下单是第几次订单:
with tabs as
(
select ROW_NUMBER() over(partition by customerID  order by totalPrice)
 as rows,customerID,totalPrice, DID from OP_Order
 )
select MAX(rows) as '下单次数',customerID from tabs
group by customerID
5. 统计每个客户所有订单中购买金额最小的订单,并统计该订单是客户第几次购买的:
解决思路:利用临时表(CTE)来执行这一操作。
步骤 1:先按客户进行分组,然后按客户的下单时间进行排序,并进行编号。
步骤 2:利用子查询查找出每一个客户购买时的最小价格。
步骤 3:根据查找出的每一个客户的最小价格,反向查找相应的完整记录。
    with tabs as
     (
    select ROW_NUMBER() over(partition by customerID  order by insDT)
as rows,customerID,totalPrice, DID from OP_Order
    )
     select * from tabs
    where totalPrice in
    (
    select MIN(totalPrice)from tabs group by customerID
     )
6. 筛选出客户第一次下的订单。
解决思路:利用 rows = 1 的条件来查询客户第一次下的订单记录。
    with tabs as
    (
    select ROW_NUMBER() over(partition by customerID  order by insDT) as rows,* from OP_Order
    )
    select * from tabs where rows = 1
    select * from OP_Order
注意:在使用 OVER 等开窗函数时,OVER 内部的分组及排序的执行时机晚于 WHERE、GROUP BY 和 ORDER BY 的执行。
    select
    ROW_NUMBER() over(partition by customerID  order by insDT) as rows,
    customerID,totalPrice, DID
    from OP_Order where insDT>'2011-07-22'
到此这篇关于 MySQL ROW_NUMBER() 与 OVER() 函数用法详解的文章就介绍到这了,更多相关 MySQL ROW_NUMBER() 与 OVER() 内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









