

MySQL 查询树形结构数据实战:自关联表递归查询

在关系型数据库中处理组织架构、分类菜单等层级数据时,通常采用 `id` 与 `parent_id` 的自关联模式。由于 MySQL 原生不支持类似 Oracle 的 `START WITH ... CONNECT BY` 语法,查询树形结构往往较为繁琐。本文详细介绍在 MySQL 中利用 `FIND_IN_SET` 配合自定义函数的方法,快速获取目标节点下的所有后代及祖先路径。
什么是树结构与自关联表
树结构的数据在业务场景中十分常见,如公司的部门架构、电商的商品分类或文件的目录系统。这类结构的数据通常需要表结构中包含 `id`(当前节点唯一标识)和 `parentId`(父节点的标识)等自关联字段。为了优化性能,有时会引入冗余字段记录整条路径,但在大多数标准设计中,依靠这两个字段即可支撑数据的递归查询与组装。
对于此类树状数据的呈现与处理,常规做法是在后端代码(如 Java 或 Python)中将扁平的数据列表查出后,通过程序逻辑进行递归拼装。但如果需要在 SQL 层直接进行层级过滤或统计,单纯使用 SQL 也是可行的,下面我们将以 MySQL 为例进行说明。
第1步:建立树结构测试数据环境
目的: 准备一组具有明显层级关系的模拟数据,以便后续验证查询函数的准确性。
操作: 创建一个简单的 `tree` 表用于存储节点信息。
CREATE TABLE `tree`  (
  `id` bigint(20) NOT NULL,
  `pid` bigint(20) NULL DEFAULT NULL,
  `name` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NULL DEFAULT NULL,
  PRIMARY KEY (`id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8mb4 COLLATE = utf8mb4_general_ci ROW_FORMAT = Dynamic;

-- 插入一条典型的行政区域树状数据:中国 -> 四川省 -> 成都市 ...
INSERT INTO `tree` VALUES (1, 0, '中国');
INSERT INTO `tree` VALUES (2, 1, '四川省');
INSERT INTO `tree` VALUES (3, 2, '成都市');
INSERT INTO `tree` VALUES (4, 3, '武侯区');
INSERT INTO `tree` VALUES (5, 4, '红牌楼街道');
INSERT INTO `tree` VALUES (6, 1, '广东省');
INSERT INTO `tree` VALUES (7, 1, '浙江省');
INSERT INTO `tree` VALUES (8, 6, '广州市');
第2步:自定义函数查找指定节点下的所有子节点
入口: 数据库客户端或 SQL 编辑器的函数管理页面。
动作: 创建名为 `GET_CHILD_NODE` 的函数。其核心逻辑是利用一个循环变量 `cid`,不断查找当前层级下所有的子 ID,并将其拼接至结果字符串 `str` 中。这里使用了 `group_concat(id)` 配合 `FIND_IN_SET(pid, cid)` 来筛选出父级在当前列表里的下一层子节点。
DELIMITER //
CREATE FUNCTION `GET_CHILD_NODE`(rootId varchar(100))
RETURNS varchar(2000)
BEGIN
    DECLARE str varchar(2000);
    DECLARE cid varchar(100);
    SET str = '$';
    SET cid = rootId;
    WHILE cid is not null DO
        SET str = concat(str, ',', cid);
        SELECT group_concat(id) INTO cid FROM tree where FIND_IN_SET(pid, cid) > 0;
    END WHILE;
    RETURN str;
END //
DELIMITER ;
完成状态: 执行以下查询语句,将返回根节点 ID 为 `2`(四川省)及其下所有的下级行政区划。
SELECT * FROM tree WHERE FIND_IN_SET(id, GET_CHILD_NODE(2));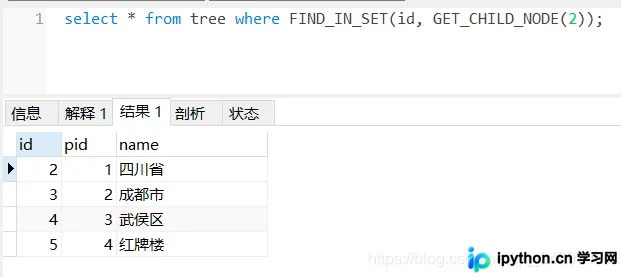
第3步:自定义函数查找指定节点的所有父节点
入口: 数据库客户端或 SQL 编辑器的函数管理页面。
动作: 创建名为 `GET_PARENT_NODE` 的函数。与子节点向下搜索不同,此逻辑是从当前的根节点开始,反复向上抓取 `pid`,直到 `pid` 为 `null` 为止。每次查到的父级 ID 都会追加到结果串 `str` 中。
DELIMITER //
CREATE FUNCTION `GET_PARENT_NODE`(rootId varchar(100))
RETURNS varchar(1000)
BEGIN
    DECLARE fid varchar(100) DEFAULT '';
    DECLARE str varchar(1000) DEFAULT rootId;

    WHILE rootId is not null do
        SET fid =(SELECT pid FROM tree WHERE id = rootId);
        IF fid is not null THEN
            SET str = concat(str, ',', fid);
            SET rootId = fid;
        ELSE
            SET rootId = NULL;
        END IF;
    END WHILE;
    return str;
END //
DELIMITER ;
完成状态: 查询节点 ID 为 `5` 的路径,将输出从底向上的各级父节点列表。
SELECT * FROM tree WHERE FIND_IN_SET(id, GET_PARENT_NODE(5));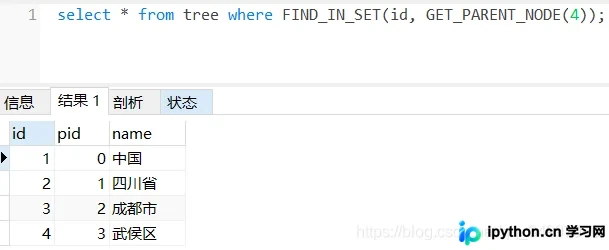
程序代码层面的替代方案
除了纯 SQL 实现外,在应用程序层面处理树形数据也是主流方案。这通常分为递归拼装和利用 Hash Map 一次遍历两种思路:
Java 递归构建树逻辑简述
先查询出扁平化的全量节点列表,随后调用某个类中的 `add` 方法。该方法判断传入节点的 `parentId` 是否匹配自身 `id`,如果不匹配则递归遍历自身的 `children` 集合去尝试添加子节点。这种方式直观且易于理解,但随着层级加深会有一定的内存开销。
public class TreeNodeDTO {
    private String id;
    private String parentId;
    private String name;
    private List<TreeNodeDTO> children = new ArrayList<>();
    public void add(TreeNodeDTO node) {
        if ("0".equals(node.parentId)) {
            this.children.add(node);
        } else if (node.parentId.equals(this.id)) {
            this.children.add(node);
        } else {
         	//递归调用add()继续寻找匹配的父节点
            for (TreeNodeDTO tmp_node : children) {
                tmp_node.add(node);
            }
        }
    }
}
基于 HashMap 的一次遍历法(高性能推荐)
利用哈希表的 O(1) 查找特性,只需对节点列表遍历一次即可完成树的生成。核心思路是先存入 Map,遍历时如果该节点的父节点已经存在于 Map 中,直接将子节点挂接到父节点的 `children` 列表中;若未存在,则先放入 Map 等待后续子节点的挂靠。这极大降低了时间复杂度。
List<TreeNodeDTO> list = dbMapper.getNodeList(); // 假设这是全量列表
ArrayList<TreeNodeDTO> rootNodes = new ArrayList<>();
Map<Integer, TreeNodeDTO> map = new HashMap<>();

for (TreeNodeDTO node : list) {
    map.put(node.getId(), node);
    Integer parentId = node.getParentId();
    // 判断是否有父节点 (没有父节点本身就是根节点)
    if (parentId.equals('0')){
        rootNodes.add(node);
    } else if (map.containsKey(parentId)){
        // 找到父节点,将当前节点加入父节点的子集合
        map.get(parentId).getChildren().add(node);
    }
}
以上就是 MySQL 中使用自定义函数查询树结构数据的详细内容,更多关于 MySQL 进阶优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









