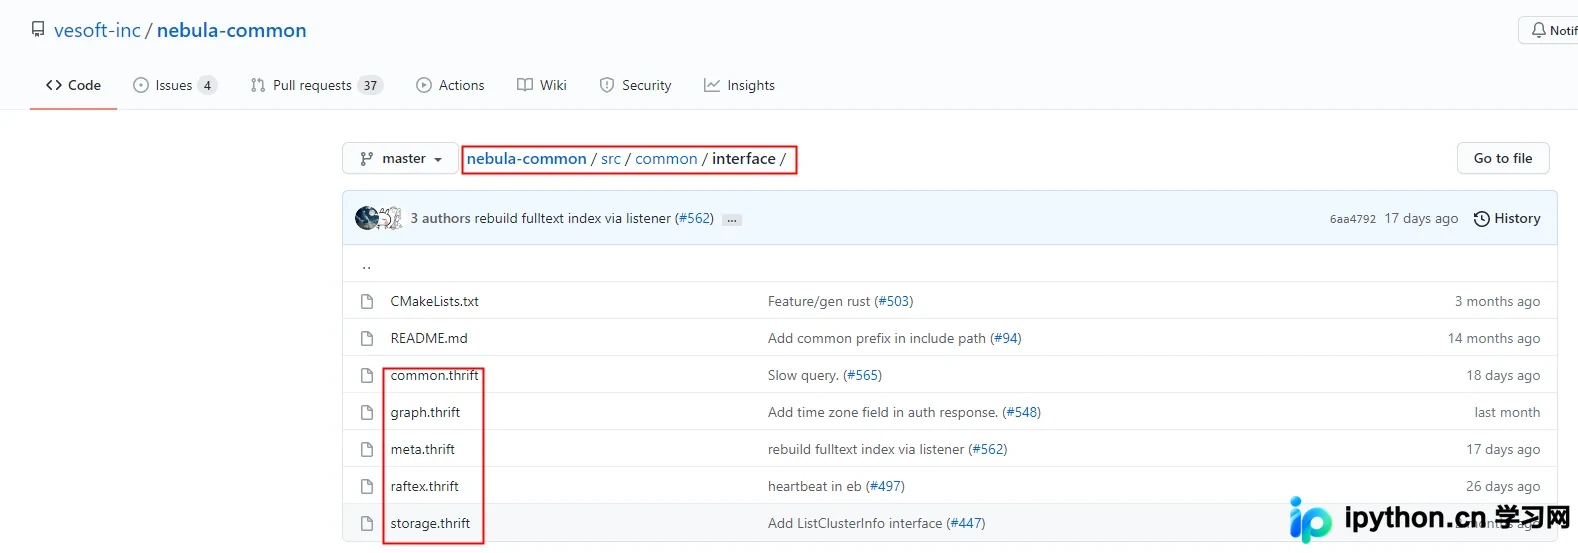
基于 Facebook Thrift 编译 Nebula Graph C# 客户端代码
由于Nebula Graph官方未提供C#客户端,可通过源码中的Thrift模板自行生成。核心步骤包括准备Linux环境、安装特定版本的GCC与CMake、使用Fbthrift编译器对nebula-common进行编译,从而提取生成的C#接口定义文件。本文详述从零开始的环境搭建与编译流程。
2026-10-16
7

由于Nebula Graph官方未提供C#客户端,可通过源码中的Thrift模板自行生成。核心步骤包括准备Linux环境、安装特定版本的GCC与CMake、使用Fbthrift编译器对nebula-common进行编译,从而提取生成的C#接口定义文件。本文详述从零开始的环境搭建与编译流程。
在PostgreSQL中存储URL时,若需提取协议、主机名或路径等信息,可使用内置的ts_debug函数。该函数通过文本搜索配置对URL进行词法分析,返回协议头、URL完整路径、主机名及具体路径等字段,无需编写复杂正则即可实现结构化解析。
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
本文详解SQL Server中处理日期的核心函数。重点解析传统CONVERT()与现代FORMAT()在日期格式控制上的差异,演示EOMonth获取月末、DATEFROMPARTS构建日期等常用操作,并提供时区切换、周几判断及按时间段查询数据的实用SQL代码示例。
本文将详解如何在 MySQL 中通过自定义函数实现树形结构的父子节点查询。提供测试用例与完整 SQL 脚本,演示如何通过 `GET_CHILD_NODE` 获取某节点下所有子节点,以及如何构建逻辑查询其所有父级节点路径。代码包含创建测试表和核心函数定义,可直接复制使用。
本文详细解析MySQL数据查询语言(DQL),涵盖基本查询、别名与去重、运算符比较、排序、聚合函数(COUNT/SUM/AVG)、分组及Having筛选、分页Limit,以及正则表达式匹配。通过商品表与学生表的实例,深入讲解SQL执行顺序、WHERE与HAVING的区别及复杂逻辑处理,提供可复用的代码模板与分析思路。
本文整理了 SQL Server 中高频使用的统计查询场景,涵盖单人总分计算与排名、单科最高分提取、平均成绩统计、课程分数段分布计数、行转列(透视表)处理以及复杂排名截取等需求。通过标准 SQL 语法提供可直接运行的示例,帮助开发者和数据库管理员快速解决常见的数据聚合与分析难题。
本文解析 SQL Server T-SQL 的基础构成对象,包括常量的类型表示规则、分隔符(双引号与方括号)的用法差异、标识符的命名规范及保留关键字的定义。掌握这些基础语法是编写正确且可读性强 T-SQL 代码的关键,帮助开发者避免引用冲突和语法错误。
本文深入解析MySQL数据库中自连接(Self Join)与子查询(IN/EXISTS)的核心概念与实战应用。通过PHP mysqli扩展演示如何编写SQL语句,处理具有层级结构的数据(如地区表)以及多表匹配过滤。文章提供了完整的连接代码、SQL模板及结果调试输出,帮助开发者掌握复杂数据检索技巧并理解底层逻辑。
本文详解 MySQL 中如何使用 WHERE 子句进行精准数据筛选。涵盖等于、大于等比较运算符,AND/OR 逻辑组合,IN/BETWEEN 范围匹配,以及区分 NULL 与空字符串的正确写法。结合 LIKE 通配符实现模糊搜索,并说明运算优先级规则,助您高效掌握 SQL 数据提取技巧。
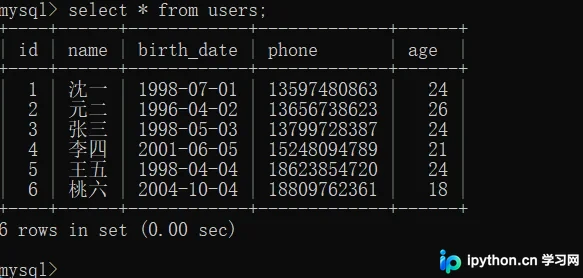
本文详细解析MySQL中REGEXP正则表达式的用法,重点阐述其与LIKE在匹配机制上的核心差异。通过整理空白元字符、字符类、断言等关键符号及SQL实例,帮助开发者掌握更灵活的条件过滤技巧,适用于模糊搜索、格式校验及数据清洗场景。
本文详细介绍如何使用 Python 库 PyMySQL 连接 MySQL 数据库,涵盖创建连接、游标设置及字典游标、执行 SQL(含防注入)、单条/批量获取结果 fetchone/fetchmany/fetchall、数据提交 commit 及自增 ID 获取等核心操作。文中附带权限管理练习案例,展示如何结合多表查询实现用户权限验证。