


批量更新是数据库里很常见的维护动作,但一旦把它写进存储过程并直接跑在线业务,最容易出问题的不是“能不能更新成功”,而是会不会把正常请求一起堵住。判断一套方案是否稳,关键看三件事:单批事务有多大、WHERE 条件是否稳定命中索引、以及锁持有时间有没有被无关操作拉长。
这篇文章把原先分散的经验收拢成三条判断线:为什么要控制单次更新规模、为什么 UPDATE TOP(n)+主键推进 比 OFFSET/FETCH 更适合长批次任务,以及事务边界写错后会怎样悄悄制造阻塞。读完后,你可以据此检查现有存储过程是否存在高风险写法。
为什么分批更新要优先选主键推进
直接结论是:单个事务更新不要超过 5000 行。批量更新不是不能做大,而是单次事务一旦包住太多行,锁持有时间会明显变长,业务请求就更容易排队。
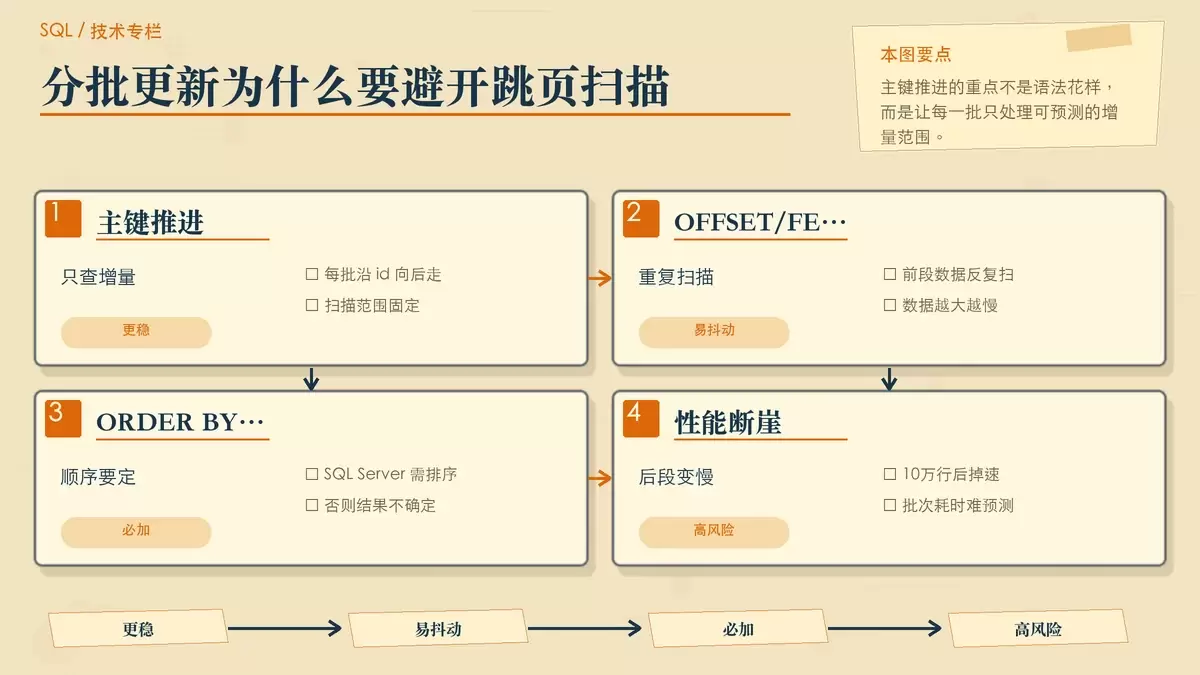
在分批策略里,UPDATE TOP(n) 配合主键推进,通常比 OFFSET/FETCH 更稳。原因很简单:OFFSET/FETCH 每次都要从头扫描前 N 行,数据量到 10 万行后,性能很容易出现断崖式下跌;而主键推进只处理增量范围,例如:
WHERE id > @last_id AND status = 'pending'这种写法每次都能沿着索引向后推进,扫描范围更小,执行时间也更可预测,更适合长时间运行的批处理过程。
不同数据库里的注意点
- 在 SQL Server 中,示例必须带上
ORDER BY id。如果没有ORDER BY,TOP取到哪些行并没有确定性,结果可能漏更新,也可能重复更新。 - MySQL 不支持
UPDATE + LIMIT的子查询直接回连同一张源表,实践里通常要改成变量游标,或者先查出一批 ID,再用IN做更新。 - PostgreSQL 常见写法是
UPDATE ... WHERE id IN (SELECT id FROM ... ORDER BY id LIMIT 1000)。这里的ORDER BY字段必须有索引,否则LIMIT看起来限制了行数,实际执行仍可能走全表扫描。
WHERE 不走索引,阻塞往往从这里开始
很多批量更新之所以影响业务,不是因为更新语句本身复杂,而是因为筛选条件没走索引。像 WHERE status = 'pending' 这类条件,如果没有合适索引,在 MySQL 或 SQL Server 上大概率会触发全表扫描。
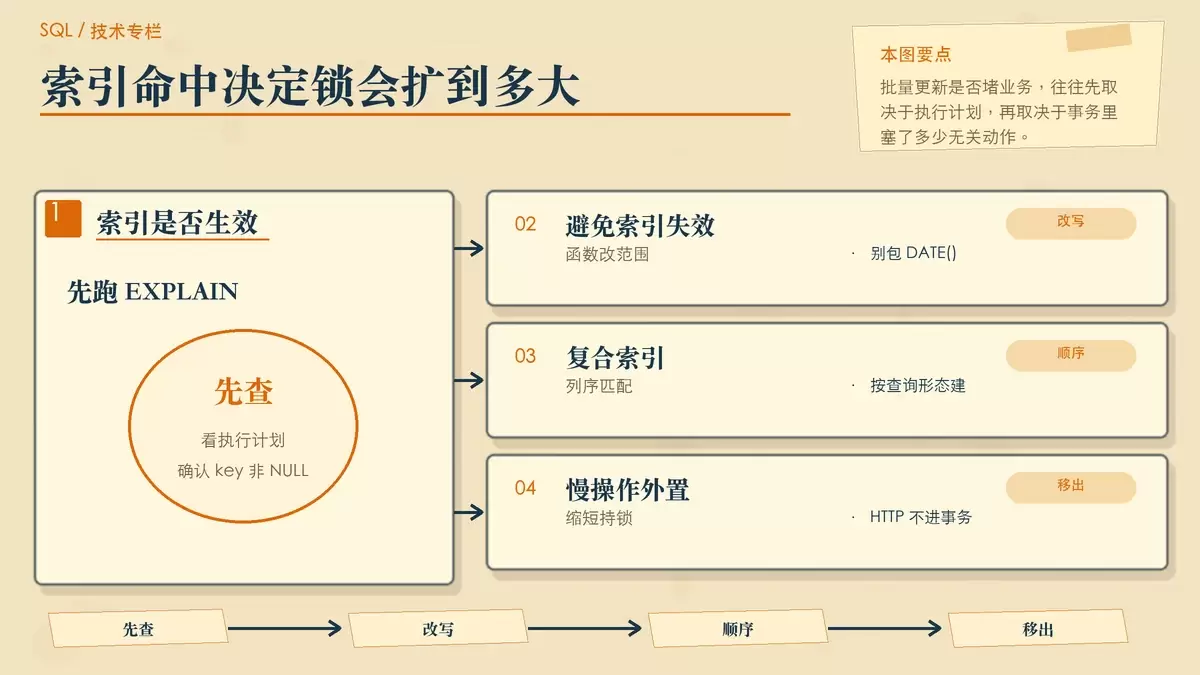
一旦数据库需要扫完整张表来找目标行,锁的影响面就会被放大。在 InnoDB 下,行锁可能进一步演变成更重的间隙锁,严重时接近“主动把整段业务流量排队”。所以,批量更新之前先确认执行计划,往往比调事务参数更有效。
检查索引是否真的生效
- MySQL 可以先跑
EXPLAIN UPDATE ...,PostgreSQL 可以看EXPLAIN (ANALYZE) UPDATE ...,重点确认执行计划中的key列不是NULL,或至少能明确看到索引被命中。 - 不要在索引列上做函数操作。比如把
WHERE DATE(created_at) = '2024-01-01'改写成:
WHERE created_at >= '2024-01-01' AND created_at < '2024-01-02'- 复合索引顺序必须和查询条件匹配。若查询主要形态是
status = ? AND user_id = ?,索引应设计成(status, user_id);把顺序反过来,实际效果可能大打折扣。
如果这一步没有做对,后面即使把每批控制在 1000 行、2000 行,阻塞问题也不一定能真正缓解,因为数据库仍在用高成本方式找出要更新的那些行。
事务边界写错,才是最隐蔽的长阻塞来源
比“每批更新多少行”更容易被忽略的,是事务到底包住了什么。有些存储过程会在 BEGIN TRANSACTION 之后直接套住整个 WHILE 循环,最后统一 COMMIT。这种写法表面上省事,实际却会把所有批次的锁都拖到最后才释放。
原文里给出的例子很直观:哪怕每行 UPDATE 只耗时 2ms,10 万行累计下来,锁持有时间也会超过 3 分钟。对于在线业务,这已经足以造成明显排队。
更稳的事务收口方式
- 每一批都应该独立执行
BEGIN TRANSACTION→ 执行 →COMMIT或ROLLBACK,不要把整个循环包成一个大事务,也不要想当然依赖自动提交。 SELECT FOR UPDATE必须紧贴UPDATE执行,避免“先锁住,再去做别的事”。所有耗时操作,包括 HTTP 调用、日志处理、JSON 解析,都应该移到事务之外。- SQL Server 中,事务逻辑最好放进
TRYCATCH,并对错误 1205(死锁)做重试处理,而不是让整个过程直接崩掉。 - MySQL 存储过程中要显式写
DECLARE CONTINUE HANDLER FOR SQLEXCEPTION,否则一旦出现异常,循环会被直接中断。
这里的核心不是“事务越少越好”,而是让每次锁定、更新、提交形成一个足够短、足够清晰的闭环。只要事务内部出现与更新无关的等待,阻塞就会被无意义地放大。
别忽略没有真正结束的“幽灵事务”
线上排查阻塞时,还有一类问题特别隐蔽:逻辑上看似已经跑完,实际上事务并没有真正结束。常见原因包括调试时中断执行、连接池复用后状态没清理、应用异常退出等。
这类残留事务可能表现为 trx_state = 'RUNNING'。它不一定马上去争抢业务锁,所以比死锁更难第一时间察觉,但它会持续拖慢 MVCC 清理、阻塞 DDL,还会长期占住连接资源。结果就是:系统表面还能运行,数据库内部却越来越“闷”。
因此,批量更新的验收标准不能只看“是否更新成功”,还要确认事务是否按预期结束、连接是否正确释放、以及异常路径是否能把现场清干净。
上线前可直接核对的三条硬规则
- 单个事务不要超过 5000 行更新,长批次任务优先采用主键推进,避免用
OFFSET/FETCH在大表上反复跳页。 WHERE条件必须走索引,先用EXPLAIN UPDATE ...或EXPLAIN (ANALYZE) UPDATE ...验证,再决定是否上线。- 事务里只放“锁定目标行并完成更新”这件事,
SELECT FOR UPDATE紧贴UPDATE,所有慢操作移出事务,每批独立提交或回滚。
如果这三条都满足,大多数“批量更新把业务拖慢”的问题,基本都能在上线前提前规避掉。









