


按周统计订单量看似只是一个分组问题,实际最容易出错的地方恰恰在“这周到底从哪天开始、哪一周算第 1 周”。如果直接套用数据库默认周函数,结果往往会在年初、年末出现错位,甚至冒出“第 0 周”。下面分数据库梳理自然周统计的正确写法,并说明跨年时为什么必须把 ISO 年和 ISO 周一起处理。
MySQL:`WEEK()` 默认规则为什么容易统计错
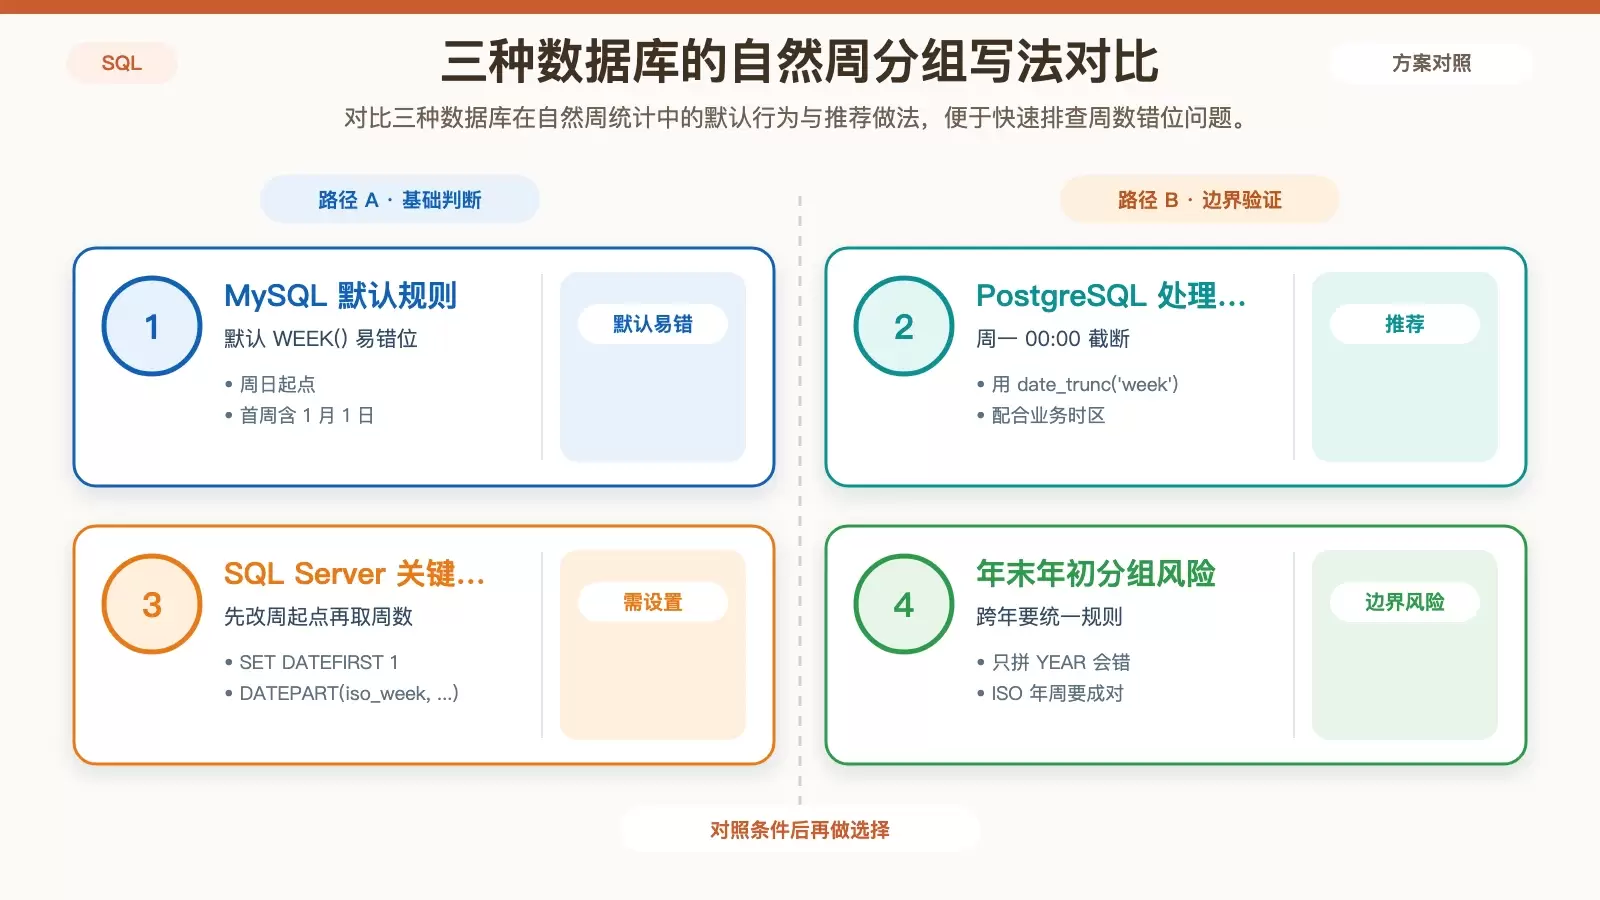
在 MySQL 里,直接使用 WEEK(order_time) 分组,通常不是按大家习惯的“周一到周日”来算。它默认以周日作为一周起点,而且第 1 周按“包含 1 月 1 日的那一周”定义,这和自然周或 ISO 周的理解并不一致。
这会带来两个典型问题:一是年初数据可能被算进“第 0 周”;二是跨年附近的订单会落到看起来不合理的周数里,造成周报、看板统计结果偏差。
如果目标是按自然周分组,应显式指定模式参数:
WEEK(order_time, 1)这里的 1 表示按周一作为每周第一天,并按 ISO 周规则处理首周。这样才能让像 2024-01-01 这样的日期,稳定归入符合预期的自然周中。
MySQL 中应避免的写法
下面两种写法最常见,也最容易埋坑:
GROUP BY WEEK(order_time)问题在于没有明确指定模式,结果依赖默认设置,可读性和可移植性都很差。
WEEK(order_time, 0)这个模式以周日为起点,和多数业务场景下对“自然周”的认知并不一致。
如果你的分组结果还需要同时表达“周所属年份”,仅按 WEEK(order_time, 1) 取周数仍然不够,跨年场景下还需要结合 ISO 年一并处理,后文会展开说明。
PostgreSQL:用 date_trunc() 和 ISO 格式做自然周统计
PostgreSQL 没有 MySQL 那样的 WEEK() 函数,但它在自然周处理上反而更直接。因为 date_trunc('week', order_time) 默认就会截断到该周的周一 00:00,这正好符合多数统计场景需要的周起点。
因此,按自然周汇总时,最简做法通常是按周一日期分组。但在实际查询前,要先确认时区设置符合业务口径,例如:
SET timezone = 'Asia/Shanghai';如果时区不对,同一条订单时间在截断后可能被归到前一周或后一周,尤其是跨天、跨时区写入的数据更容易出现偏差。
需要展示周标识时的推荐写法
如果报表里不仅要统计,还要展示类似 2024-W01 这样的自然周编号,可以使用:
TO_CHAR(order_time, 'IYYY-IW')其中:
IYYY表示 ISO 年IW表示 ISO 周
这两个格式项是严格配套的,适合直接用于周维度展示或导出。
为什么不建议直接用 EXTRACT(WEEK FROM ...)
虽然 PostgreSQL 也支持 EXTRACT(WEEK FROM order_time),但它返回的是“年度第几周”的数字,本身并不适合作为自然周统计的完整键值。尤其在需要处理跨年数据时,单独使用周数很容易造成混淆。
如果业务要求稳定的自然周维度,优先使用周一起始日期,或者直接使用 TO_CHAR(order_time, 'IYYY-IW') 这样的 ISO 年周组合。
SQL Server:只用 DATEPART(week, ...) 为什么总会偏
在 SQL Server 中,DATEPART(week, order_time) 同样不是按自然周默认工作的。它通常按周日作为每周起点,并且从 1 月 1 日开始计第 1 周,所以结果经常和业务上理解的周报错开一天甚至错开一整周。
要按自然周处理,至少需要先设置:
SET DATEFIRST 1这一步把周一设为每周第一天。随后再取 ISO 周数:
DATEPART(iso_week, order_time)这种方式比普通 week 参数更接近自然周定义。
更稳妥的做法:先归一化到周一
如果你希望分组键更直观,或者所在环境存在版本差异,先把日期归一化到周一,再按该日期分组会更稳妥。文中的公式是:
DATEADD(day, 2 - DATEPART(weekday, order_time), order_time)这个公式假设 DATEFIRST 为 7,也就是周日对应 1。算出当周周一后,再进一步去掉时间部分:
CAST(... AS DATE)最终按这个日期字段分组,往往比直接拼周数字段更清晰,也更方便排查跨周边界问题。
版本限制要提前确认
iso_week 仅在 SQL Server 2012+ 支持。如果是更低版本,就不能依赖这个参数,必须手动计算周一起始日期,否则周数偏移问题很难彻底避免。
跨年边界:为什么周数对了,年份仍可能错
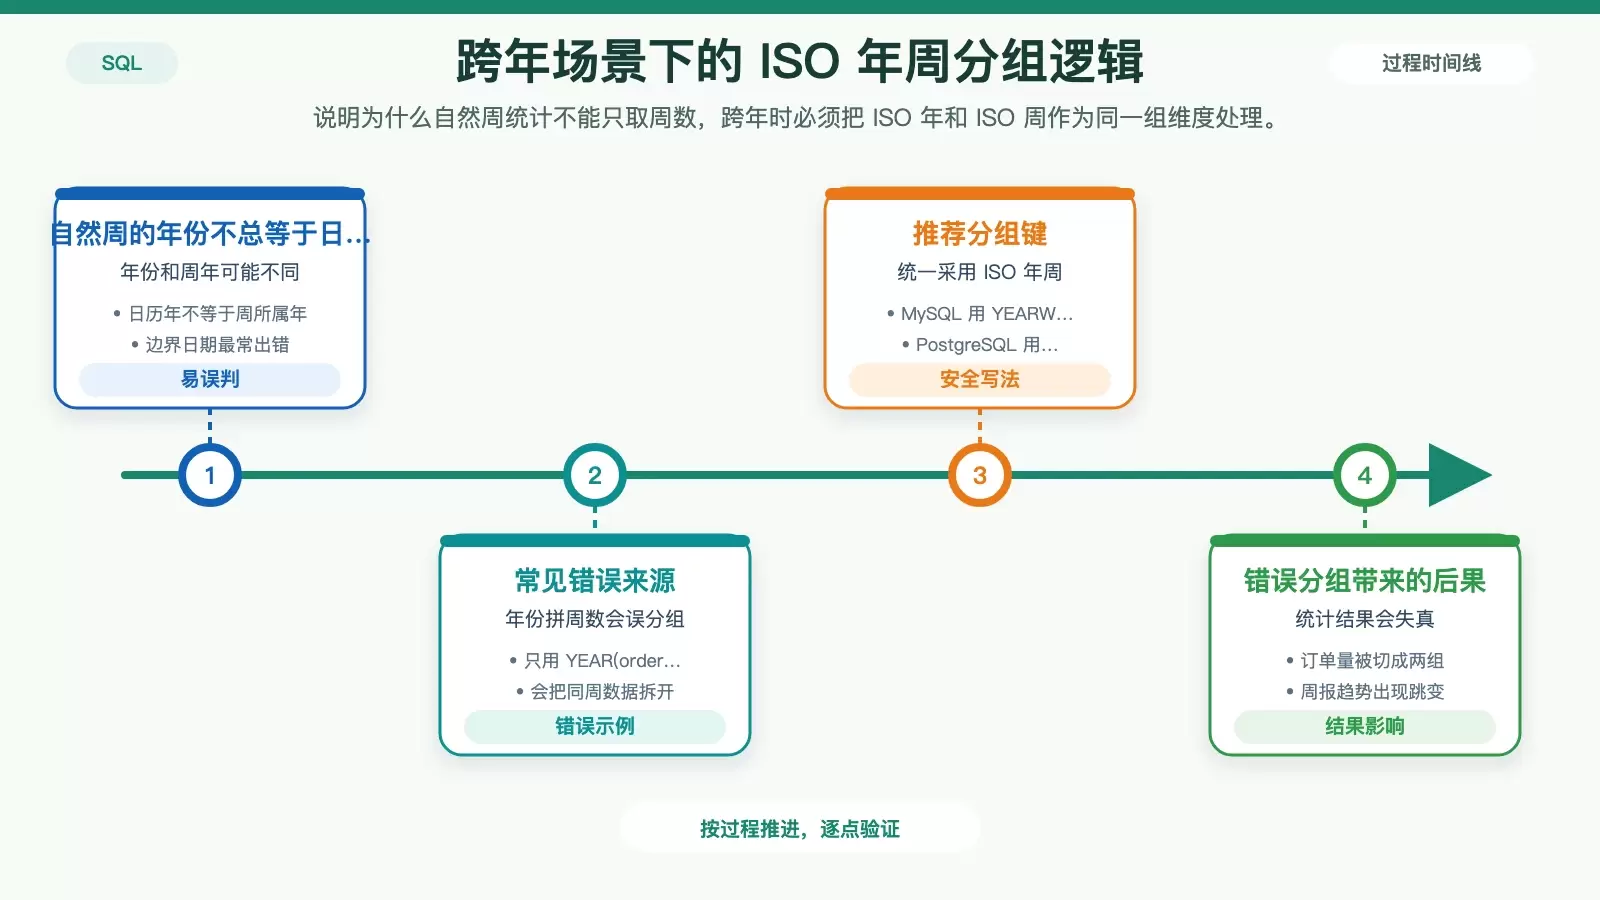
按自然周统计时,最容易被忽略的不是“周几开始”,而是“这一周属于哪一年”。自然周体系里,周所属的年份和日历年不一定一致,跨年那几天尤其容易出问题。
例如某些日期虽然日历上已经进入新的一年,但从 ISO 周视角看,仍然属于上一年的最后一周;反过来,年末的日期也可能被归入下一年的第 1 周。此时如果只拿 YEAR(order_time) 去拼周数,就会把周标识拼错,进而把本该在同一周的数据拆成两个分组。
这也是为什么仅用“年份 + 普通周数”并不安全。更稳妥的办法,是统一采用 ISO 年和 ISO 周来表达周维度。
各数据库的安全写法
- MySQL:
YEARWEEK(order_time, 1),返回类似202401这样的整数 - PostgreSQL:
TO_CHAR(order_time, 'IYYY-IW') - SQL Server:
FORMAT(order_time, 'yyyy-MM') + '-W' + RIGHT('0' + CAST(DATEPART(iso_week, order_time) AS VARCHAR(2)), 2)
需要注意的是,这里的关键思想不是“把周数显示出来”,而是要让“周所属年份”和“周编号”使用同一套规则。否则像 2024-12-31 和 2024-01-01 这种边界日期,就可能被错误拆开,最终把订单数量切分到不同周里。
实务判断:按自然周统计时该怎么选
如果你的目标只是做稳定的订单周统计,可以优先遵循一个简单原则:不要依赖数据库默认周规则,统一显式使用 ISO 周或周一起始日期。
- 在 MySQL 中,先确认是否使用
WEEK(order_time, 1)或YEARWEEK(order_time, 1) - 在 PostgreSQL 中,优先使用
date_trunc('week', order_time)或TO_CHAR(order_time, 'IYYY-IW') - 在 SQL Server 中,确认
SET DATEFIRST 1、DATEPART(iso_week, ...)以及版本是否支持
如果报表还要长期用于同比、环比、跨年趋势分析,那么分组字段最好直接设计成“ISO 年 + ISO 周”或者“该周周一日期”。这样既能避免年初年末错位,也更方便在不同数据库之间迁移统计逻辑。









