

Python使用pandas读取竖线分隔符文本文件
本文介绍如何利用Python的pandas库读取以竖线'|'作为分隔符的文本文件。通过指定sep参数为'|'并设置dtype为'str',可确保所有列数据均按字符串类型处理,适用于20180201.txt等格式文件的快速解析与预处理。
2026-10-13
6

本文介绍如何利用Python的pandas库读取以竖线'|'作为分隔符的文本文件。通过指定sep参数为'|'并设置dtype为'str',可确保所有列数据均按字符串类型处理,适用于20180201.txt等格式文件的快速解析与预处理。
本文介绍如何使用Pandas库中的apply函数对DataFrame指定列进行批量条件赋值。通过定义自定义函数并结合lambda表达式,实现如数值大于等于阈值赋1、否则赋0的逻辑,帮助开发者高效处理数据清洗与特征工程中的条件转换任务。
本文介绍如何在pandas中利用apply函数结合多列数据生成新列。通过定义接收多个参数的自定义函数,并设置axis=1逐行处理,实现复杂逻辑计算。示例展示了如何基于diff和shift生成的相邻行数据,计算绝对值最小值,为复杂数据变换提供参考。
本文介绍在 pandas 中实现数据归一化及基于阈值删除行的方法。通过定义 row_del 函数,可根据非空值比例(num_percent)和标签列长度删除缺失数据过多的行。data_normalization 函数支持忽略指定标签列,将数值统一至 float64 并映射至 [-1, 1] 区间。示例展示了处理含缺失值、字符串及整数混合数据框的操作流程,适用于机器学习前的数据预处理阶段。
本文详细解析NumPy中loadtxt函数的核心参数与使用方法。通过Jupyter Notebook交互演示,涵盖skiprows跳过行、comments忽略注释、usecols选取列、unpack分离输出及converters数据转换等关键功能,帮助开发者高效读取TXT格式数值数据。
本文介绍使用NumPy对矩阵进行归一化的具体实现方法。核心在于将均值、最大值和最小值的计算结果预先存储为变量,避免在循环中重复计算,从而显著提升处理速度。文章提供了简洁的五行代码示例及关键注意事项,适用于需要高效数据预处理的Python开发场景。
本文详细解析数据归一化的核心概念及其必要性,包括加速梯度下降与提升模型精度。重点介绍线性归一化、标准差标准化及非线性归一化(如Log变换)三种类型,并提供基于Python NumPy的具体实现代码,帮助开发者掌握不同场景下的数据预处理技巧。
本文介绍如何使用sklearn.preprocessing.LabelEncoder将分类标签转换为0到n_classes-1之间的连续整数编码。通过fit、transform和inverse_transform方法,可实现标签的标准化处理。文中提供了针对Series、DataFrame整体及特定列的多种转换示例,包括自定义多列编码器类的使用,帮助开发者高效完成分类数据的预处理工作。
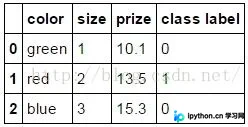
本文介绍在pandas中利用get_dummies函数对离散特征进行one-hot编码的方法。针对无序分类特征如颜色,可直接使用get_dummies生成独热向量;针对有序特征如尺码,则建议先通过字典映射转换为数值。文章提供了具体的DataFrame构建、映射及编码代码示例,帮助开发者高效完成数据预处理。
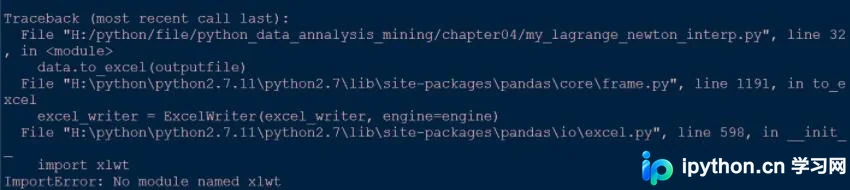
本文针对Python使用pandas库将DataFrame写入Excel时遇到的两个常见错误进行解析。首先介绍如何通过pip安装缺失的xlwt依赖库;其次重点解决因Windows路径中单斜杠导致的to_excel报错,指出需将路径中的单斜杠替换为双斜杠以正确处理转义字符,确保文件成功保存。
本文详细介绍Python机器学习库scikit-learn的安装步骤及基础应用。涵盖NumPy、SciPy等依赖配置,演示数据加载、归一化、特征选择与提取流程,并实战朴素贝叶斯、k近邻及决策树算法,帮助开发者快速上手数据挖掘与分析。
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。