基于Pandas的Titanic数据预处理实战指南
本文以Kaggle Titanic竞赛数据为例,详细讲解使用Pandas进行数据预处理的完整流程。内容涵盖数据加载、维度与类型检查、缺失值填充策略(丢弃或填充)、数值特征离散化及类别变量映射,以及通过GroupBy和Pearson系数分析特征与目标变量的关系,为后续模型构建奠定基础。
2026-10-13
6

本文以Kaggle Titanic竞赛数据为例,详细讲解使用Pandas进行数据预处理的完整流程。内容涵盖数据加载、维度与类型检查、缺失值填充策略(丢弃或填充)、数值特征离散化及类别变量映射,以及通过GroupBy和Pearson系数分析特征与目标变量的关系,为后续模型构建奠定基础。
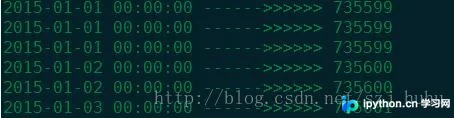
本文介绍在机器学习与深度学习中,如何利用Python的pandas和numpy库处理CSV文件中的时间变量。通过示例代码展示将时间列合并、解析为标准格式,并转换为float或int类型数值的过程,以便进行后续的分析与建模。
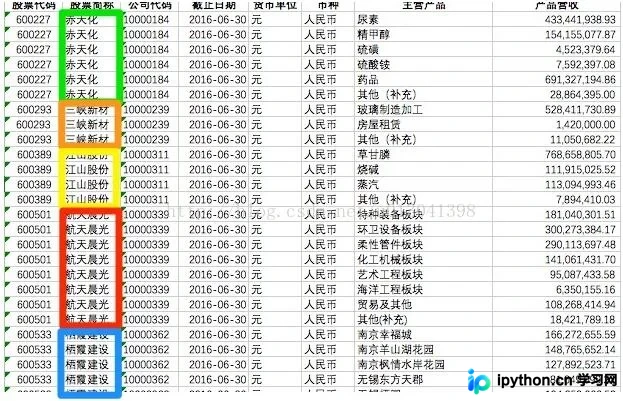
本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
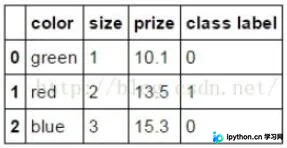
本文介绍Python中处理非数值类别数据的三种方法:使用LabelEncoder快速转换、通过字典映射手动指定数值,以及利用get_dummies生成虚拟变量。内容涵盖具体代码实现与适用场景,帮助开发者高效完成数据预处理。
本文总结Python中处理缺失值的五种主要方法,包括忽略元组、人工填写、全局常量、均值填充及最可能值预测。结合Scikit-learn库的Imputer类,演示如何使用均值策略填充NaN数据,并分析各方法的适用场景与局限性,帮助开发者选择合适的数据预处理方案。
本文深入解析Python机器学习中的数据预处理技术,涵盖标准化、归一化、正则化、离散化和白化五大核心方法。通过Scikit-learn库的实战代码示例,详细阐述各方法的原理、适用场景及参数设置,帮助开发者优化模型输入特征,提升算法精度与训练效率。
本文详解 Python 中 strip()、lstrip() 与 rstrip() 函数的实际用法。通过参数配置与操作顺序演示如何高效清理字符串两端的指定字符或默认空白符,澄清字符集合匹配机制,提供可运行的代码示例与避坑指南。
本文介绍如何使用Python Pandas库对数据集进行随机抽样。通过DataFrame.sample()方法,可以指定抽取行数(n)、比例(frac)、是否放回(replace)及权重(weights)。此外,还探讨了利用Numpy进行索引抽样的替代方案,适用于不同场景下的数据采样需求。
本文系统整理Python数据清洗的核心代码实例,涵盖多格式文件读写、时间序列处理、分组聚合运算、多表合并、缺失值填补及行列转换等高频场景。通过标准化pandas操作与内置函数,提供可直接复制运行的脚本模板,帮助开发者快速提升数据处理效率。
本文详解Python中两种主流数据归一化方法:Min-Max标准化与Z-Score标准化。通过sklearn.preprocessing库的MinMaxScaler实现[0,1]区间缩放,以及基于均值和标准差的Z-Score转换。文章提供完整代码示例,解析公式原理及适用场景,帮助开发者高效进行数据预处理。
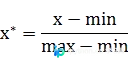
数据预处理是提升机器学习模型性能的关键环节。本文详细介绍基于Python与scikit-learn的核心预处理步骤,涵盖缺失值智能填充、异常值统计检测、分类变量独热与顺序编码,以及数值特征的标准化与归一化转换。结合可直接运行的代码示例,提供从原始数据到模型就绪数据的完整操作指引。
在数据预处理中,将类别属性转化为数值属性是常见需求。本文介绍两种基于pandas的处理方法:针对无大小意义的离散特征使用get_dummies进行One-Hot编码;针对有大小意义的特征,通过字典映射将其转换为有序的数值。