Python读取.mat文件并提取数据:从scipy到pandas的完整流程
本文详解如何使用Python读取.mat文件并提取所需信息。通过scipy.io.loadmat加载文件,解析返回的字典结构,获取指定Key对应的numpy数组。随后利用pandas将多维数组转换为DataFrame格式,便于后续的数据展示与分析处理。
2026-10-13
2

本文详解如何使用Python读取.mat文件并提取所需信息。通过scipy.io.loadmat加载文件,解析返回的字典结构,获取指定Key对应的numpy数组。随后利用pandas将多维数组转换为DataFrame格式,便于后续的数据展示与分析处理。
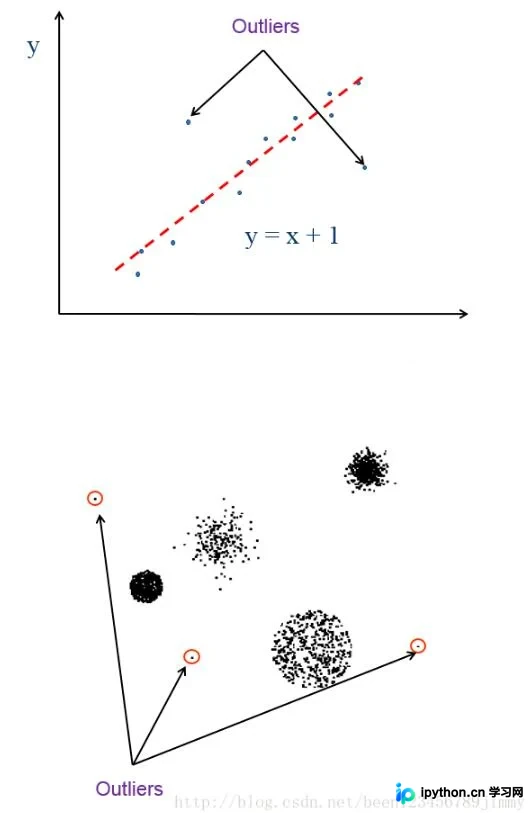
本文通过Python实例演示如何使用箱型图(Boxplot)识别并可视化餐饮销售数据中的离群点。文章首先区分了离群点与异常值的概念差异,随后提供基于pandas和matplotlib的完整代码,展示如何读取Excel数据、绘制箱线图,并通过annotate函数对离群点进行精确标注与位置微调,帮助开发者掌握数据清洗中的异常值处理技巧。
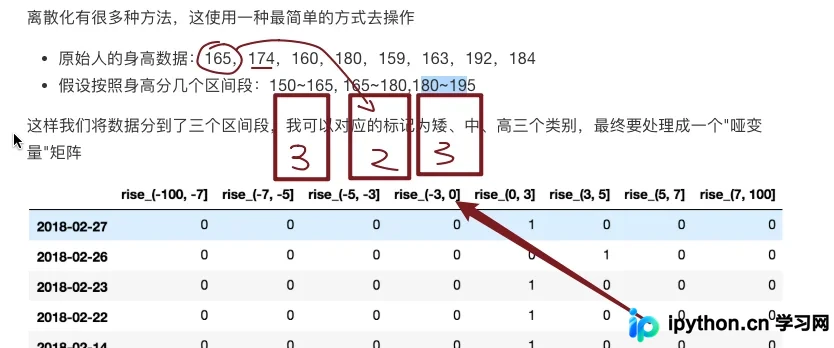
本文详解Pandas中数据离散化的原理与实现,通过股票涨跌幅数据案例,演示如何利用pd.cut进行等宽分箱和pd.qcut进行等深分箱。内容涵盖自定义区间设置、分组统计及代码实现,帮助开发者简化连续数据结构,提升模型泛化能力。
本文详细讲解在Python中利用Pandas处理时间序列数据时遇到的日期缺失问题。通过示例代码展示如何构建连续日期序列,并将原始数据映射至完整时间轴,实现缺失日期的自动填充与插值替换。适合需要进行时间序列分析且遇到数据预处理瓶颈的开发者参考。
本文系统整理 Python pandas 库的核心用法,涵盖数据导入、信息查看、清洗(空值处理、格式转换)、预处理(合并、排序、条件判断)、提取与筛选、汇总统计(groupby、采样、相关性)及输出保存等全流程操作,提供实用代码示例。
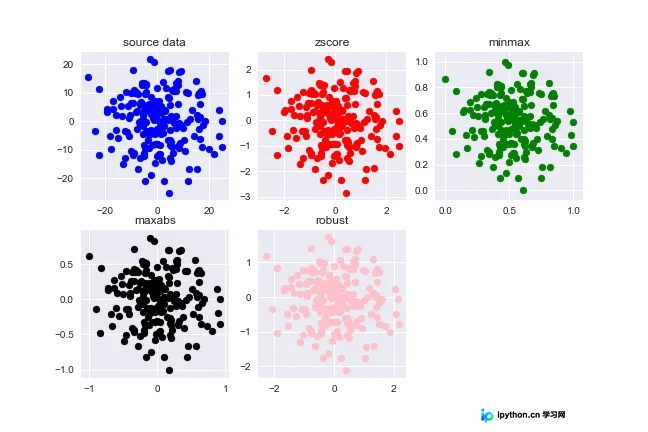
本文介绍Python中数据标准化的四种核心方法:Max-Min归一化、Z-Score标准化、MaxAbs绝对值标准化及RobustScaler鲁棒标准化。通过Sklearn库实现,解析各方法适用场景,如稀疏数据与含离群点数据的处理,助力提升模型训练效果。
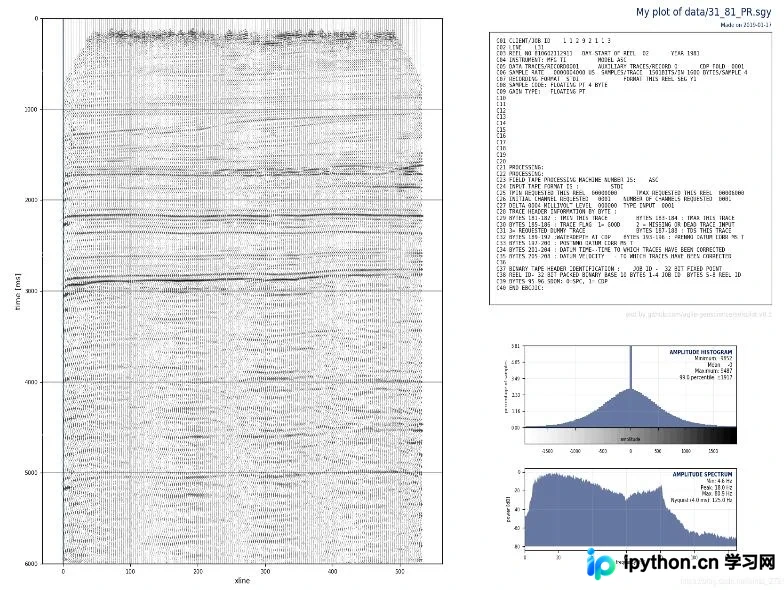
本文详解使用Python进行地震数据可视化的完整流程。涵盖Windows10下Python3.7环境搭建、obspy等依赖包安装及代理配置,深入分析config.yml编码异常(GBK与UTF-8冲突)的解决方法。针对本地SEGY数据绘图时出现的采样值溢出、卷头乱码及道头参数不规范等问题,提供了归一化处理、重写3200字节卷头及规范cdpt取值的具体解决方案,并对比了Cygwin与CMD终端的使用体验。
本文详细介绍利用pandas进行数据集端到端处理的流程,涵盖从基本信息查看、统计分析及直方图绘制,到数据集拆分、分类特征转换及缺失值填充等关键步骤。通过具体代码示例,帮助读者掌握数据清洗与预处理的核心技巧。
本文介绍在pandas中如何将数据框内所有大于0的数值统一替换为1。核心方法是通过布尔条件df>0生成掩码,并直接对匹配位置赋值1。该操作适用于数据标准化或二值化处理场景,代码简洁高效,适合初学者参考。
本文介绍如何使用 Python 的 NumPy 库对二维数组进行按行归一化处理。通过计算每行的最大值与最小值,利用公式 (Z - Zmin) / (Zmax - Zmin) 将数据映射到 0 到 1 区间。文中提供了完整的代码示例,展示了随机生成数组及执行归一化的具体步骤,适用于机器学习中的数据预处理场景。
本文详解Python中数据预处理的规范化技术,旨在消除量纲差异。通过Pandas库实现最小-最大规范化与零-均值规范化两种核心方法,提供完整代码示例及Excel数据源下载,帮助开发者掌握数据缩放技巧,提升模型分析效果。
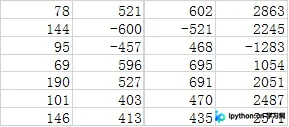
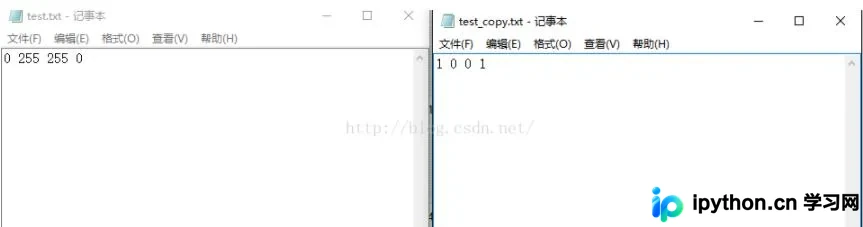
本文介绍了使用Python读取txt文件内容并修改字符的方法。通过遍历读取的每一行数据,将数值0替换为1,将255替换为0,最后将处理后的结果写入新的txt文件。虽然算法复杂度较高,但实现了预期的数据转换功能,适合需要简单文本处理场景的参考。