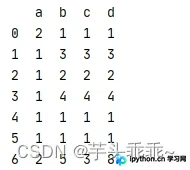
pandas调整列的顺序以及添加列的实现
本文介绍在pandas中如何调整DataFrame的列顺序、添加新列以及修改列名。通过直接指定列名列表实现重排,利用直接赋值或assign方法添加单列或多列,并使用rename接口修改列名。
2026-10-11
6

本文介绍在pandas中如何调整DataFrame的列顺序、添加新列以及修改列名。通过直接指定列名列表实现重排,利用直接赋值或assign方法添加单列或多列,并使用rename接口修改列名。
本文详解pandas中df.dropna()函数的使用,涵盖Series和DataFrame的缺失值删除。重点解析axis、how、thresh、subset和inplace等关键参数,通过具体代码示例展示如何灵活处理不同场景下的NaN数据,帮助开发者高效清理数据。
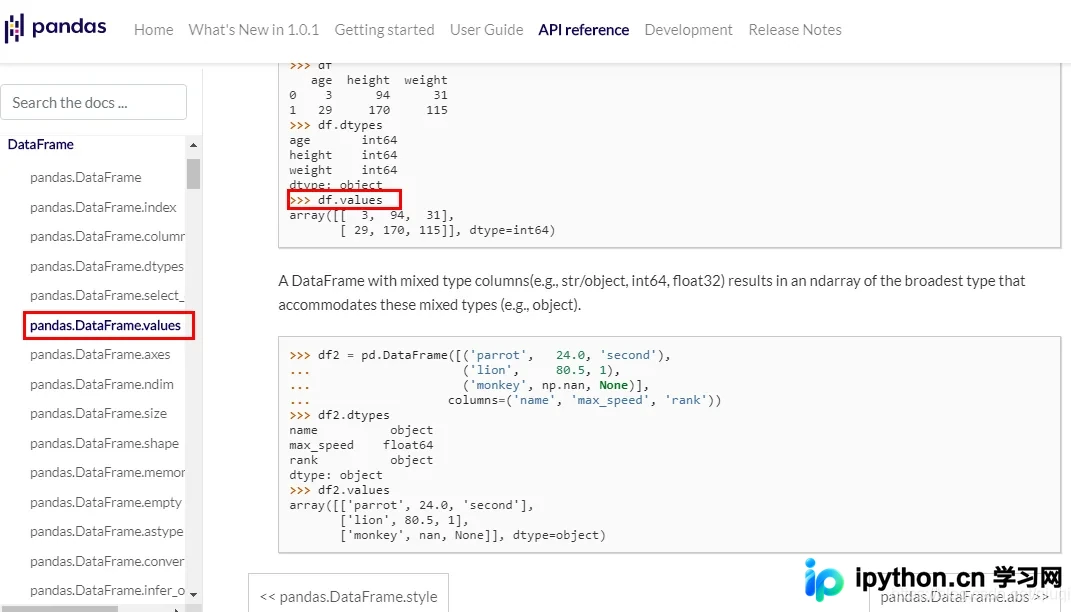
在使用 pandas 处理数据时,常见因版本迭代引发的 as_matrix 缺失报错,以及将多值数组强行存入单单元格导致的 type 类型转换错误。本文通过核查版本替换 values 属性,演示将多维数据拆分为独立列以修正数据类型的方法,配合 .info() 验证与文件读取操作,快速恢复代码正常运行。
本文介绍在pandas中统计DataFrame重复值次数的两种核心方法。通过duplicated()标记重复行,结合布尔索引筛选并统计数量;或利用drop_duplicates()计算去重前后的行数差值。文章包含完整的代码示例与结果解析,帮助快速处理数据清洗中的重复项问题。
本文介绍如何使用Python的pandas库读取Excel表格指定列的数据,并通过循环处理将单行数据拼接为带有单引号和逗号分隔的字符串格式。文章提供了完整的Python脚本源码,包含文件校验、列号输入、数据清洗及结果写入文本文件的完整流程,适用于需要将大量代码或ID批量转换为SQL插入语句等场景。
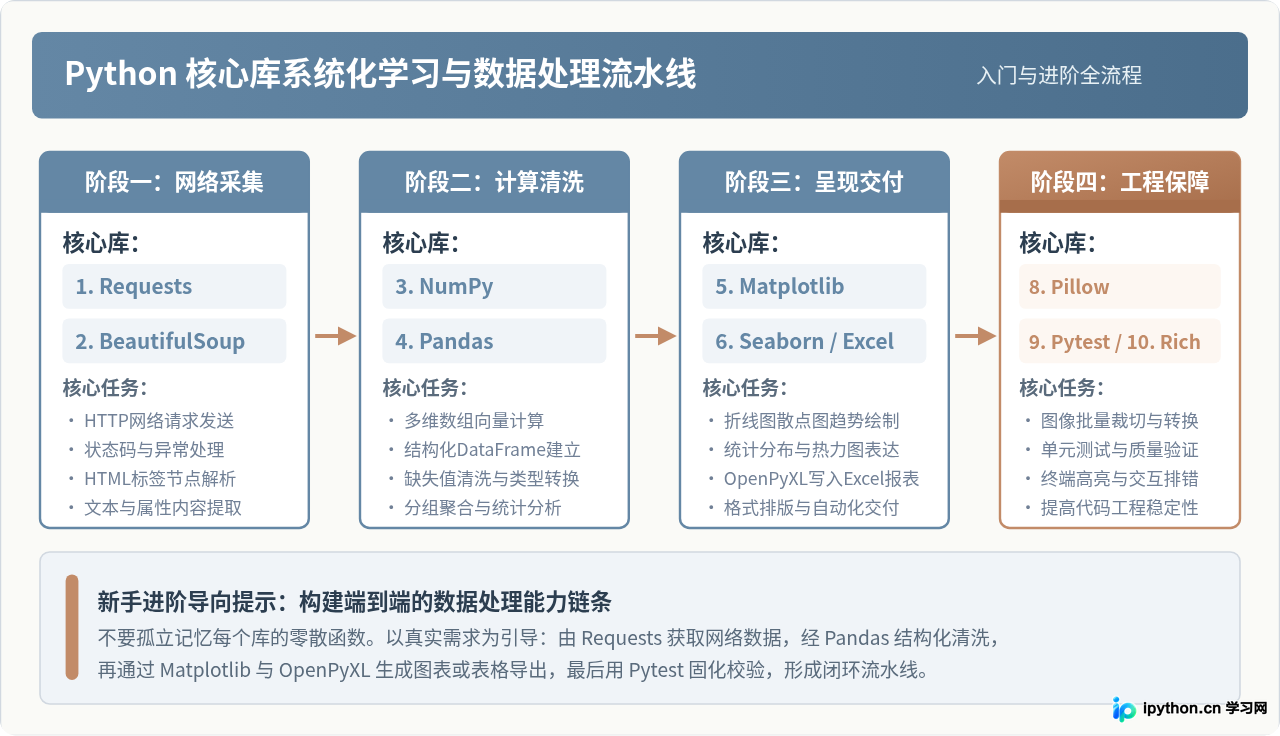
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
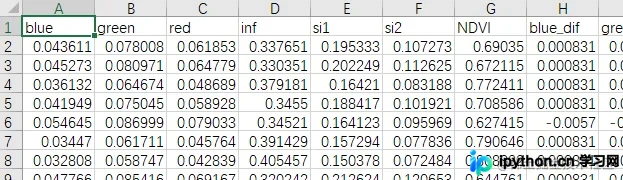
本文详细介绍如何使用Python的Pandas库读取Excel或CSV表格,通过设定各列数据的数值区间进行条件过滤。演示多条件独立筛选与批量合并筛选的代码实现,快速剔除不符合范围的异常样本行,保留核心数据并导出为新文件。
本文详细解析在Python Pandas中将包含列表的列拆分为多行的多种实现方法。通过对比apply、repeat、reindex及numpy组合等方案的性能与适用场景,帮助开发者选择最高效的数据处理策略。
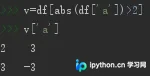
本文详细讲解在 Pandas DataFrame 列中按条件筛选和查找数据的方法。通过 .where() 方法与布尔索引实现跨列条件判断、绝对值过滤及数值比对,附完整代码示例与输出结果说明,帮助开发者快速处理特征数据。
本文详细介绍如何使用pandas库高效处理CSV文件。涵盖指定编码(如GBK)读取数据、日期字段类型转换、多列字符串拼接、基于符号的数值计算、数据分组聚合以及去重保存等核心操作步骤,帮助开发者快速完成数据清洗任务。
使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
Pandas 提供的 drop_duplicates() 方法专为 DataFrame 数据去重设计。通过调整 subset 指定查重范围、keep 控制保留策略以及 inplace 决定修改方式,可灵活清理冗余记录。本文结合标准示例数据,逐步演示默认去重、全量剔除、单列或多列组合去重的完整操作逻辑,助力高效完成数据预处理。