

Pandas 去重函数 drop_duplicates() 核心用法与场景解析

Pandas 提供的 drop_duplicates() 方法专为 DataFrame 数据去重设计。通过调整 subset 指定查重范围、keep 控制保留策略以及 inplace 决定修改方式,可灵活清理冗余记录。本文结合标准示例数据,逐步演示默认去重、全量剔除、单列或多列组合去重的完整操作逻辑,助力高效完成数据预处理。
Pandas 去重函数 drop_duplicates() 参数解析
该函数用于从 DataFrame 中识别并移除重复行。掌握核心参数即可覆盖绝大多数清洗场景:
- subset:
str或list,定义参与重复判断的列名。默认为None(整行比对)。 - keep:
str,控制保留哪条记录。支持'first'(保留首次出现,默认)、'last'(保留末次出现)及False(彻底清除所有重复项,仅留绝对唯一值)。 - inplace:
bool,设为True时直接在原对象上修改内存,返回None;False则返回新副本(默认)。 - ignore_index:
bool,设为True可使去重后的 DataFrame 索引从 0 连续重置,避免产生空缺编号。
实操步骤:分场景演示去重逻辑
第1步:准备基础示例数据
目的:构建包含若干完全重复行与局部重复行的样本表,便于直观观察去重前后的数据变化。动作:在标准 Python 环境中初始化 DataFrame。
import pandas as pd

data = pd.DataFrame({
    'a': [2, 1, 1, 1, 1, 1, 2],
    'b': [1, 3, 2, 4, 1, 1, 5],
    'c': [1, 3, 2, 4, 1, 1, 3],
    'd': [1, 3, 2, 4, 1, 1, 8]
})
print(data)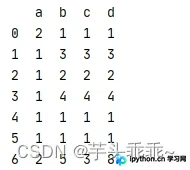
第2步:执行默认去重(保留首条记录)
目的:快速清理完全重复的行,仅保留首次出现的完整记录。动作:不传入额外参数直接调用。
data_first = data.drop_duplicates()
print(data_first)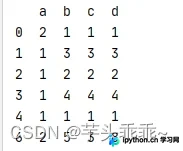
第3步:彻底删除所有重复记录(keep=False)
目的:当业务要求仅保留绝对唯一的行时,移除任何出现过多次的记录。动作:设置 keep=False。
data_unique = data.drop_duplicates(keep=False)
print(data_unique)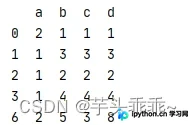
第4步:基于指定单列进行去重
目的:忽略其他字段差异,仅根据某一关键字段(如 ID 或分类码)判定重复。动作:传入 subset 参数指定列名。
data_subset_1 = data.drop_duplicates(subset=['b'], keep=False)
print(data_subset_1)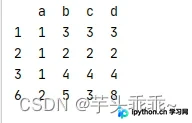
第5步:多列组合判定去重
目的:防止单列冲突带来的误判,采用多个字段联合哈希识别重复体。动作:在 subset 中传入列表配置多列。
data_subset_multi = data.drop_duplicates(subset=['b', 'c'], keep=False)
print(data_subset_multi)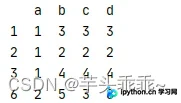
在实际工程流水线中,若需原地覆盖旧表以节省内存分配,可直接使用 data.drop_duplicates(inplace=True)。涉及大规模数据集或生产环境备份时,建议先对原对象执行 .copy() 再操作,防止不可逆覆盖。完成上述任一流程后,返回的 DataFrame 即为清理干净的洁净数据,可直接衔接下游统计分析与机器学习建模环节。
以上就是 Pandas drop_duplicates 函数详细使用教程的详细内容,更多关于 Python 数据清洗与处理相关资料的关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









