

解决pandas报错'DataFrame' object has no attribute 'as_matrix'问题

在使用 pandas 处理数据时,常见因版本迭代引发的 as_matrix 缺失报错,以及将多值数组强行存入单单元格导致的 can't convert the string to 'float' 错误。本文通过核查版本替换 values 属性,演示将多维数据拆分为独立列以修正数据类型的方法,配合 .info() 验证与文件读取操作,快速恢复代码正常运行。
pandas版本升级导致 as_matrix 缺失的解决方法
运行类似 data = data.as_matrix(columns=None) 的代码时,终端会抛出 'DataFrame' object has no attribute 'as_matrix' 异常。该问题源于 pandas 从 0.25 版本起已正式弃用并移除此方法。首先需确认当前环境的库版本:
import pandas as pd
print(pd.__version__)
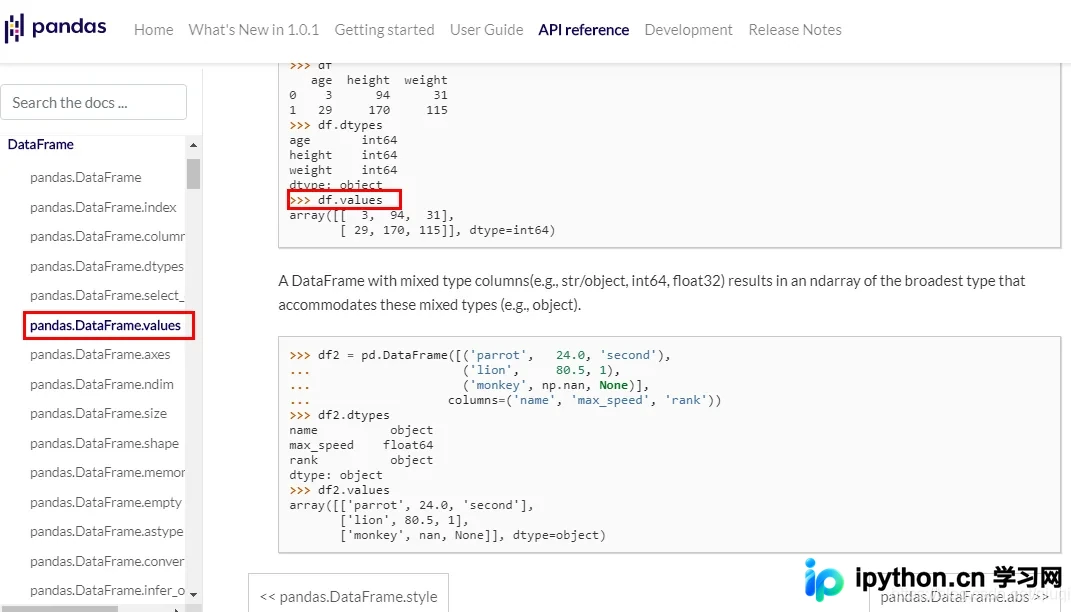
查阅官方文档可知,官方推荐的替代方案是直接使用 .values 属性(新版亦推荐使用 .to_numpy())。将原代码替换为:
data = data.values
DataFrame 单元格混装数组引发 object 类型转换异常的处理
在进行分类标签映射或矩阵准备时,若尝试将形如 [1, 0] 的序列直接写入 DataFrame 某一列的单行中,例如:
df2.fakelab1.loc[i] = [1, 0]
pandas 会将该整体解析为字符串对象并存入单一单元格。此时若直接参与数值计算或传给需要浮点数的模型接口,便会触发 can't convert the string to 'float' 错误。执行 df2.dtypes 检查可发现该列的实际类型为 object 而非预期的浮点型。
正确的做法是依据数据维度提前规划列结构,将每个独立数值分配至单独的列中,彻底杜绝列表混装:
df2 = pd.DataFrame(columns=['fakelab1', 'fakelab2'])
df2['fakelab1'].loc[i] = 1
df2['fakelab2'].loc[i] = 0
赋值完成后,使用 .info() 方法核对数据结构。此时可见目标列的数据类型已自动推断为 float64,完全满足后续计算需求:
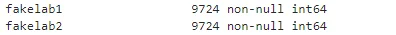
数据格式校验无误后,即可按既定列索引安全地读取文件或送入下游流程。例如读取特定列范围的 CSV 数据:
dataOutTr = pd.read_csv('./1.csv', usecols=[i for i in range(36, 38)])总结
以上就是 pandas 常见属性缺失与数据类型转换错误的详细内容,更多关于 Python 数据处理与 DataFrame 优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









