R语言批量读取TCGA数据并整合表达矩阵的方法
本文介绍在R语言中处理TCGA等大规模生物信息数据的技巧,重点解决如何批量读取指定路径下的多个文本文件。通过遍历目录、提取元数据映射ID、使用data.table::fread加速读取,并结合for循环或lapply函数将各文件的第二列(如基因表达量)合并为一个完整的数据框,最终生成包含所有样本的表达式矩阵。
2026-10-16
7

本文介绍在R语言中处理TCGA等大规模生物信息数据的技巧,重点解决如何批量读取指定路径下的多个文本文件。通过遍历目录、提取元数据映射ID、使用data.table::fread加速读取,并结合for循环或lapply函数将各文件的第二列(如基因表达量)合并为一个完整的数据框,最终生成包含所有样本的表达式矩阵。
本文深入解析Python中Numpy库在数据分析中的核心应用,重点讲解如何利用cov和corrcoef函数计算股票收益率的协方差与相关系数,以评估资产间关联度。同时,通过polyfit和polyval实现多项式拟合与趋势预测,结合polyder求解极值,为量化交易和趋势分析提供完整的数学工具链与代码示例。
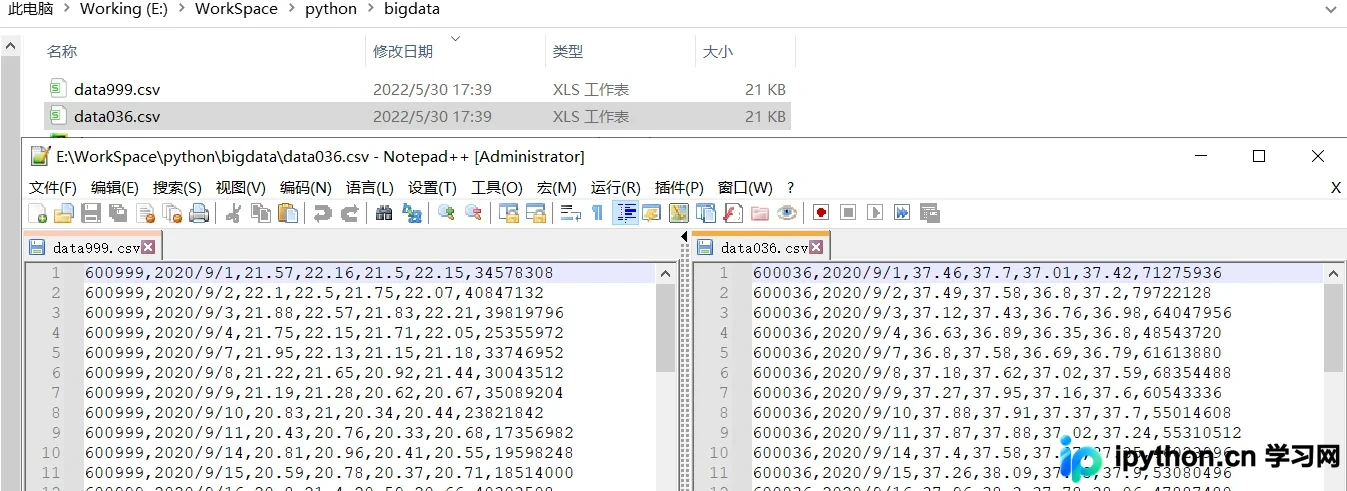
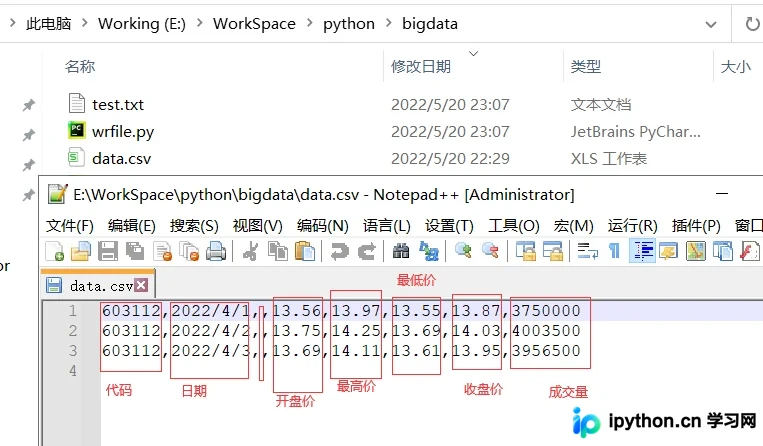
本文以历史股价分析为例,详细讲解NumPy核心函数。涵盖loadtxt与savetxt的文件读写、usecols参数筛选、average加权与算术平均、diff计算收益率、log对数收益及波动率公式。通过实战代码演示日期处理、where筛选、std标准差及极值统计,帮助掌握NumPy在金融数据分析中的关键应用。
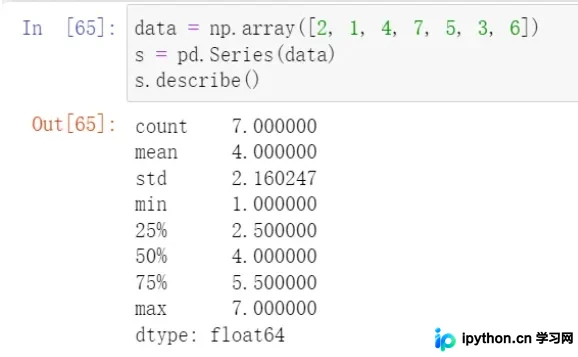
本文详细介绍Python数据分析库Pandas中Series对象的核心用法。涵盖从列表、字典及NumPy数组创建Series的方法,解析index与values等常用属性。深入讲解元素获取、修改、删除及切片操作,并演示head、tail、排序、去空等常用函数。最后通过describe统计与四则运算示例,展示Series在数据清洗与分析中的实际应用。
本文详细介绍在Python数据分析中,如何利用Pandas库对DataFrame高效应用自定义函数。重点解析apply方法按行或列处理数据、applymap方法逐元素处理数据,以及map方法在Series中的应用,通过具体代码示例展示如何替代低效的for循环,提升数据处理效率。
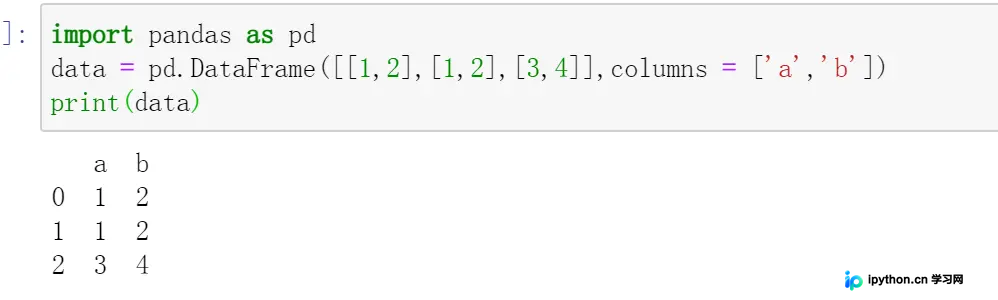
本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。
本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。
本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
本文详细介绍如何使用Python的Pandas库对CSV文件进行创建、读取和修改操作。通过具体代码示例,演示如何从Numpy数组生成DataFrame并保存为CSV,以及如何读取CSV文件并转换为数组。此外,还涵盖了列与行的增删改操作及索引重置,帮助开发者高效处理结构化数据。
本文总结了6个常用的Pandas数据处理技巧,帮助开发者高效处理数据。内容涵盖快速定位含缺失值的行、根据条件替换列值、使用pd.cut进行数据分箱统计、利用split拆分文本列、通过正则表达式筛选中文字段,以及调整列顺序的两种方法。掌握这些代码片段能显著提升数据清洗与处理的效率。
本文介绍在Pandas DataFrame计算中产生inf(无穷大)值的原因及处理方法。通过Numpy库提供的isinf、isposinf等函数定位inf位置,并演示如何将Series或整个DataFrame中的正负无穷大替换为指定数值或NaN,以适配机器学习算法对数据完整性的要求。
本文介绍如何使用R语言及ggplot2包绘制高质量的主成分分析(PCA)图。通过iris数据集演示,涵盖数据准备、基础散点图绘制、类别着色及置信椭圆计算技巧(如inherit.aes参数处理),并包含轴标签百分比显示及自定义配色等样式微调方法。