

Python Pandas处理DataFrame重复值的完整指南

本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。
Python处理DataFrame重复值概述
前言:
在进行数据分析工作时,数据录入环节产生的重复值、缺失值及异常值往往是令人头疼的问题。Python提供了多种有效工具来处理这些数据异常。接下来,我们将逐一学习这些处理方法。
使用duplicated()识别重复数据
首先处理重复值。我们需要创建一个包含重复数据的DataFrame对象,示例如下:
import pandas as pd
data = pd.DataFrame([[1,2],[1,2],[3,4]],columns = ['a','b'])
print(data)
打印该数据后,结果显示如下:
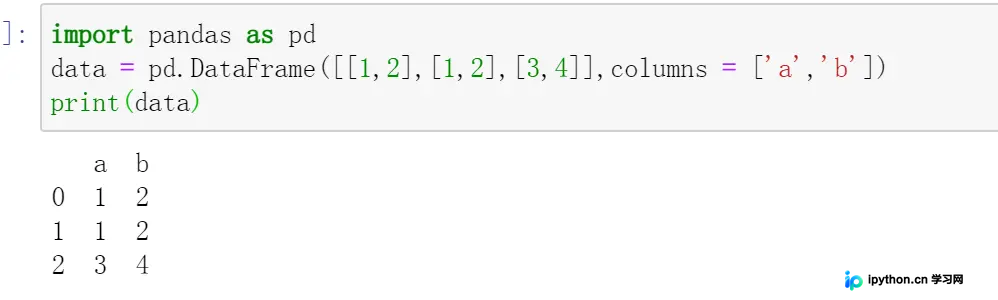
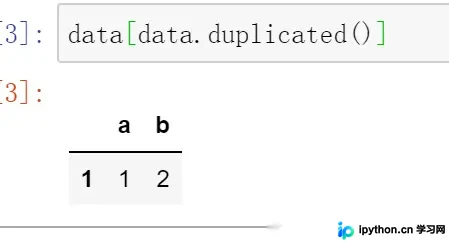
从输出结果可见,第一行和第二行数据完全相同。当数据量较小时,可以通过肉眼直接观察识别;但若数据规模较大,则需借助duplicated()函数进行自动查询。我们使用该函数来检查上述data中的重复项。
data[data.duplicated()]结果显示,索引为1的行被标记为重复。如果存在多行完全相同的情况,例如三行数据一致,我们继续通过示例进行验证。
import pandas as pd
data = pd.DataFrame([[1,2],[1,2],[1,2],[3,4]],columns = ['a','b'])
data[data.duplicated()]
运行结果如下:
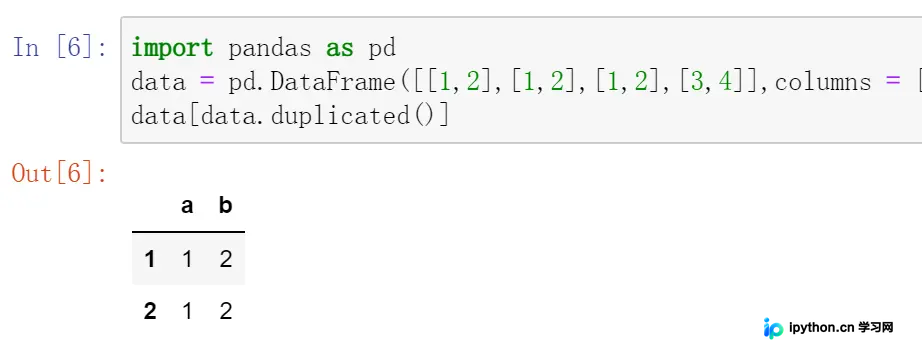
可以看出,duplicated()函数会标记出除首次出现之外的所有重复行。
统计重复行数量
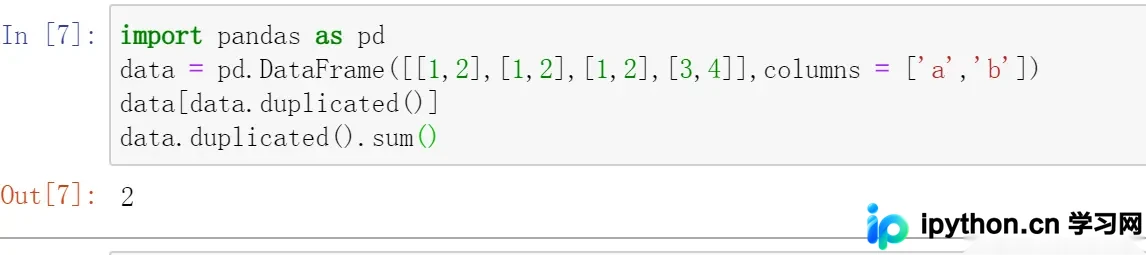
若需统计重复行的总数量,可以结合sum()函数实现,具体代码如下:
data.duplicated().sum()
使用drop_duplicates()删除重复数据
在实际应用中,删除重复数据是常见需求。此时可使用drop_duplicates()函数。我们尝试对data执行去重操作。
data.drop_duplicated()初次执行代码时出现报错,原因是函数名拼写错误,正确名称应为duplicates而非duplicated(注:实际正确函数名为drop_duplicates,此处原文笔误为duplicates,修正后应为drop_duplicates)。
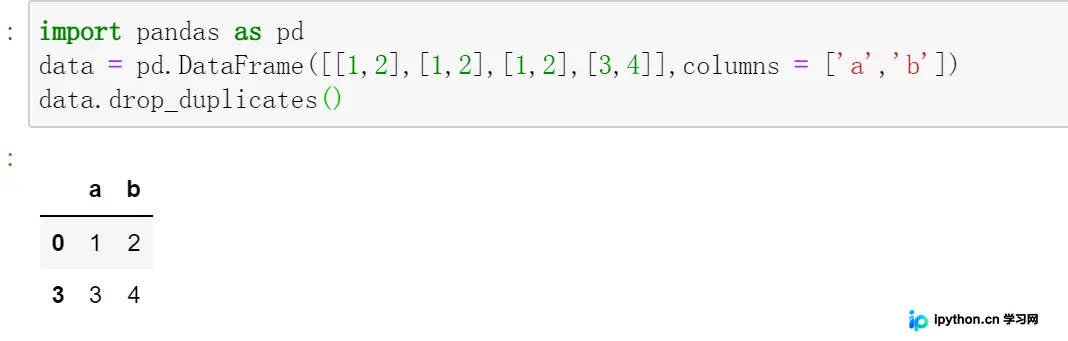
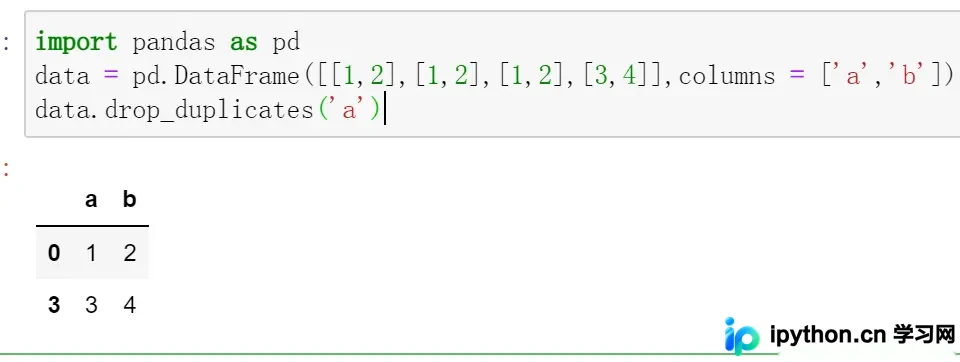
需要注意的是,直接调用drop_duplicates()并不会修改原data对象的结构,若需保存去重后的结果,必须将返回值重新赋值给变量。此外,若仅需删除特定列的重复值,可在函数括号内指定相应的列名。
具体操作示例如下:
关于Python中处理重复值的方法介绍至此。如需了解更多Python相关数据操作技巧,请查阅本站往期文章或继续浏览后续内容,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









