

Python数据分析之NumPy常用函数使用详解

本文以历史股价分析为例,详细讲解NumPy核心函数。涵盖loadtxt与savetxt的文件读写、usecols参数筛选、average加权与算术平均、diff计算收益率、log对数收益及波动率公式。通过实战代码演示日期处理、where筛选、std标准差及极值统计,帮助掌握NumPy在金融数据分析中的关键应用。
本文将通过历史股价分析案例,演示如何从文件加载数据,并深入讲解NumPy的基础数学与统计分析函数。内容涵盖文件读写技巧、函数式编程应用以及线性代数运算,旨在全面介绍NumPy的常用功能。
文件读入
文件读写是数据分析领域的一项基础且关键的技能。
CSV(Comma-Separated Value,逗号分隔值)是一种广泛使用的文件格式。通常,数据库的转存文件采用CSV格式,其中的各个字段直接对应数据库表中的列。
NumPy提供的loadtxt函数能够便捷地读取CSV文件,它会自动分割字段并将数据加载到NumPy数组中。
1、保存或创建新文件
import numpy as np

i = np.eye(3) #eye(n)函数创建n维单位矩阵
print(i)
np.savetxt('test.txt', i) #savetxt()创建并保存test.txt文件
使用savetxt()函数,若目标文件已存在则进行更新;若目录中不存在该文件,则创建并保存为test.txt。
运行结果如下:
[[1. 0. 0.] [0. 1. 0.] [0. 0. 1.]]
2、读取csv文件的函数loadtxt
1)首先,在保存程序的目录下创建一个名为data.csv的文件,并设置数据如下图所示:
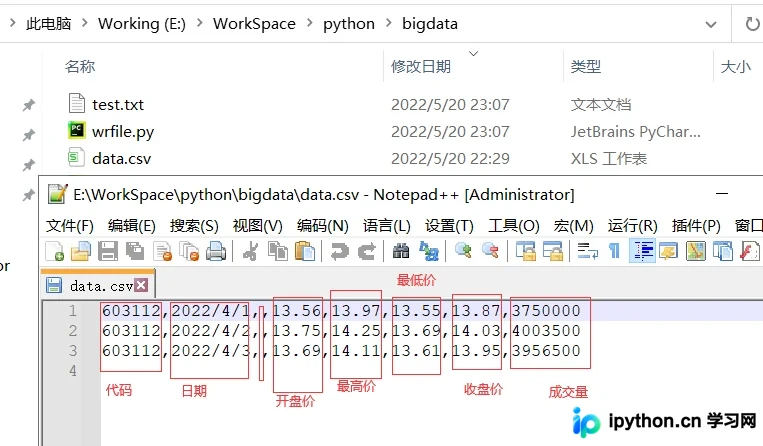
2)读取文件,代码如下:
c,v=np.loadtxt('data.csv', delimiter=',', usecols=(6,7), unpack=True)usecols参数接收一个元组,用于指定获取第7至第8字段的数据,即上述文件中的股票收盘价和成交量。将unpack参数设置为True,可实现分拆存储不同列的数据,即将收盘价和成交量的数组分别赋值给变量c和v。
3、常见的函数
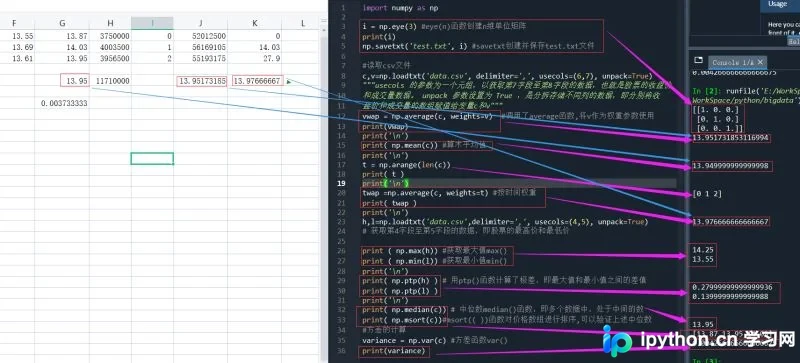
包括成交量加权平均、时间加权、算术平均值、中位数、方差等统计量。
import numpy as np

i = np.eye(3) #eye(n)函数创建n维单位矩阵
print(i)
np.savetxt('test.txt', i) #savetxt创建并保存test.txt文件

#读取csv文件
c,v=np.loadtxt('data.csv', delimiter=',', usecols=(6,7), unpack=True)
"""usecols 的参数为一个元组,以获取第7字段至第8字段的数据,也就是股票的收盘价和成交量数据。 unpack 参数设置为 True ,是分拆存储不同列的数据,即分别将收
盘价和成交量的数组赋值给变量c和v"""
vwap = np.average(c, weights=v)  #调用了average函数,将v作为权重参数使用,
print(vwap)
print('\n')
print( np.mean(c)) #算术平均值
print('\n')
t = np.arange(len(c))
print( t )
print('\n')
twap =np.average(c, weights=t) #按时间权重
print( twap )
print('\n')
h,l=np.loadtxt('data.csv',delimiter=',', usecols=(4,5), unpack=True)
# 获取第4字段至第5字段的数据,即股票的最高价和最低价

print ( np.max(h)) #获取最大值max()
print ( np.min(l)) #获取最小值min()
print('\n')
print( np.ptp(h) ) # 用ptp()函数计算了极差,即最大值和最小值之间的差值
print( np.ptp(l) )
print('\n')
print( np.median(c)) # 中位数median()函数,即多个数据中,处于中间的数
print( np.msort(c))#msort(( ))函数对价格数组进行排序,可以验证上述中位数
#方差的计算
variance = np.var(c) #方差函数var()
print(variance)
通过代码与Excel进行相关计算,运行结果如下:
为了后续计算,在data.csv中增加几行数据,修改并保存(为后续日期读写与修改,日期格式修改如下):
603112,2022-4-1,,13.56,13.97,13.55,13.87,3750000603112,2022-4-2,,13.75,14.25,13.69,14.03,4003500603112,2022-4-3,,13.69,14.11,13.61,13.95,3956500603112,2022-4-4,,14.3,14.3,13.73,13.89,4250000603112,2022-4-5,,14.1,14.5,13.93,14,4013500603112,2022-4-6,,14.5,15.4,14.35,15.4,9056500603112,2022-4-7,,16,16.94,15.85,16.94,37500004、股票的收益率等
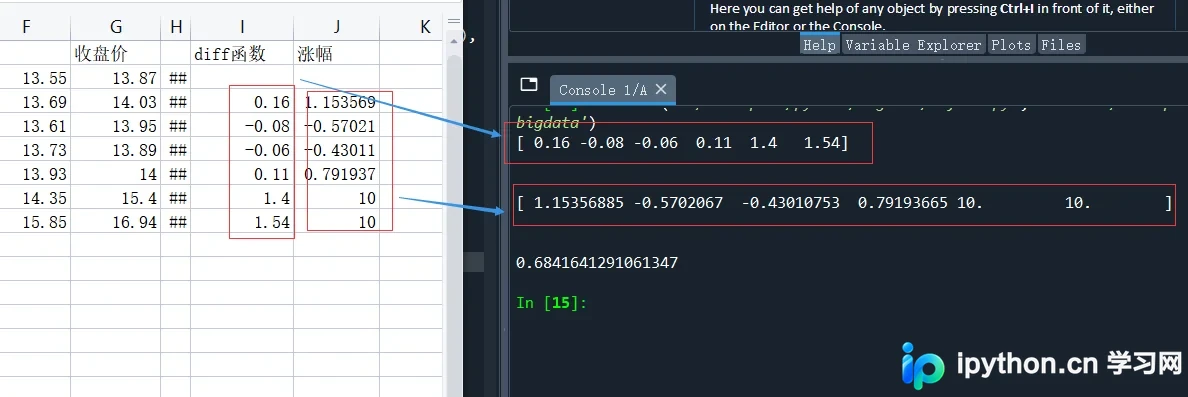
股市中最常见的指标是涨幅,即今日收盘价相对昨日的涨跌比例,计算公式为(今日收盘价-昨天收盘价)/昨日收盘价*100。NumPy中的diff()函数可返回由相邻数组元素差值构成的数组。由于相邻数据相减,diff()生成的数组比原数组少一个元素。
如上述修改后,若有7天的收盘价,diff()计算出的结果将只有6个数值。
import numpy as np

#读取csv文件
c,v=np.loadtxt('data.csv', delimiter=',', usecols=(6,7), unpack=True)

#股票的简单收益率
# diff 函数可以返回一个由相邻数组元素的差值构成的数组
results = np.diff(c)
print(results)
print('\n')
results1 = np.diff(c)/c[:-1]*100  #相对前一天的涨幅
print(results1)
print('\n')
Standard_deviation =np.std(results) # 计算出标准差
print(Standard_deviation)
运行结果,代码与Excel进行相比较:
5、对数收益与波动率
1)对数收益:利用log函数获取每个收盘价的对数值,再对结果使用diff函数即可。
logreturns = np.diff( np.log(c) )
print(logreturns)
运行结果:
[ 0.01146966 -0.00571839 -0.00431035 0.00788817 0.09531018 0.09531018]
2) where的作用
where函数可根据指定条件返回所有满足条件的序列索引值。例如,上述logreturns中有两个小于0的数据。
posretindices = np.where(results1 > 0)
print('Indices with positive returns1',posretindices)
运行结果:
Indices with positive returns1 (array([0, 3, 4, 5], dtype=int64),)
3)波动率:波动率等于对数收益率的标准差除以其均值,再除以交易周期倒数的平方根。以下代码分别展示以年和月为统计周期的波动率计算。
annual_volatility =(np.std(logreturns)/np.mean(logreturns))/np.sqrt(1./252.)#使用浮点数才能得到正确的结果
print ( annual_volatility )
#月波动率
month_volatility =(np.std(logreturns)/np.mean(logreturns))/np.sqrt(1./12.)
print ( month_volatility )
6、日期分析
处理日期通常较为繁琐。由于NumPy主要针对浮点数运算,因此需要对日期进行专门处理。
通过上述代码可知,修改np.loadtxt('data.csv', delimiter=',', usecols=(6,7), unpack=True)中的usecols参数即可读取不同列。日期位于第2列,即下标应为1(数列下标从0开始),可重新定义新日期数列并获取后存入。
代码如下:
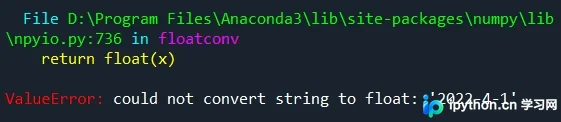
dates, c=np.loadtxt('data.csv', delimiter=',', usecols=(1,6), unpack=True) #读取下标为1、6的数据,分别存入到dates和c数列中。但实际运行过程中会报错。
代码需要作如下修改:
import numpy as np
from datetime import datetime

def datestr2num(s): #定义一个函数
    return datetime.strptime(s.decode('ascii'),"%Y-%m-%d").date().weekday()
#decode('ascii') 将字符串s转化为ascii码

#读取csv文件
dates,close=np.loadtxt('data.csv',delimiter=',', usecols=(1,6),converters={1:datestr2num},unpack=True)
print(dates)
运行结果:[4. 5. 6. 0. 1. 2. 3.],也是从0开始,到6结束。为了更好地说明数据,可采用真实数据,即从通信达软件直接下载真实的交易数据,如下图所示:
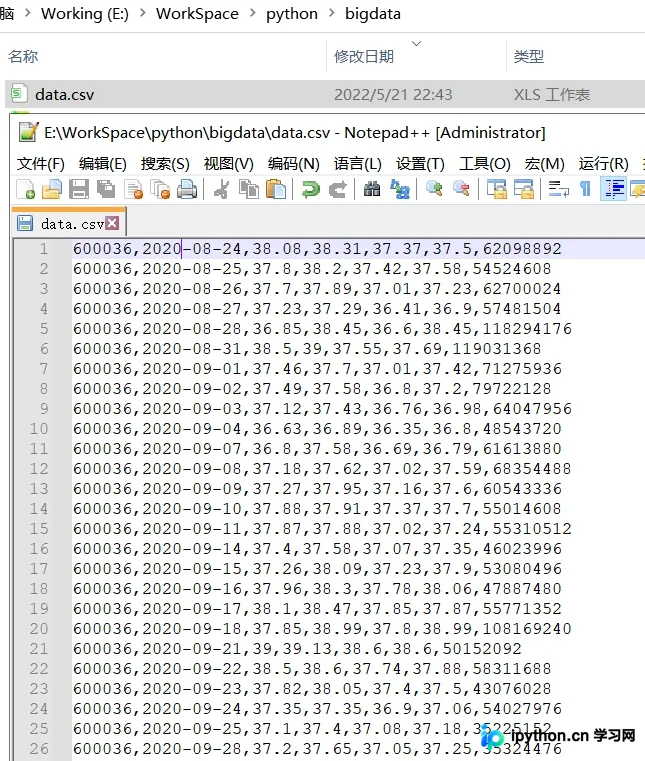
(注意:较原来少了一列空格列)
修改代码如下:
import numpy as np
from datetime import datetime

def datestr2num(s): #定义一个函数
    return datetime.strptime(s.decode('ascii'),"%Y-%m-%d").date().weekday()
#decode('ascii') 将字符串s转化为ascii码

#读取csv文件
dates,c=np.loadtxt('data.csv',delimiter=',', usecols=(1,5),
                       converters={1:datestr2num},unpack=True)
print(dates)

print(len(dates)) #统计导出的天数
运行结果:
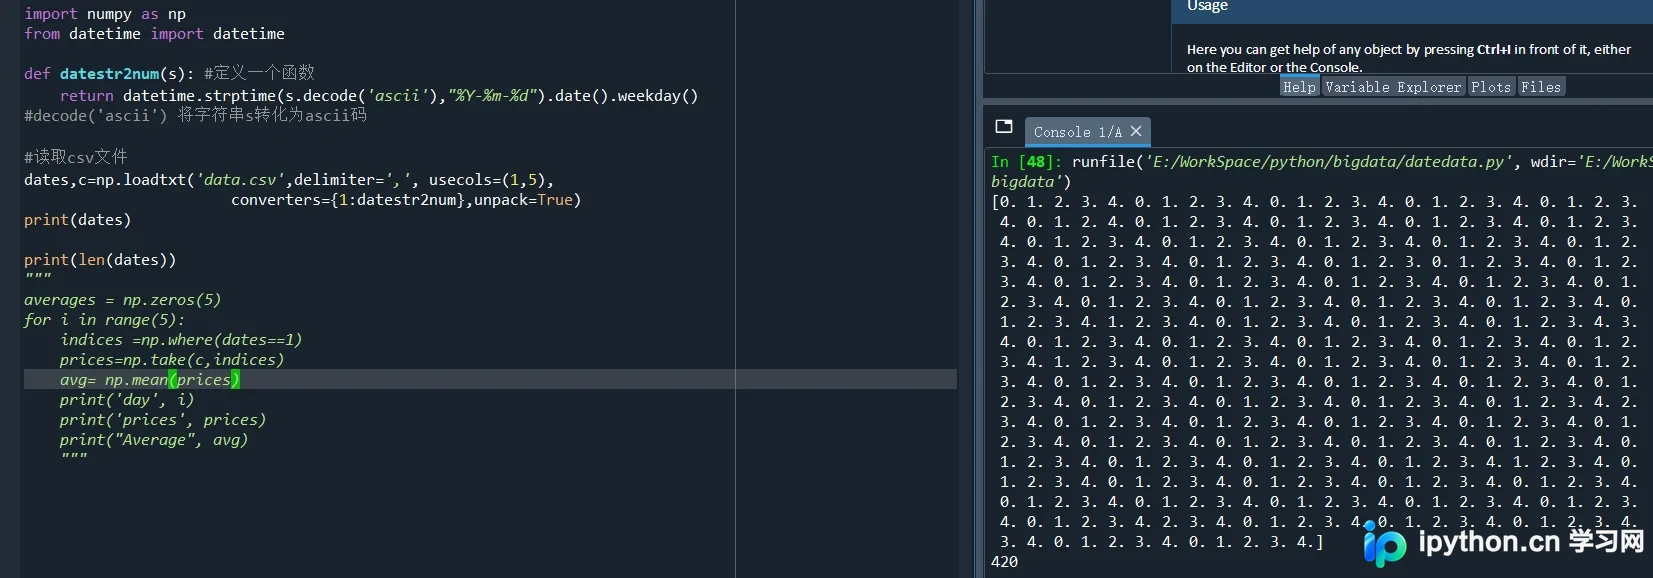
如上图,导出有420天数据。
按周一到周五,统计相关数据:
averages = np.zeros(5) #创建包含5个元素的数组,保存交易日收盘价,0-4分别代表周一到周五五个交易日
for i in range(5):  #遍历0到4的日期标识
    indices =np.where(dates==i)   #where函数得到各工作日的索引值并存储在 indices 数组
    prices=np.take(c,indices)   #take函数获取各个工作日的收盘价。
    avg= np.mean(prices) #每个工作日计算出平均值存放在 averages 数组
    averages[i] = avg  #每个工作日计算出平均值存放在 averages 数组
    print('day', i)
    #print('prices', prices)
    print("Average", avg)

print(averages)
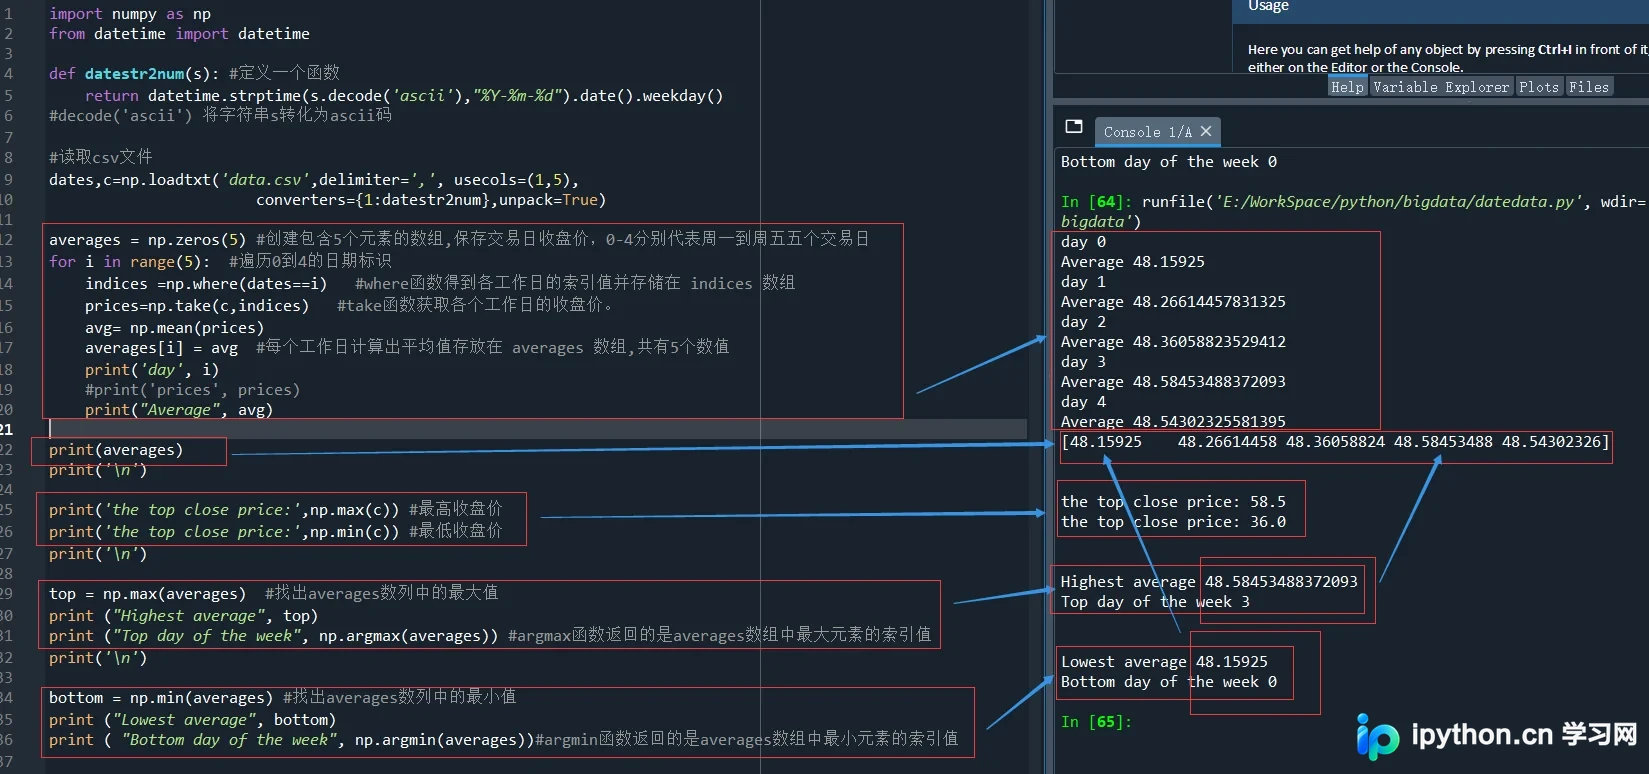
当然除了上述外,还可以求得420天里的最大值、最小值以及交易日平均值中最大值、最小值等,对代码进行如下修改:
import numpy as np
from datetime import datetime

def datestr2num(s): #定义一个函数
    return datetime.strptime(s.decode('ascii'),"%Y-%m-%d").date().weekday()
#decode('ascii') 将字符串s转化为ascii码

#读取csv文件
dates,c=np.loadtxt('data.csv',delimiter=',', usecols=(1,5),
                       converters={1:datestr2num},unpack=True)

averages = np.zeros(5) #创建包含5个元素的数组,保存交易日收盘价,0-4分别代表周一到周五五个交易日
for i in range(5):  #遍历0到4的日期标识
    indices =np.where(dates==i)   #where函数得到各工作日的索引值并存储在 indices 数组
    prices=np.take(c,indices)   #take函数获取各个工作日的收盘价。
    avg= np.mean(prices)
    averages[i] = avg  #每个工作日计算出平均值存放在 averages 数组,共有5个数值
    print('day', i)
    #print('prices', prices)
    print("Average", avg)

print(averages)
print('\n')

print('the top close price:',np.max(c)) #最高收盘价
print('the low close price:',np.min(c)) #最低收盘价
print('\n')

top = np.max(averages)  #找出averages数列中的最大值
print ("Highest average", top)
print ("Top day of the week", np.argmax(averages)) #argmax函数返回的是averages数组中最大元素的索引值
print('\n')

bottom = np.min(averages) #找出averages数列中的最小值
print ("Lowest average", bottom)
print ( "Bottom day of the week", np.argmin(averages))#argmin函数返回的是averages数组中最小元素的索引值
运行结果如下:
总结
本文初步导入了真实的股票交易信息,并利用NumPy常见函数进行了初步计算,列举了下列常用函数:
loadtxt()函数可以方便地读取CSV文件,自动切分字段,并将数据载入NumPy数组。
savetxt()创建并保存test.txt文件
np.loadtxt('data.csv', delimiter=',', usecols=(6,7),)usecols参数用来选择读取的数列
np.average(c, weights=v)加权平均,将v作为权重参数使用。
np.mean(c)) #算术平均值
np.max(h)) #获取最大值max()
np.min(l)) #获取最小值min()
np.ptp(h) )用ptp()函数计算了极值差。
np.median(c))中位数median()函数,即多个数据中,处于中间的数
np.msort(c))函数对价格数组进行排序。
np.var(c)方差函数var()
np.diff(c)函数可以返回一个由相邻数组元素的差值构成的数组
np.std(results) #标准差
np.diff( np.log(c) )
np.where(results1 > 0)选择
np.sqrt()#平方根sqrt(),浮点数
s.decode('ascii')将字符串s转化为ascii码
np.take(c,indices) #take函数获取各个工作日的收盘价。
np.argmax(averages)) #argmax函数返回数组中最大元素的索引值
np.argmin(averages))#argmin函数返回数组中最小元素的索引值
以上就是Python数据分析之NumPy常用函数使用详解的详细内容,更多关于Python NumPy常用函数的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









